 Vastrik
Artículo revisado y actualizado en 2021
Hoy, en la presentación de cualquier smartphone, siempre hay un rato dedicado a presumir de cámara. El Pixel hace fotos a oscuras, el Huawei tiene el zoom de unos binoculares, al Samsung le han metido ocho objetivos y en la pantalla del iPhone tus amigos parecen un 30 % más ricos.
Las réflex, en cambio, parecen correr sin moverse del sitio. Sony nos inunda cada año de sensores nuevos, mientras los fabricantes cambian sin mucho entusiasmo la última cifra del modelo y vuelven a esnifar coca tranquilamente en un rincón. Tengo una réflex de 3000 dólares sobre la mesa, pero cuando me voy de viaje cada vez me llevo más el iPhone. ¿Por qué?
Como dijo el clásico: con esa pregunta me metí en internet. Allí se habla de «algoritmos» y «redes neuronales» sin que nadie explique qué le hacen exactamente a una foto. Los periodistas alaban los megapíxeles, los blogueros graban unboxings a coro y los estetas se revuelcan en la «percepción sensual de la paleta cromática del sensor». Lo de siempre.
Me tocó sentarme, dedicarle media vida y averiguarlo por mi cuenta. En este artículo te cuento lo que aprendí.
Me ayudó a escribirlo Gueorgui Dzhedzheya, cuya versión puedes leer en su blog. Él lo mira con ojos de fotógrafo; yo, más bien, con ojos de técnico.
Empecemos. Pero antes, un minutito de capitalismo.
En todas partes, incluida la Wikipedia, dan más o menos esta definición: la fotografía computacional abarca cualquier técnica de captura y procesamiento de imágenes que utilice cálculos digitales en lugar de transformaciones ópticas.
La definición está muy bien, salvo por el detalle de que es horrible. Ahí cabe hasta el enfoque automático, pero no la plenóptica, que ya nos ha dado bastantes alegrías. Lo borroso de las definiciones oficiales da a entender que no tenemos ni idea de qué estamos hablando.
Marc Levoy, pionero de la fotografía computacional y profesor de Stanford (también es quien se encarga ahora de la cámara del Google Pixel), propone otra definición: un conjunto de técnicas de imagen computacional que mejoran o amplían las posibilidades de la fotografía digital y cuyo resultado es una foto normal, pero que, por limitaciones técnicas, esa misma cámara no habría podido tomar de la manera tradicional. Con esa me quedo para el artículo.
En fin, la culpa de todo la tuvieron los smartphones.
A los smartphones no les quedó más remedio que dar vida a una nueva clase de fotografía: la computacional
Con esos sensores pequeños y ruidosos y esos objetivos diminutos y poco luminosos, por todas las leyes de la física, solo podían traernos dolor y sufrimiento. Y así fue, hasta que a sus desarrolladores se les ocurrió aprovechar sus puntos fuertes para compensar los débiles: obturadores electrónicos rápidos, procesadores potentes y software.
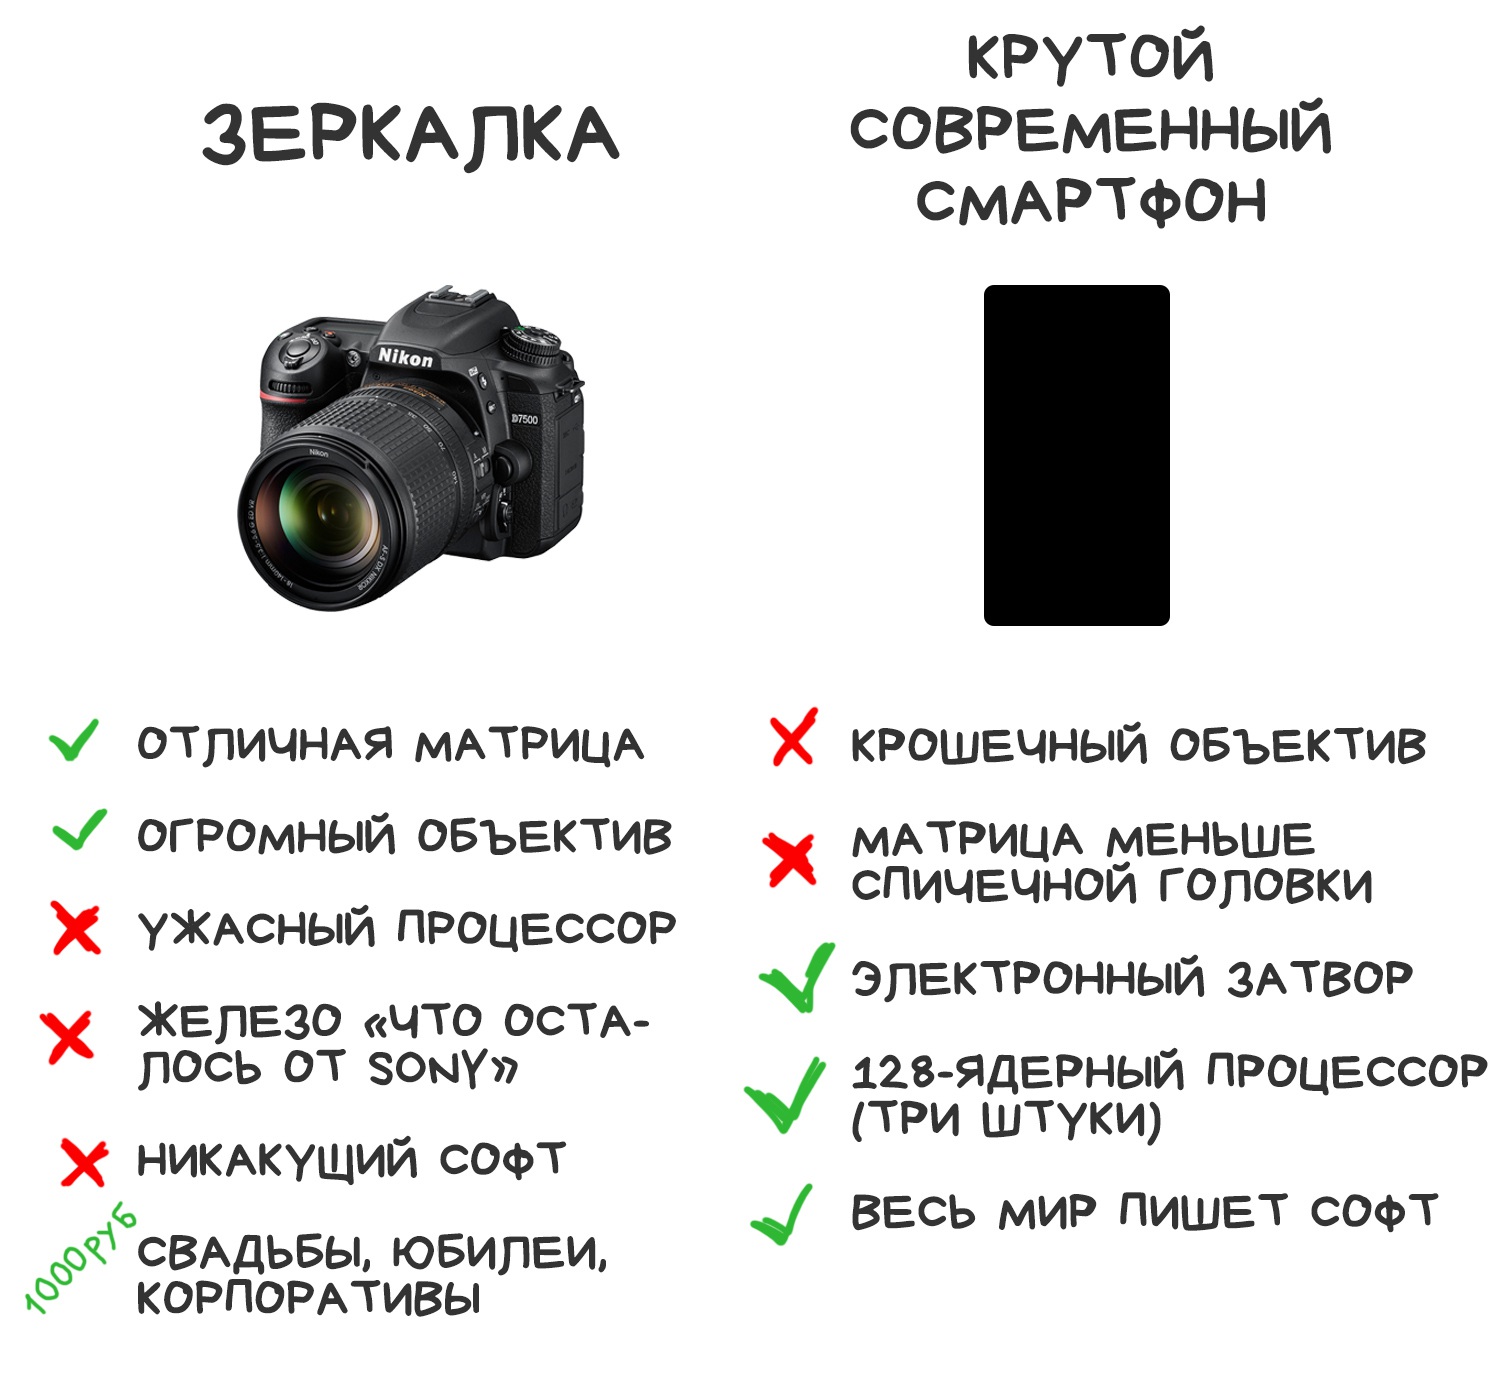
La mayoría de las investigaciones que dieron que hablar en fotografía computacional son de entre 2005 y 2015, que en ciencia es literalmente ayer. Ahora mismo, ante nuestros ojos y dentro de nuestros bolsillos, está creciendo todo un campo del conocimiento y de la tecnología que antes no existía.
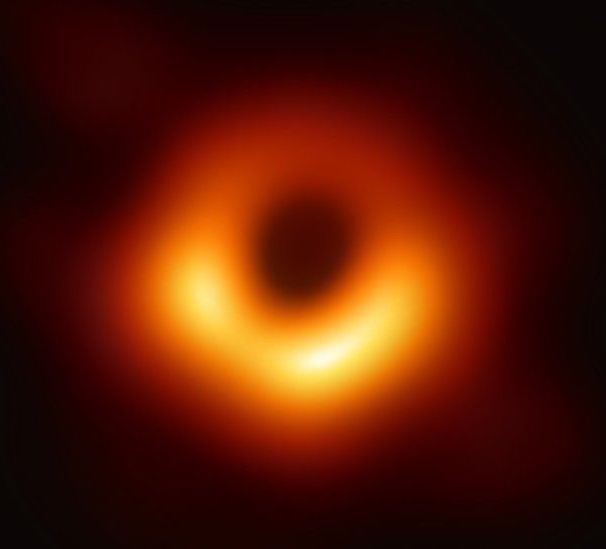
La fotografía computacional no se limita al modo selfi y las fotos nocturnas. Sin sus técnicas, la reciente fotografía de un agujero negro no habría visto la luz. Para tomarla con un telescopio convencional tendríamos que haber construido uno del tamaño de la Tierra. Pero combinando los datos de ocho radiotelescopios situados en distintos puntos de nuestra bolita y escribiendo unos cuantos scripts en Python, conseguimos la primera fotografía del horizonte de sucesos del mundo. Para selfis también sirve.
📝 Fotografía computacional: principios y práctica
📝 Marc Levoy: nuevas técnicas de fotografía computacional
↑↑↑ a lo largo del artículo iré dejando enlaces así de gordos. Llevan a artículos 📝 o vídeos 🎥 de esos que son auténticas joyas y cuesta encontrar. Sirven para profundizar y ver por dónde seguir si de pronto te pica la curiosidad de manera insoportable. Es que físicamente no me da para contarlo todo en un solo artículo
Imagina que hemos vuelto a 2007. Nuestra madre es la anarquía y nuestras fotos son JPEG ruidosos de 0,6 megapíxeles tomados con una patineta. Fue por entonces cuando nos entraron por primera vez unas ganas irresistibles de echarles ajustes preestablecidos por encima para disimular lo mierda que eran los sensores de los teléfonos. Y así nos obsesionamos con los filtros de Instagram.
Los filtros X-Pro II, Lo-Fi y Valencia ya son clásicos que llevamos en el corazón. En su día hasta les hice ingeniería inversa con fines de investigación, y todavía recuerdo que eran unos shaders (funciones) muy sencillos con tres componentes:
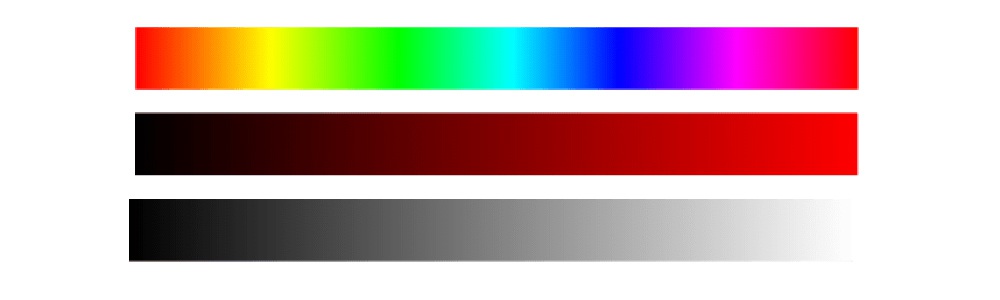

Los filtros actuales no se han alejado mucho de ese trío; solo se han complicado un poco las matemáticas. Cuando llegaron a los teléfonos los shaders por hardware y OpenCL, enseguida los reescribieron para la GPU, y aquello nos pareció una pasada. Para ser 2012, claro. Hoy cualquier estudiante puede hacer lo mismo hasta con CSS y seguirá sin comerse nada en la fiesta de graduación.
Eso sí, los filtros siguen evolucionando. A los chicos de Dehancer, por ejemplo, les ha dado fuerte por los filtros no lineales: en lugar del proletario mapeo de tonos, utilizan transformaciones no lineales más complejas que, según ellos, abren muchas más posibilidades.
Con las transformaciones no lineales se pueden hacer virguerías, pero son increíblemente complicadas y nosotros, los humanos, somos increíblemente tontos. En cuanto en ciencia llegamos a las transformaciones no lineales, preferimos recurrir a métodos numéricos y meter redes neuronales por todas partes para que ellas creen las obras maestras por nosotros. Aquí pasó lo mismo.
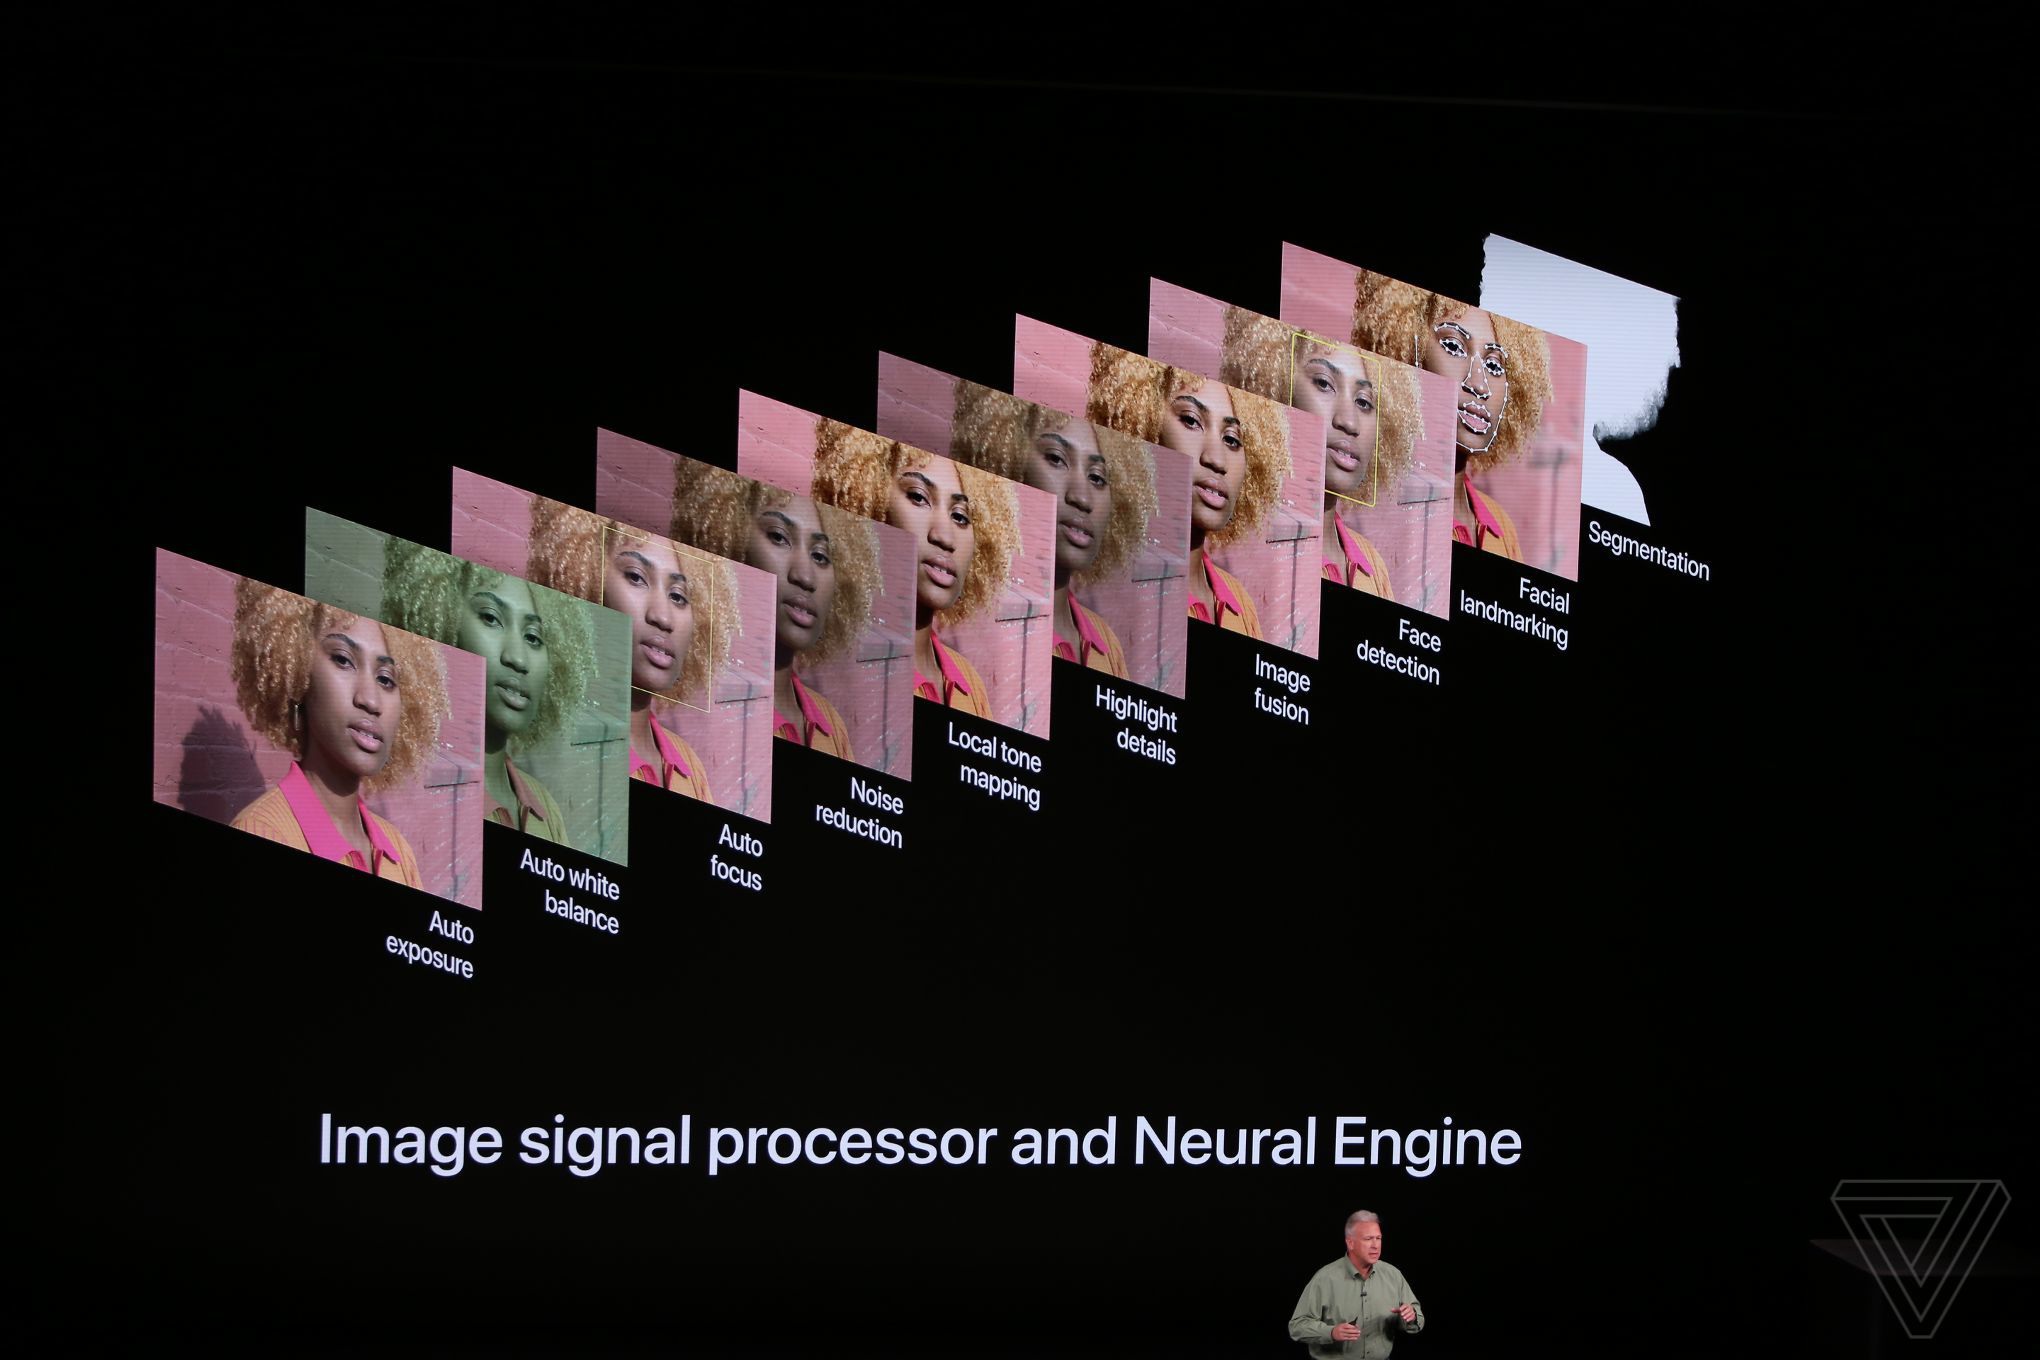
Cuando nos acostumbramos a los filtros, empezamos a incorporarlos directamente a las cámaras. Hace ya mucho que los teléfonos le dan un «repasito» a la imagen sin decirnos nada.
La historia no cuenta qué fabricante fue el primero, pero para que te hagas una idea de cuánto tiempo hace: iOS 5.0, que salió allá por 2011, ya tenía una API pública para mejorar imágenes automáticamente. Solo Jobs sabe cuánto tiempo llevaban usándola antes de hacerla pública.
El automatismo hacía más o menos lo mismo que el botón de mejora automática de un editor de fotos: recuperaba detalle en luces y sombras, subía la saturación a lo grande, quitaba los ojos rojos y corregía el tono de piel. Los usuarios ni sospechaban que la «mejora espectacular de la cámara» de su nuevo teléfono era cosa de un par de shaders nuevos.
Todavía faltaban cinco años para el primer Google Pixel y el furor por la fotografía computacional.
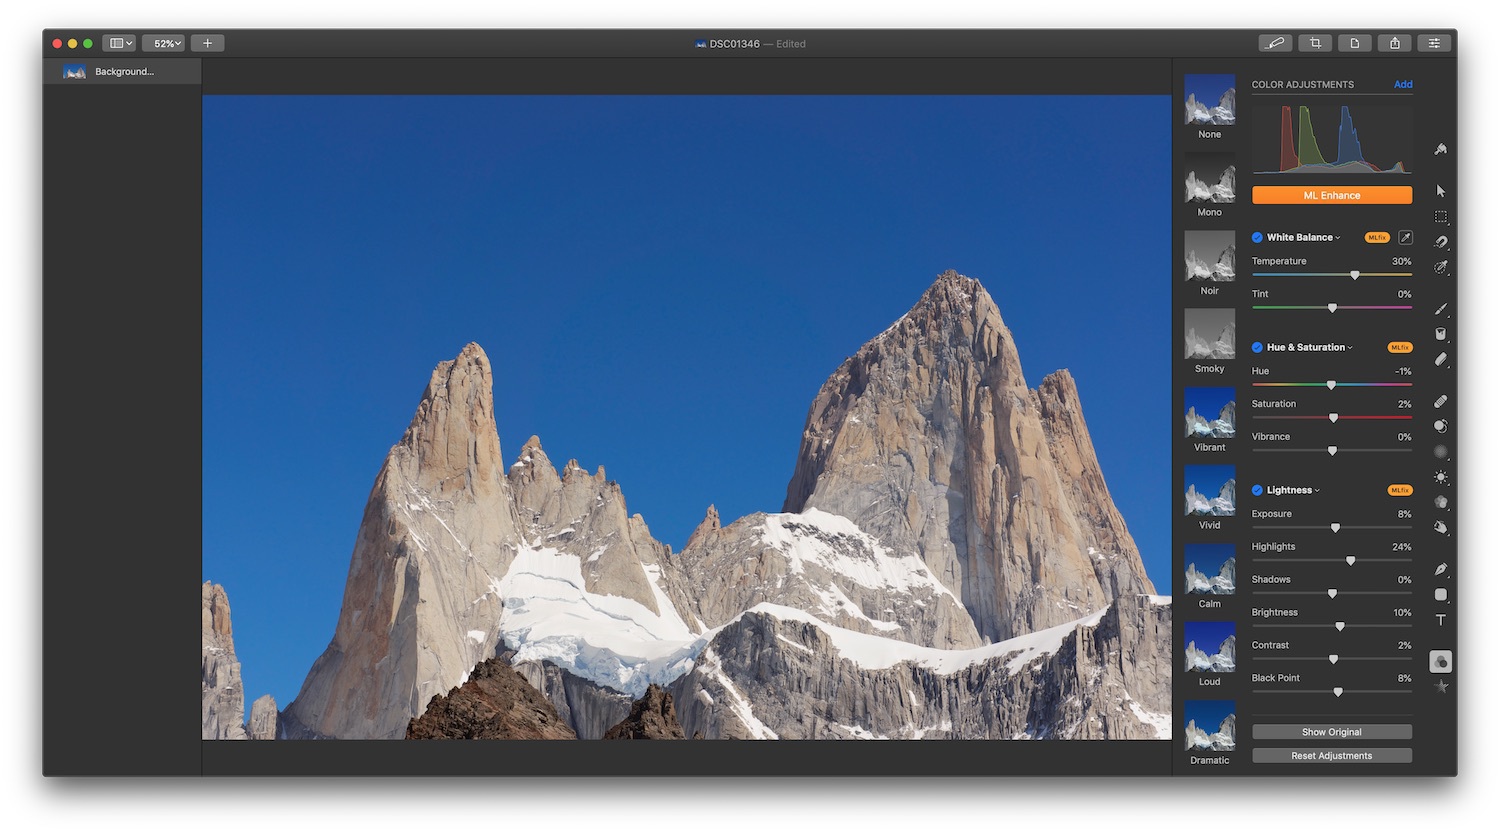
Hoy la batalla por el botón «obra maestra» se libra en el terreno del aprendizaje automático. Cuando nos cansamos de jugar con el mapeo de tonos, salimos todos corriendo a entrenar redes CNN y GAN para que las máquinas movieran los controles deslizantes por nosotros. Se entrenaba a la red para que encontrara los parámetros óptimos para cada imagen y así acercara el resultado a cierta idea subjetiva de «buena fotografía»: la del desarrollador.
Pixelmator Pro y otros editores modernos llevan tiempo ofreciendo esa mejora con redes neuronales. Funciona, como te podrás imaginar, mal y no siempre. En los enlaces de abajo puedes leer los artículos, descargarte los conjuntos de datos y probar a entrenar una red por tu cuenta.
📝 Artículos sobre mejora de imágenes
📝 Fotos con calidad de réflex en dispositivos móviles mediante redes convolucionales profundas
La fotografía computacional de verdad empezó con el apilado: superponer varias fotos. Para un smartphone, sacar diez fotos en medio segundo no suponía ningún problema. En su cámara no hay piezas mecánicas lentas: la apertura es fija y, en lugar de una cortinilla de obturador, es el propio sensor el que controla la exposición. El procesador se limita a decirle al sensor cuántos microsegundos tiene que pasarse recogiendo fotones y luego lee el resultado.
Técnicamente, un teléfono puede tomar fotos a la velocidad a la que graba vídeo y grabar vídeo a la resolución a la que toma fotos, con lo que nos saldría una salvajada de vídeo en 12K. En la práctica mandan la velocidad del bus y la del procesador. Por eso siempre se ponen límites por software; si no, sale carísimo.
El apilado en sí se inventó hace tiempo. Ya nuestros abuelos instalaban complementos en Photoshop 7.0 para combinar varias fotos en un HDR de esos que te arrancaban los ojos, o armar una panorámica de 18 000 × 600 píxeles y… a nadie se le ocurrió jamás qué hacer después con semejante horror. Qué tiempos tan prósperos. Lástima que fueran tan salvajes.
📝 dmitry_novak: tipos de apilado. Cómo reducir el ruido mediante apilado en Photoshop
Ahora que somos mayores lo llamamos «fotografía épsilon»: variamos un parámetro de la cámara (exposición, enfoque o posición), juntamos las tomas y obtenemos algo imposible de capturar en una sola foto. Pero ese es el término de los teóricos; el que se ha impuesto en la práctica es apilado. Hoy es la base de la mayoría de las innovaciones en cámaras de teléfonos.
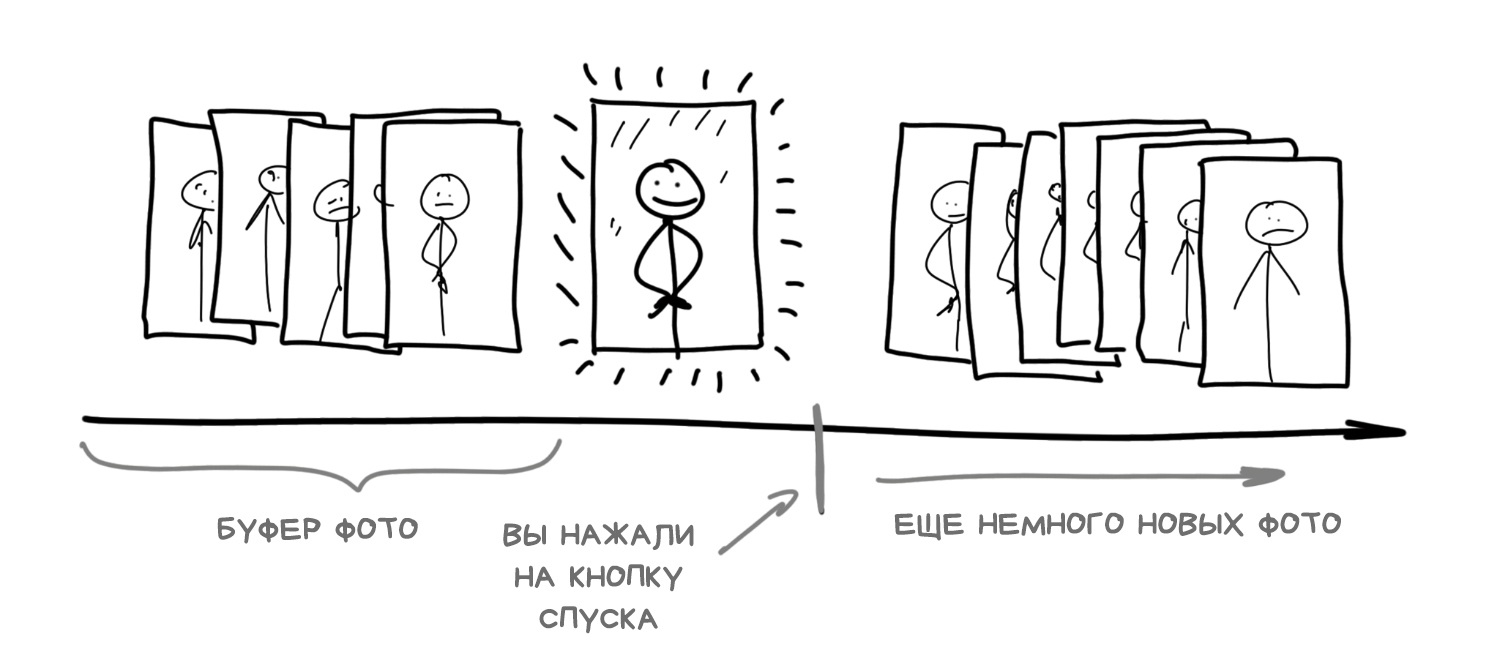
Algo en lo que mucha gente no piensa, pero que es clave para entender toda la fotografía móvil y computacional: la cámara de un smartphone moderno empieza a tomar fotos en cuanto abres la aplicación. Es lógico, de algún sitio tiene que sacar la imagen que ves en pantalla. Pero además de mostrarla, va guardando fotogramas de alta resolución en su propio búfer circular, en segundo plano, y los conserva un par de segundos.
Cuando pulsas el botón de «tomar foto», la foto en realidad ya está tomada. La cámara se limita a sacar la última del búfer
Hoy funciona así cualquier cámara de teléfono. El búfer permite que el retardo del obturador no solo sea nulo, como llevaban tanto tiempo soñando los fotógrafos, sino incluso negativo: cuando pulsas el botón, el teléfono echa un vistazo al pasado, mira las últimas 10-15 fotos del búfer y se pone a pegarlas como loco. Ya no hace falta esperar a que dispare todas las tomas para el HDR o el modo nocturno: las sacas del búfer y el usuario ni se entera.
Precisamente ese retardo negativo es lo que hace posible la función Live Photo en los iPhone y sus equivalentes en otros teléfonos.
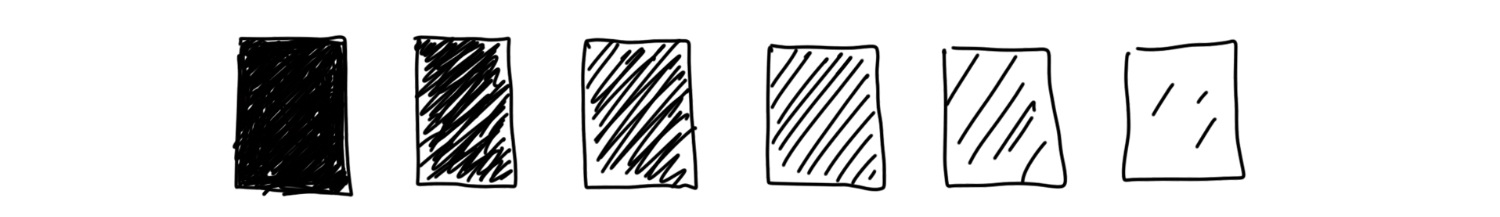
¿Pueden los sensores de las cámaras captar todo el rango de luminosidad que ve el ojo humano? Es un viejo tema de pelea en internet. Unos dicen que no, porque el ojo alcanza hasta 25 pasos de exposición, mientras que ni a una réflex de formato completo de primerísima línea se le pueden sacar más de 14 en el editor. Otros dicen que la comparación no vale: el cerebro ayuda al ojo ajustando la pupila automáticamente y completando la imagen con sus redes neuronales; en un instante dado, el rango dinámico del ojo en realidad no pasa de 10-14 pasos. Dejemos el debate en manos de los mejores filósofos de sofá de internet.
El caso es que si fotografías a tus amigos contra un cielo luminoso con cualquier teléfono y sin HDR, o te salen un cielo normal y las caras de tus amigos a oscuras, o te salen los amigos con todo detalle y el puto cielo totalmente quemado.
La solución se conoce desde hace tiempo: ampliar el rango de luminosidad con HDR (alto rango dinámico). Haces varias tomas con distintos tiempos de exposición y las combinas. Una «normal», otra más clara y otra más oscura. Sacas las sombras de la toma clara, rellenas las luces quemadas con la oscura y listo. Solo queda resolver el horquillado automático: cuánto variar la exposición entre tomas sin pasarse. Pero hoy hasta un estudiante de segundo de ingeniería sabe calcular la luminosidad media de una imagen.
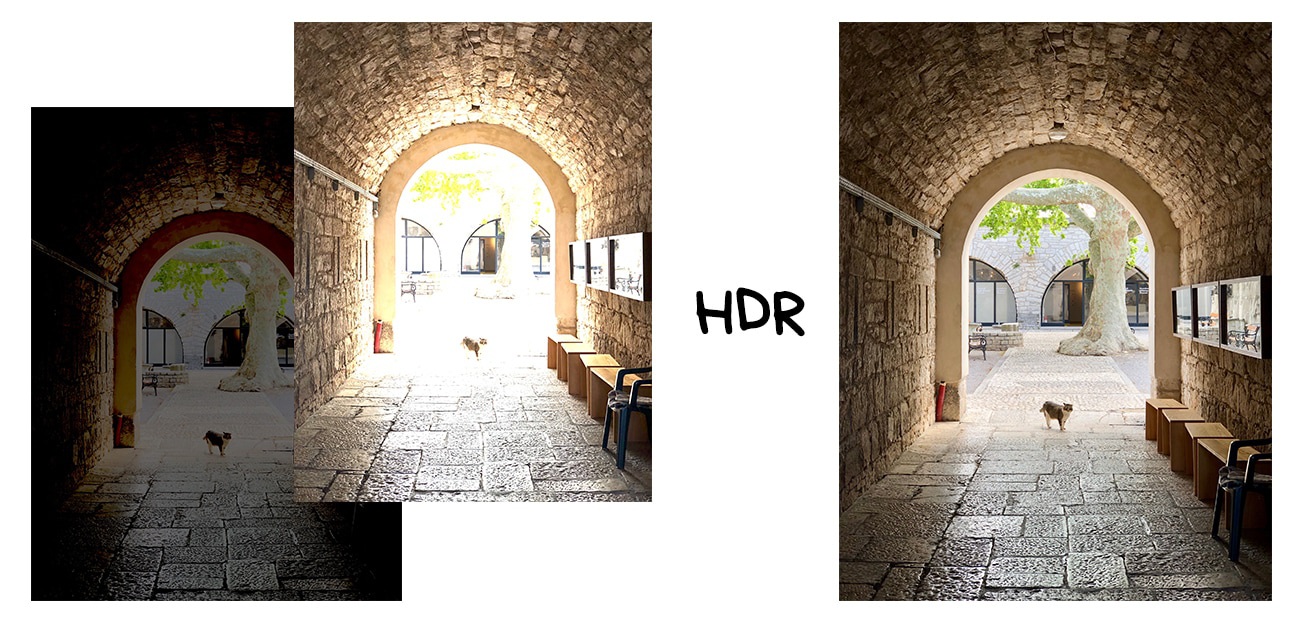
En los últimos iPhone, Pixel y Galaxy, el HDR incluso se activa solo cuando un algoritmo bastante sencillo detecta que estás fotografiando algo con mucho contraste en un día soleado. Hasta puedes notar cuándo el teléfono cambia la forma de grabar en el búfer para guardar tomas con distintas exposiciones: baja el número de fotogramas por segundo y la imagen en pantalla parece más viva que la realidad.
El cambio se ve bien al tomar fotos al aire libre. La próxima vez, fíjate en tu teléfono.
La pega del HDR con horquillado de exposición es que con poca luz se vuelve irremediablemente inútil. Hasta con la lámpara de casa encendida, las tomas salen tan oscuras que la compu no consigue alinearlas y juntarlas. Para resolver el problema de la luz, en 2013 Google presentó otra forma de hacer HDR en el Nexus que acababa de lanzar. Se llamaba HDR+ y usaba apilado temporal.
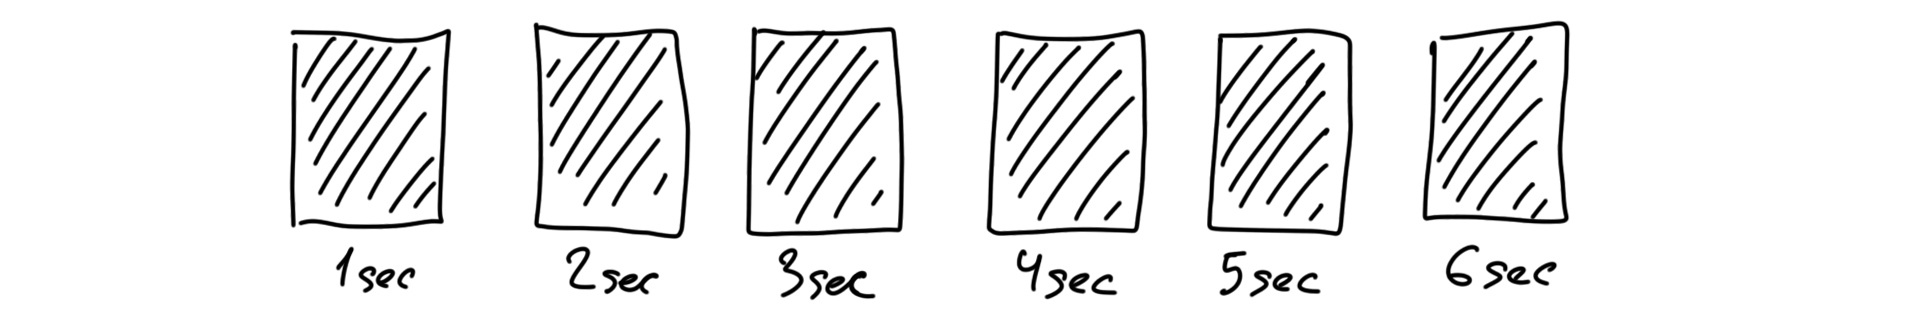
El apilado temporal permite conseguir una exposición larga con una serie de exposiciones cortas. Los pioneros fueron los aficionados a fotografiar rastros de estrellas en el cielo nocturno, a quienes no les venía nada bien dejar el obturador abierto dos horas seguidas. Era difícil acertar de antemano con todos los ajustes y el menor temblor arruinaba la foto entera. Así que decidieron abrir el obturador solo un par de minutos cada vez, repetirlo muchas veces y luego irse a casa a juntar las tomas en Photoshop.
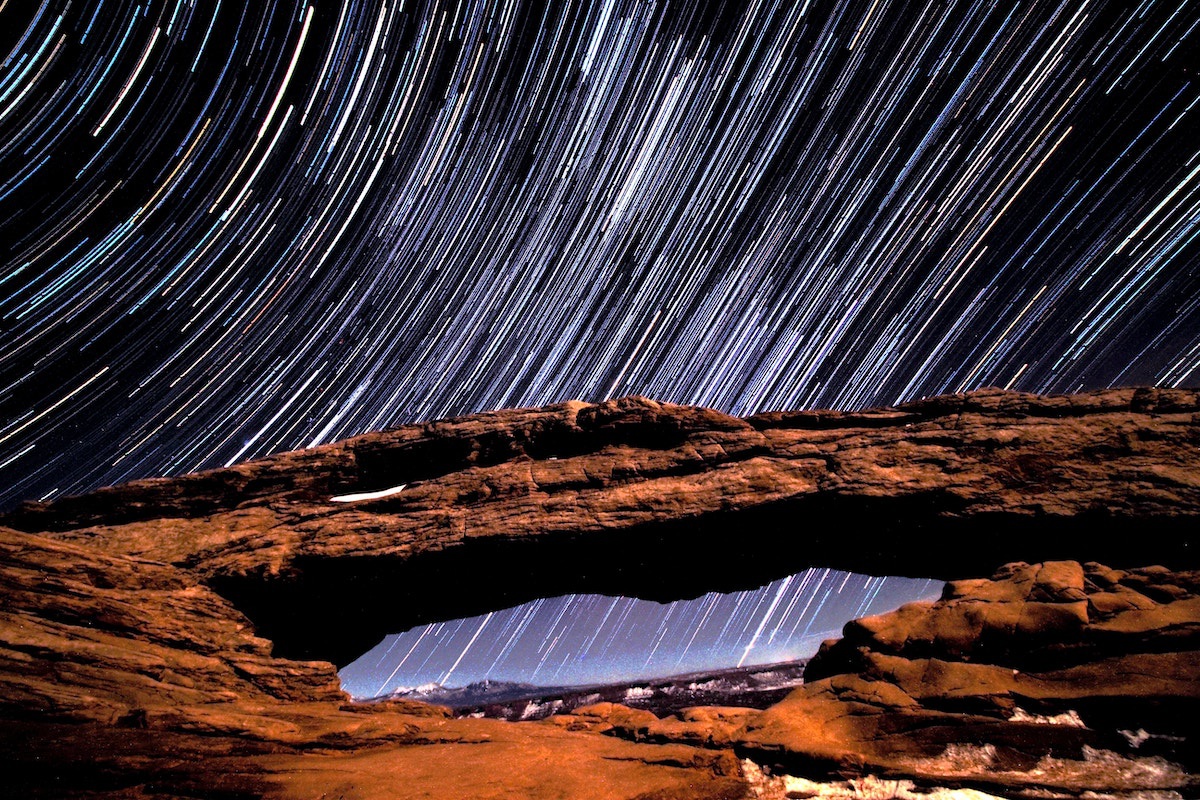
La cámara en realidad nunca había hecho una exposición larga, pero al sumar varias tomas consecutivas conseguíamos imitar el efecto. Para teléfonos ya había un montón de aplicaciones que usaban ese truco, pero dejaron de hacer falta cuando casi todas las aplicaciones de cámara lo incorporaron de serie. Hoy hasta el iPhone te monta sin problemas una exposición larga a partir de una Live Photo.
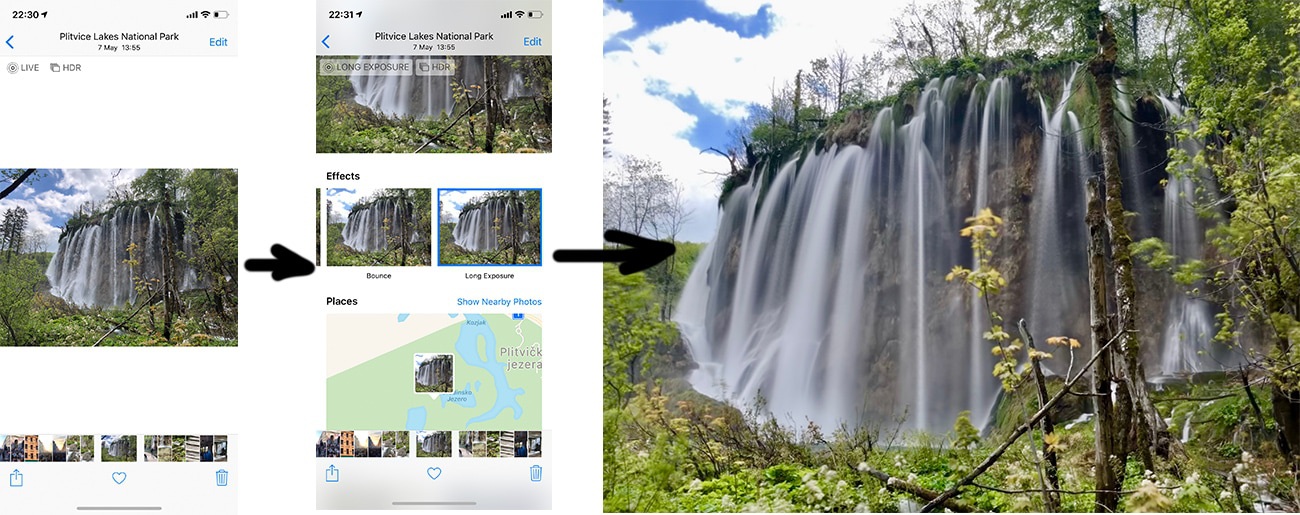
Volvamos a Google y su HDR nocturno. Resulta que con el horquillado temporal se puede conseguir un HDR bastante decente a oscuras. La tecnología apareció por primera vez en el Nexus 5 con el nombre de HDR+. Al resto de los teléfonos Android les vino de regalo, por así decirlo. Sigue siendo tan popular que todavía presumen de ella en la presentación de los últimos Pixel.
HDR+ funciona de forma bastante sencilla: cuando detecta que estás haciendo fotos a oscuras, la cámara saca del búfer las últimas 8-15 tomas en RAW y las superpone. Así el algoritmo reúne más información sobre las zonas oscuras para minimizar el ruido: esos píxeles donde, por lo que sea, la cámara no consiguió recoger toda la información y metió la pata.
Imagina que no sabes qué aspecto tiene un capibara y les pides a cinco personas que te lo describan. Sus descripciones se parecerán bastante, pero cada persona mencionará algún detalle distinto. Acabarás con más información que si le hubieras preguntado a una sola. Con los píxeles pasa lo mismo.
📝 HDR+: fotografía con poca luz y alto rango dinámico en la aplicación de cámara de Google
Sumar tomas hechas desde un mismo punto da el mismo efecto de falsa larga exposición que vimos con las estrellas. Las exposiciones de decenas de tomas se suman y los errores de una se compensan con las demás. Imagina cuántas veces tendrías que disparar el obturador de la réflex para conseguir eso con cada foto.
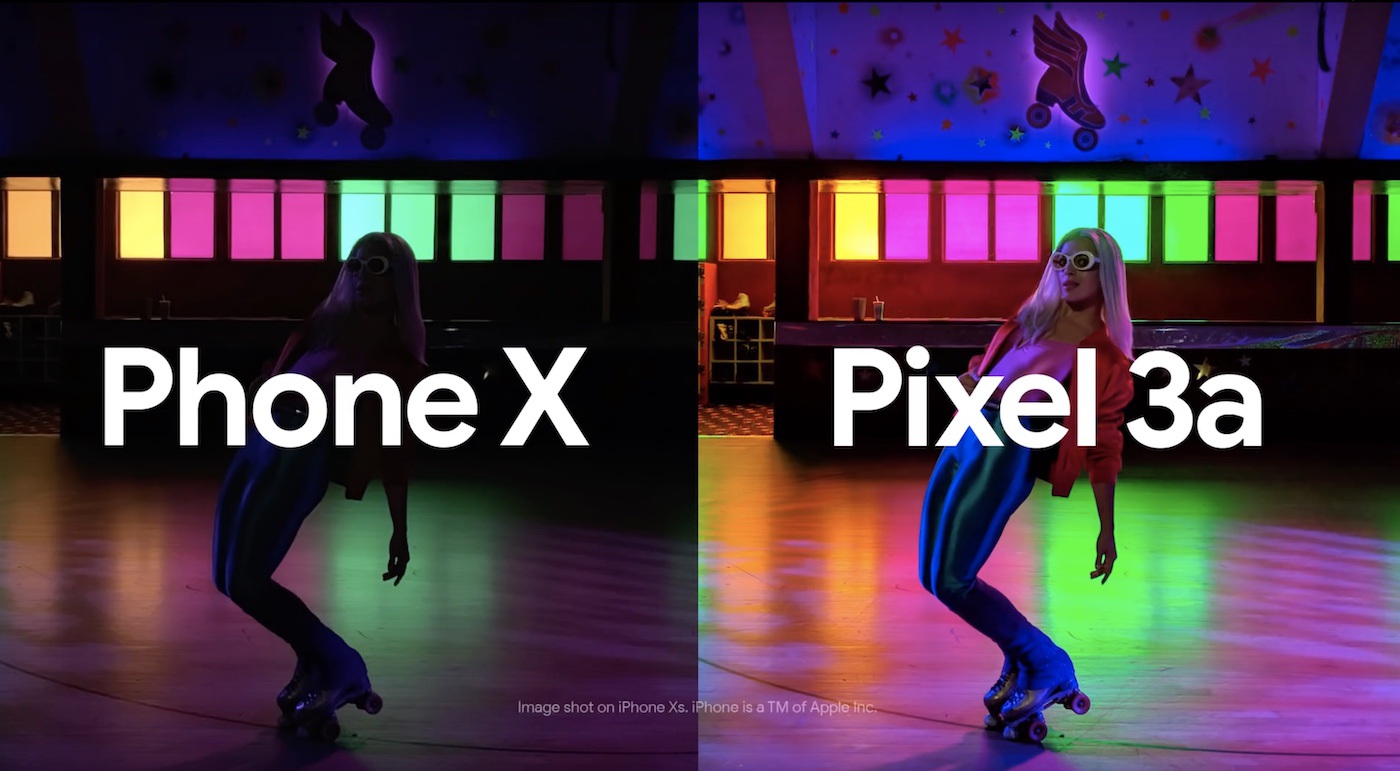
Solo quedaba resolver la corrección automática del color: las tomas hechas a oscuras suelen salir todas amarillas o verdes, y lo que queremos es algo parecido a los colores vivos de la luz del día. En las primeras versiones de HDR+ lo resolvían retocando unos ajustes, al estilo de los filtros de Instagram. Luego trajeron redes neuronales de refuerzo, más o menos como las que se usan para colorear fotos en blanco y negro. Hoy eso no tiene mucho misterio.
Así nació Night Sight, la tecnología de «fotografía nocturna» de los Pixel 2 y 3. Lo dicen en la propia descripción: «las técnicas de aprendizaje automático desarrolladas sobre HDR+ que hacen funcionar Night Sight». Básicamente, con ellas sacan adelante la corrección del color. Entrenaron a la máquina con un conjunto de fotos del «antes» y el «después» para que, de un puñado de fotos oscuras y mal hechas, sacara una bonita.
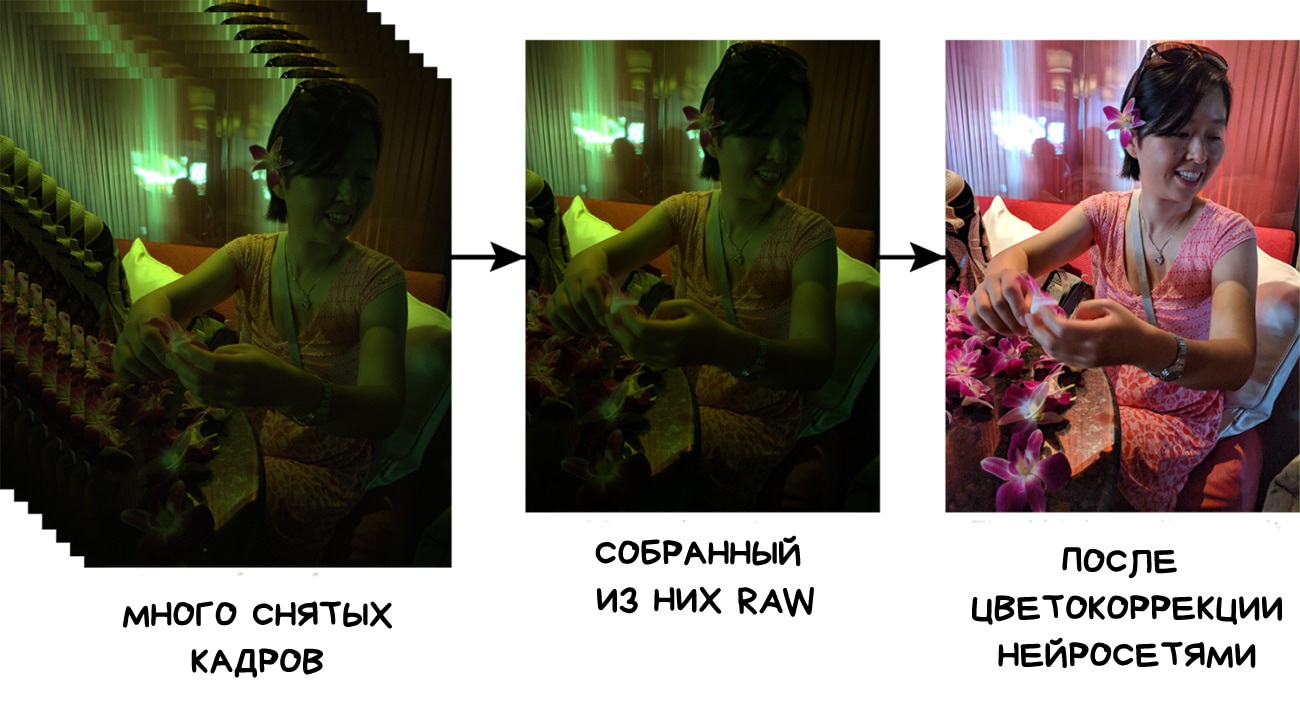
Por cierto, publicaron el conjunto de datos para que lo use cualquiera. A ver si los de Apple lo aprovechan y por fin les enseñan a sus palas de vidrio a sacar una foto decente a oscuras.
Además, Night Sight calcula el vector de movimiento de los objetos de la escena para corregir las estelas y las imágenes fantasma que inevitablemente aparecen en una larga exposición. Así el teléfono puede tomar las partes nítidas de otras fotos y «parchear» las zonas problemáticas.
📝 Night Sight: ver en la oscuridad con los teléfonos Pixel
📝 Presentación del conjunto de datos de fotografía en ráfaga de HDR+
A finales de 2019, el iPhone también estrenó un modo nocturno que, técnicamente, funciona exactamente igual. Se veía venir :)
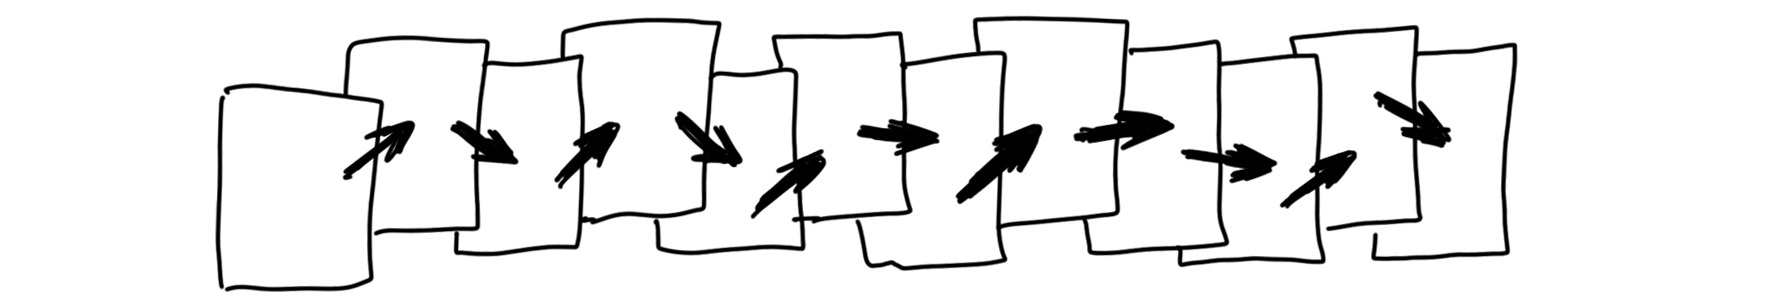
Las panorámicas son un pasatiempo popular entre los habitantes del campo. La historia no conoce un solo caso en que una panorámica con forma de salchicha le haya interesado a alguien, pero no podemos dejar de mencionarla: para muchos fue el primer contacto con el apilado.
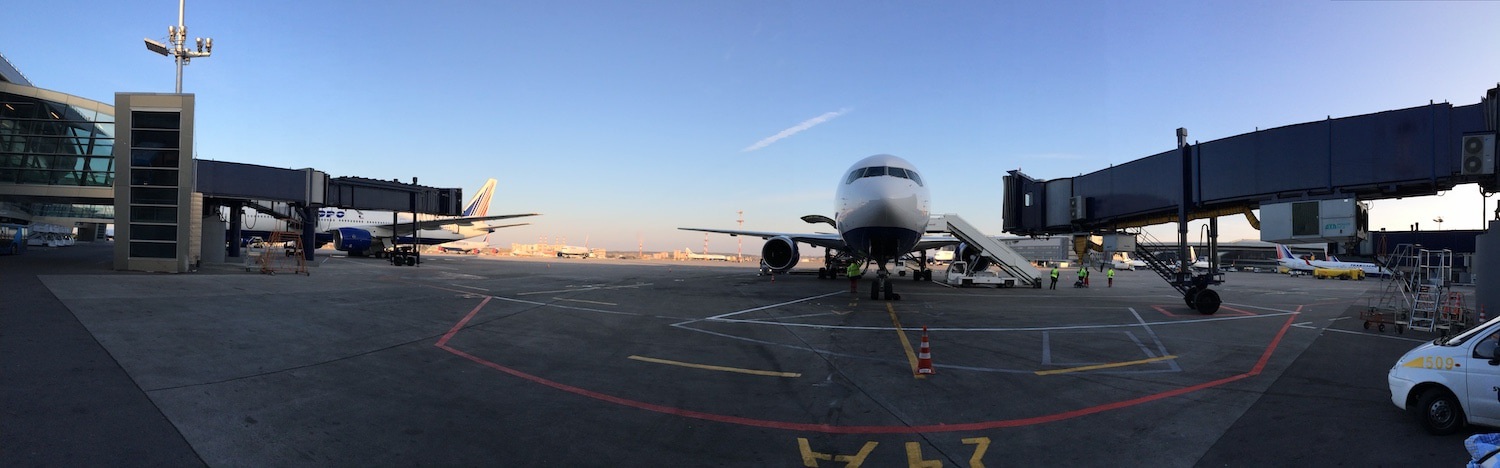
La primera aplicación útil de la panorámica es unir varias tomas para conseguir una foto de mayor resolución de la que permite el sensor. Los fotógrafos llevan tiempo usando distintos programas para crear las llamadas fotos de superresolución: las tomas están ligeramente desplazadas y es como si cada una rellenara los huecos entre los píxeles de las demás. Así puedes conseguir hasta cientos de gigapíxeles, muy útil si tienes que imprimir la foto en un cartel publicitario del tamaño de una casa.
📝 Guía práctica para crear fotos de superresolución con Photoshop
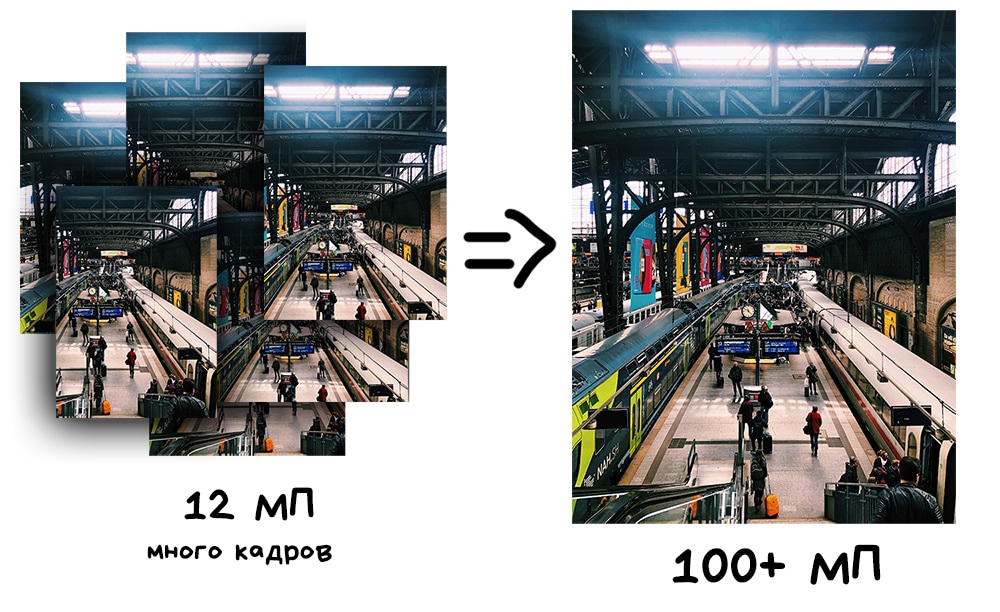
Otro método, ya más interesante, es el desplazamiento de píxeles o Pixel Shifting. Algunas cámaras sin espejo de Sony y Olympus empezaron a admitirlo allá por 2014, pero se limitaban a sacarte cinco fotos; luego te tocaba juntarlas a mano. La típica innovación de las cámaras grandes.
Los smartphones, en cambio, triunfaron aquí por una razón muy graciosa: cuando haces una foto, te tiemblan las manos. Lo que a primera vista parece un problema resultó ser la base de la superresolución nativa en los teléfonos.
Para entender cómo funciona hay que recordar cómo está hecho el sensor de cualquier cámara. Cada uno de sus píxeles (fotodiodos) solo puede registrar la intensidad de la luz, es decir, cuántos fotones le han llegado. No puede medir el color de esa luz (su longitud de onda). Para conseguir una imagen RGB hubo que montar un apaño: cubrir el sensor con una cuadrícula de cristalitos de colores para que cada fotodiodo se ocupe solo de su color, R, G o B.
La versión más popular de esa cuadrícula se llama filtro de Bayer y hoy se usa en la mayoría de los sensores. Tiene este aspecto:
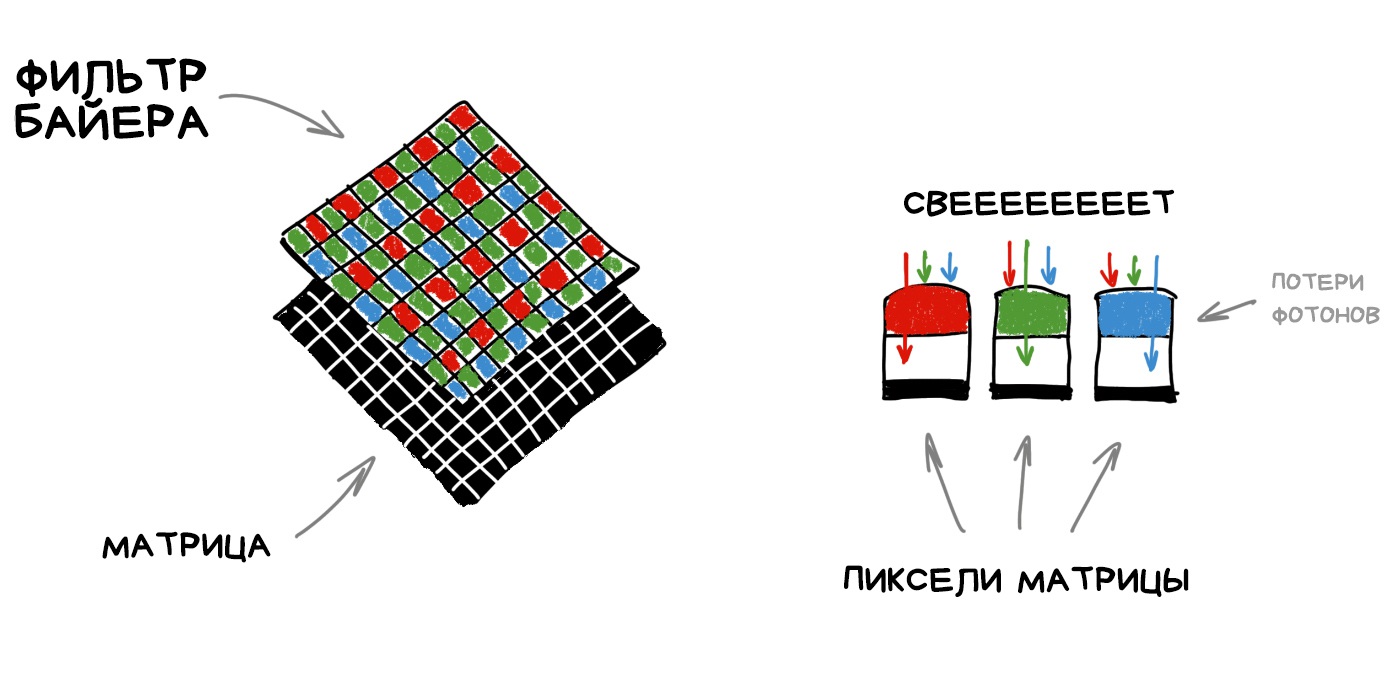
Resulta que si un rayito rojo tiene la mala suerte de caer sobre un cristalito verde o azul del sensor, el filtro de Bayer manda esos fotones directamente a la basura. Así, tranquilamente, podemos perder dos tercios de los fotones.
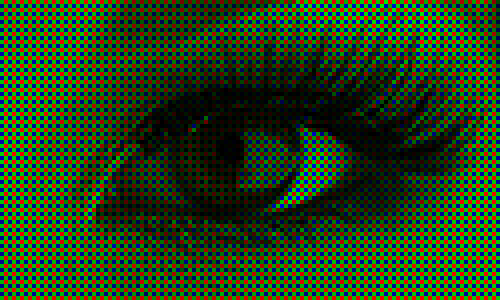
En el filtro de Bayer hay más celdas verdes; lo hicieron así por analogía con el ojo humano. De los 50 millones de píxeles de un sensor, 25 millones captarán el verde, 12,5 millones el rojo y otros tantos el azul. El resto se calcula promediando. El proceso se llama interpolación de Bayer o desmosaicado, y todo se sostiene sobre ese apaño enorme y ridículo. Qué asco.
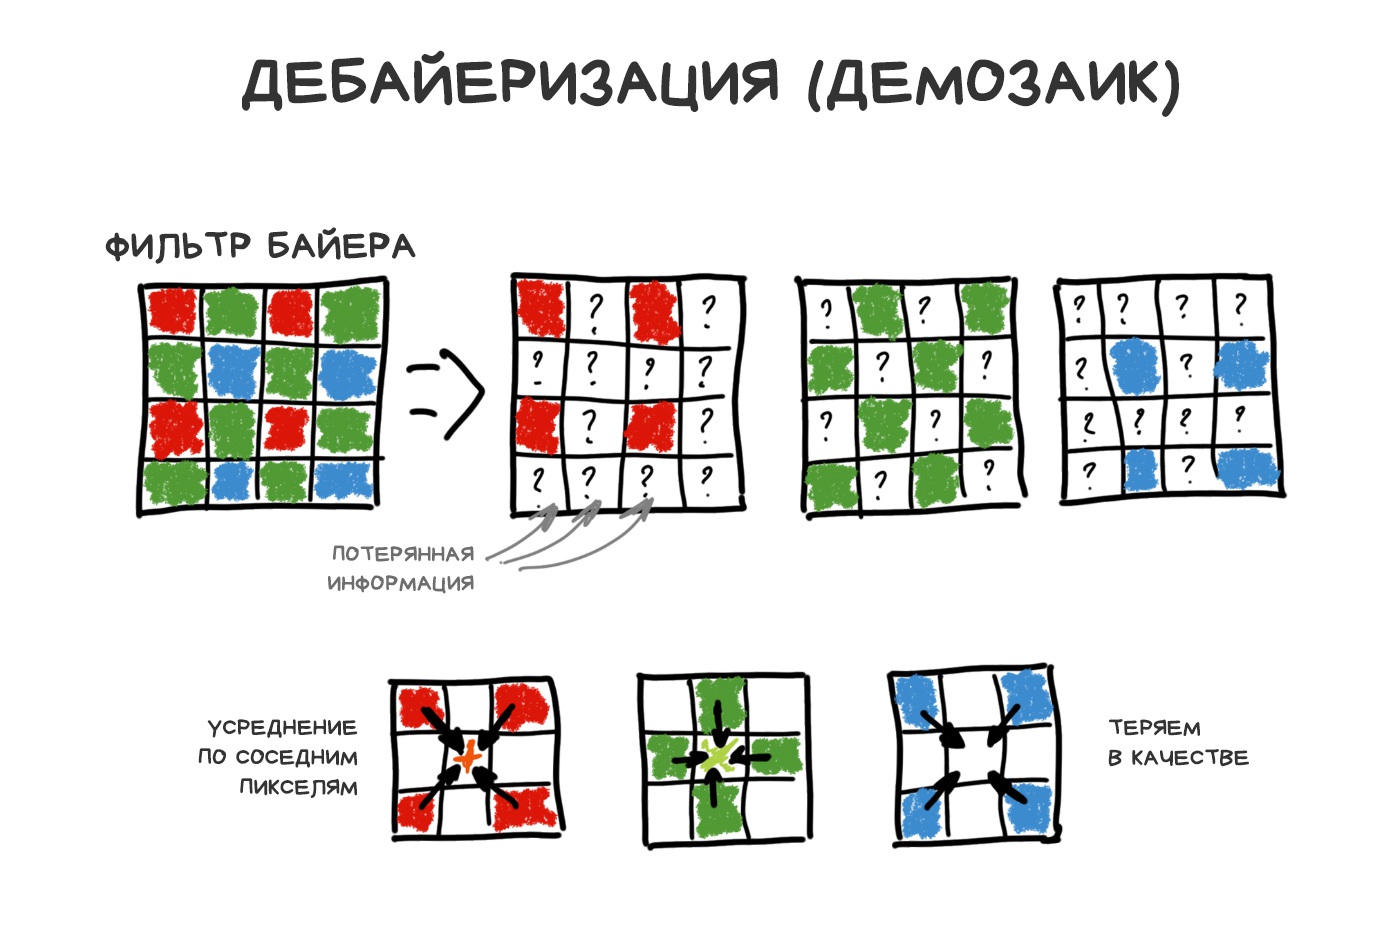
En realidad, cada sensor tiene su propio retorcido y patentadísimo algoritmo de desmosaicado, pero para lo que estamos contando nos importa una mierda
Otros tipos de sensores (como Foveon) no han terminado de cuajar, por decirlo suavemente. Aunque de vez en cuando algún fabricante sigue probando sensores sin filtro de Bayer para mejorar la nitidez y el rango dinámico.
Cuando hay poca luz o los detalles del objeto son diminutos, perdemos un montón de información porque el filtro de Bayer descarta sin contemplaciones los fotones cuya longitud de onda no le gusta. De ahí la idea del Pixel Shifting: mover el sensor un píxel arriba, abajo, a la derecha y a la izquierda para atraparlos a todos. La foto no sale cuatro veces más grande, como podría parecer; el procesador usa esos datos para registrar con mayor precisión el valor de cada píxel. Por así decirlo, no promedia los valores de sus vecinos, sino cuatro valores de sí mismo.
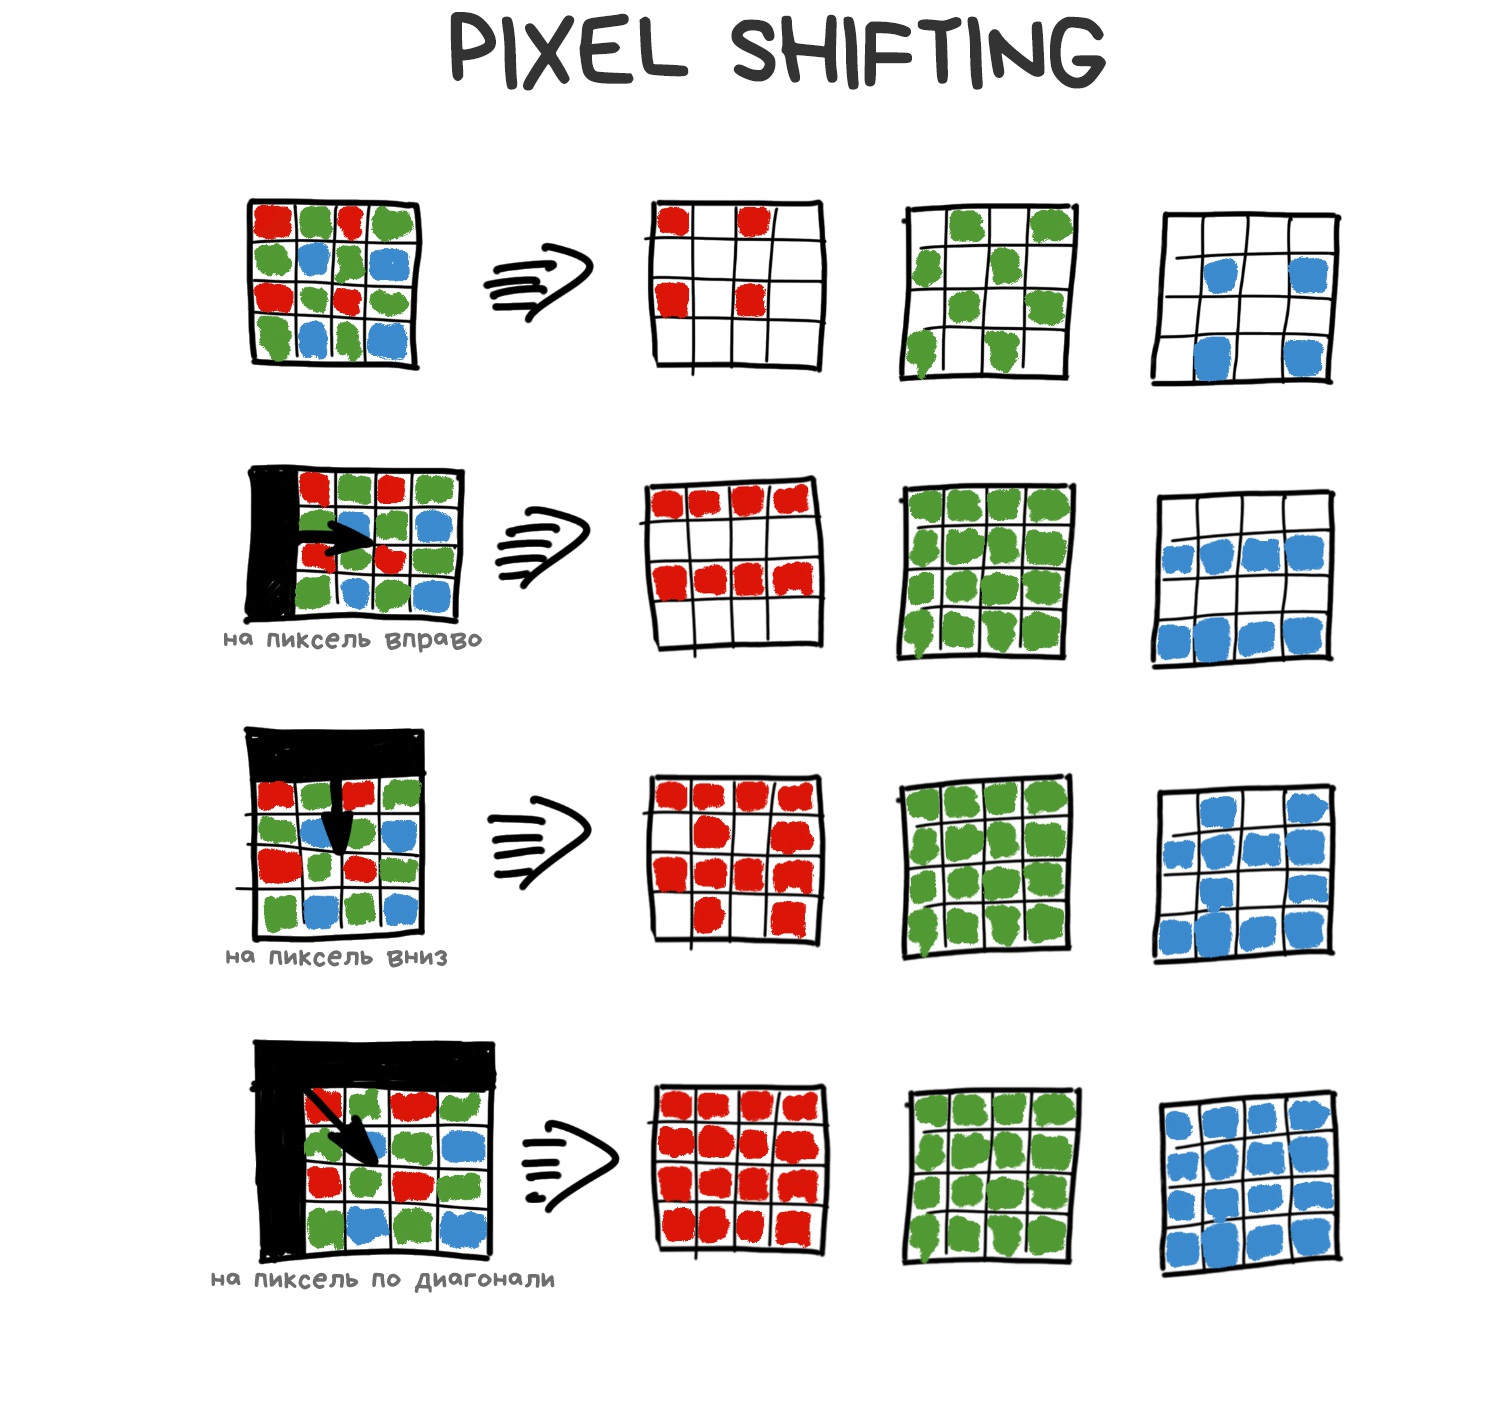

Cuando hacemos una foto con el teléfono, el temblor de las manos produce ese desplazamiento de forma natural. En los últimos iPhone y Google Pixel la función viene integrada en el procesador y se activa cuando hace falta, especialmente al hacer zoom. Google la llama Super Res Zoom y la verdad es que da un zoom estupendo. En el iPhone se llama Deep Fusion; hay una pequeña diferencia, y es que las tomas intermedias se hacen además con distintos tiempos de exposición, pero el principio es el mismo.
La próxima vez que veas un zoom de 100× en el nuevo Huawei, ya sabes qué hay detrás. De zoom óptico tiene, como mucho, 10×.
📝 SIGGRAPH 2019: superresolución con múltiples tomas a mano alzada
📝 Ver mejor y más lejos con Super Res Zoom en el Pixel 3
Superponer fotografías ligeramente desplazadas permite reunir más información sobre el color de cada píxel y, por tanto, reducir el ruido, ganar nitidez y aumentar la resolución sin aumentar la cantidad física de megapíxeles del sensor.
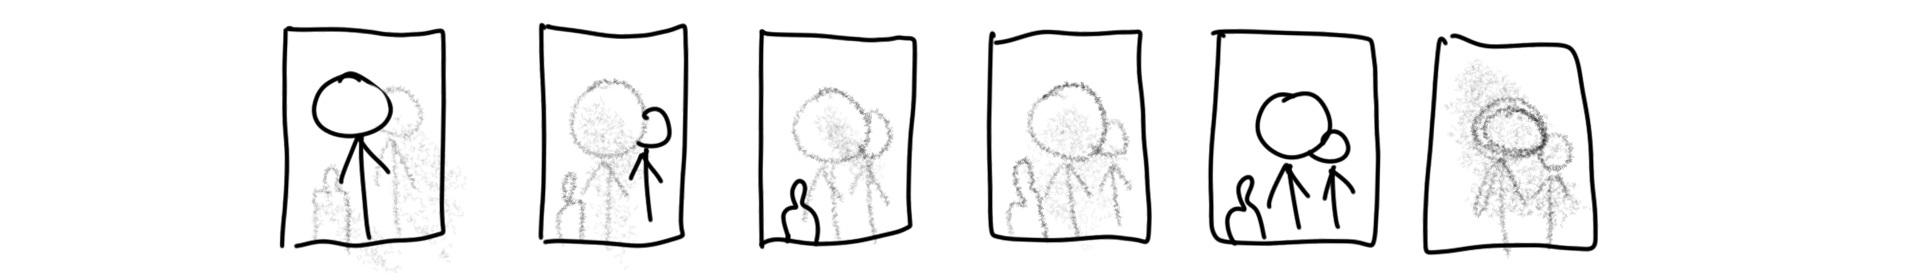
El método viene de la macrofotografía, donde la escasa profundidad de campo siempre ha sido un problema. Para que todo el objeto quedara enfocado había que hacer varias tomas, adelantando y atrasando el enfoque, y unirlas después en una sola foto nítida. Los aficionados a los paisajes solían usar el mismo método para que tanto el primer plano como el fondo salieran nítidos de cojones.
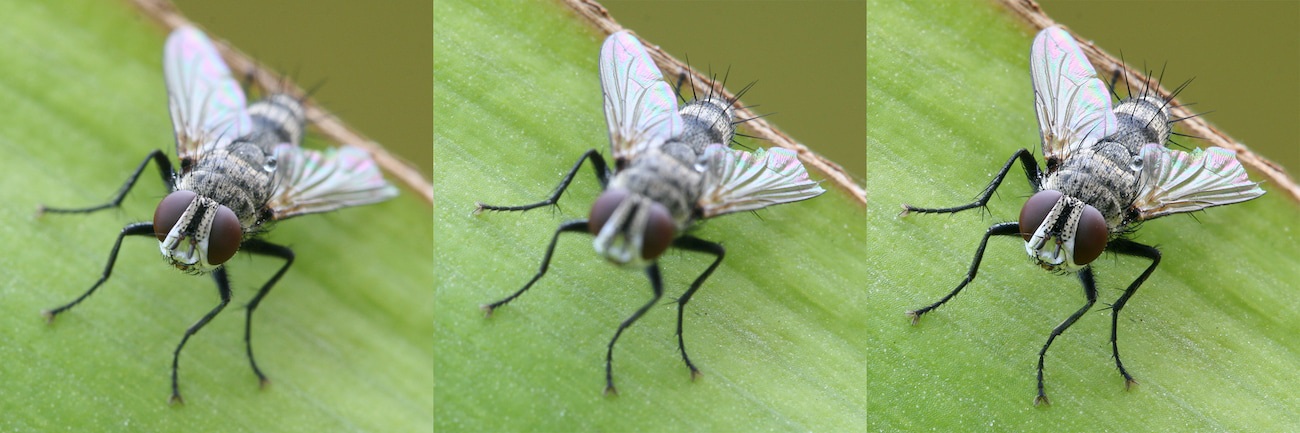
Todo eso también llegó a los teléfonos, aunque sin mucho revuelo. En 2013 salió el Nokia Lumia 1020 con «Refocus App» y en 2014, el Samsung Galaxy S5 con su modo «Selective Focus». Los dos funcionaban igual: pulsabas el botón y hacían rápidamente tres fotos, una con el enfoque «normal», otra enfocando más cerca y otra más lejos. El programa alineaba las tomas y te dejaba elegir una. Te lo vendían como control «de verdad» del enfoque en posproducción.
No había más procesamiento: incluso ese sencillo truco bastó para clavar otro clavo en el ataúd de Lytro y otras cámaras que sí reenfocaban de verdad. Por cierto, hablemos de ellas (maestro de las transiciones, nivel 80).
Todo ese ingenio del apilado, los modos nocturnos y las redes neuronales está muy bien, pero tiene una gran pega: lo que sale de ahí es un JPEG de toda la vida. Sí, muy vistoso, muy luminoso, muy brillante, pero un JPEG al fin y al cabo, con su mayor defecto: es prácticamente imposible rematar la edición como se debe en posproducción.
Manosear los colores, el microcontraste, todas esas cositas que tanto nos gustan.
Tenemos a nuestra disposición toda la potencia del apilado y de la fotografía computacional y acabamos volcando el resultado en un JPEG para plebeyos
Como si en un restaurante nos sirvieran una pasta delicadísima y luego la enterraran bajo un puto chorro de kétchup.
Y se entiende: a la gente normal le bastan los JPEG. Hasta a mí, para las crónicas de viajes del blog, estos últimos años me sobran las fotos del iPhone sin retocar. Ya ni hablar de Instagram y las redes sociales, que las recomprimen hasta dejarlas en diez píxeles mugrientos.
Los que no están contentos son los fotógrafos. Han probado todo el poder de la fotografía computacional, han entendido que a una réflex le resulta físicamente imposible hacer lo mismo, pero siguen sin poder disfrutar de sus ventajas porque lo que sale al final son simples JPEG. Todo porque seguimos creyendo que el RAW es sagrado y solo guardamos en él los píxeles en bruto de una única toma.
Sabiendo todo lo que ofrece el apilado, imagina la rabia que da. En el JPEG tienes una foto nocturna preciosa, compuesta a partir de diez tomas, con una exposición de dos segundos estabilizada de maravilla. En el RAW, un solitario cuadrado ruidoso y movido.
Pues bien, en los últimos años hemos empezado a entender que va siendo hora de replantearnos qué es un archivo RAW. Ya no es una simple copia de los píxeles del sensor, sino un contenedor de los resultados intermedios de todos los algoritmos, que deja al fotógrafo componer y ajustar la foto final tal como la imaginó.
En uno de esos DNG multicapa pueden guardarse por separado la foto que ha rescatado el modo nocturno, su mapa de profundidad y otras máscaras útiles.
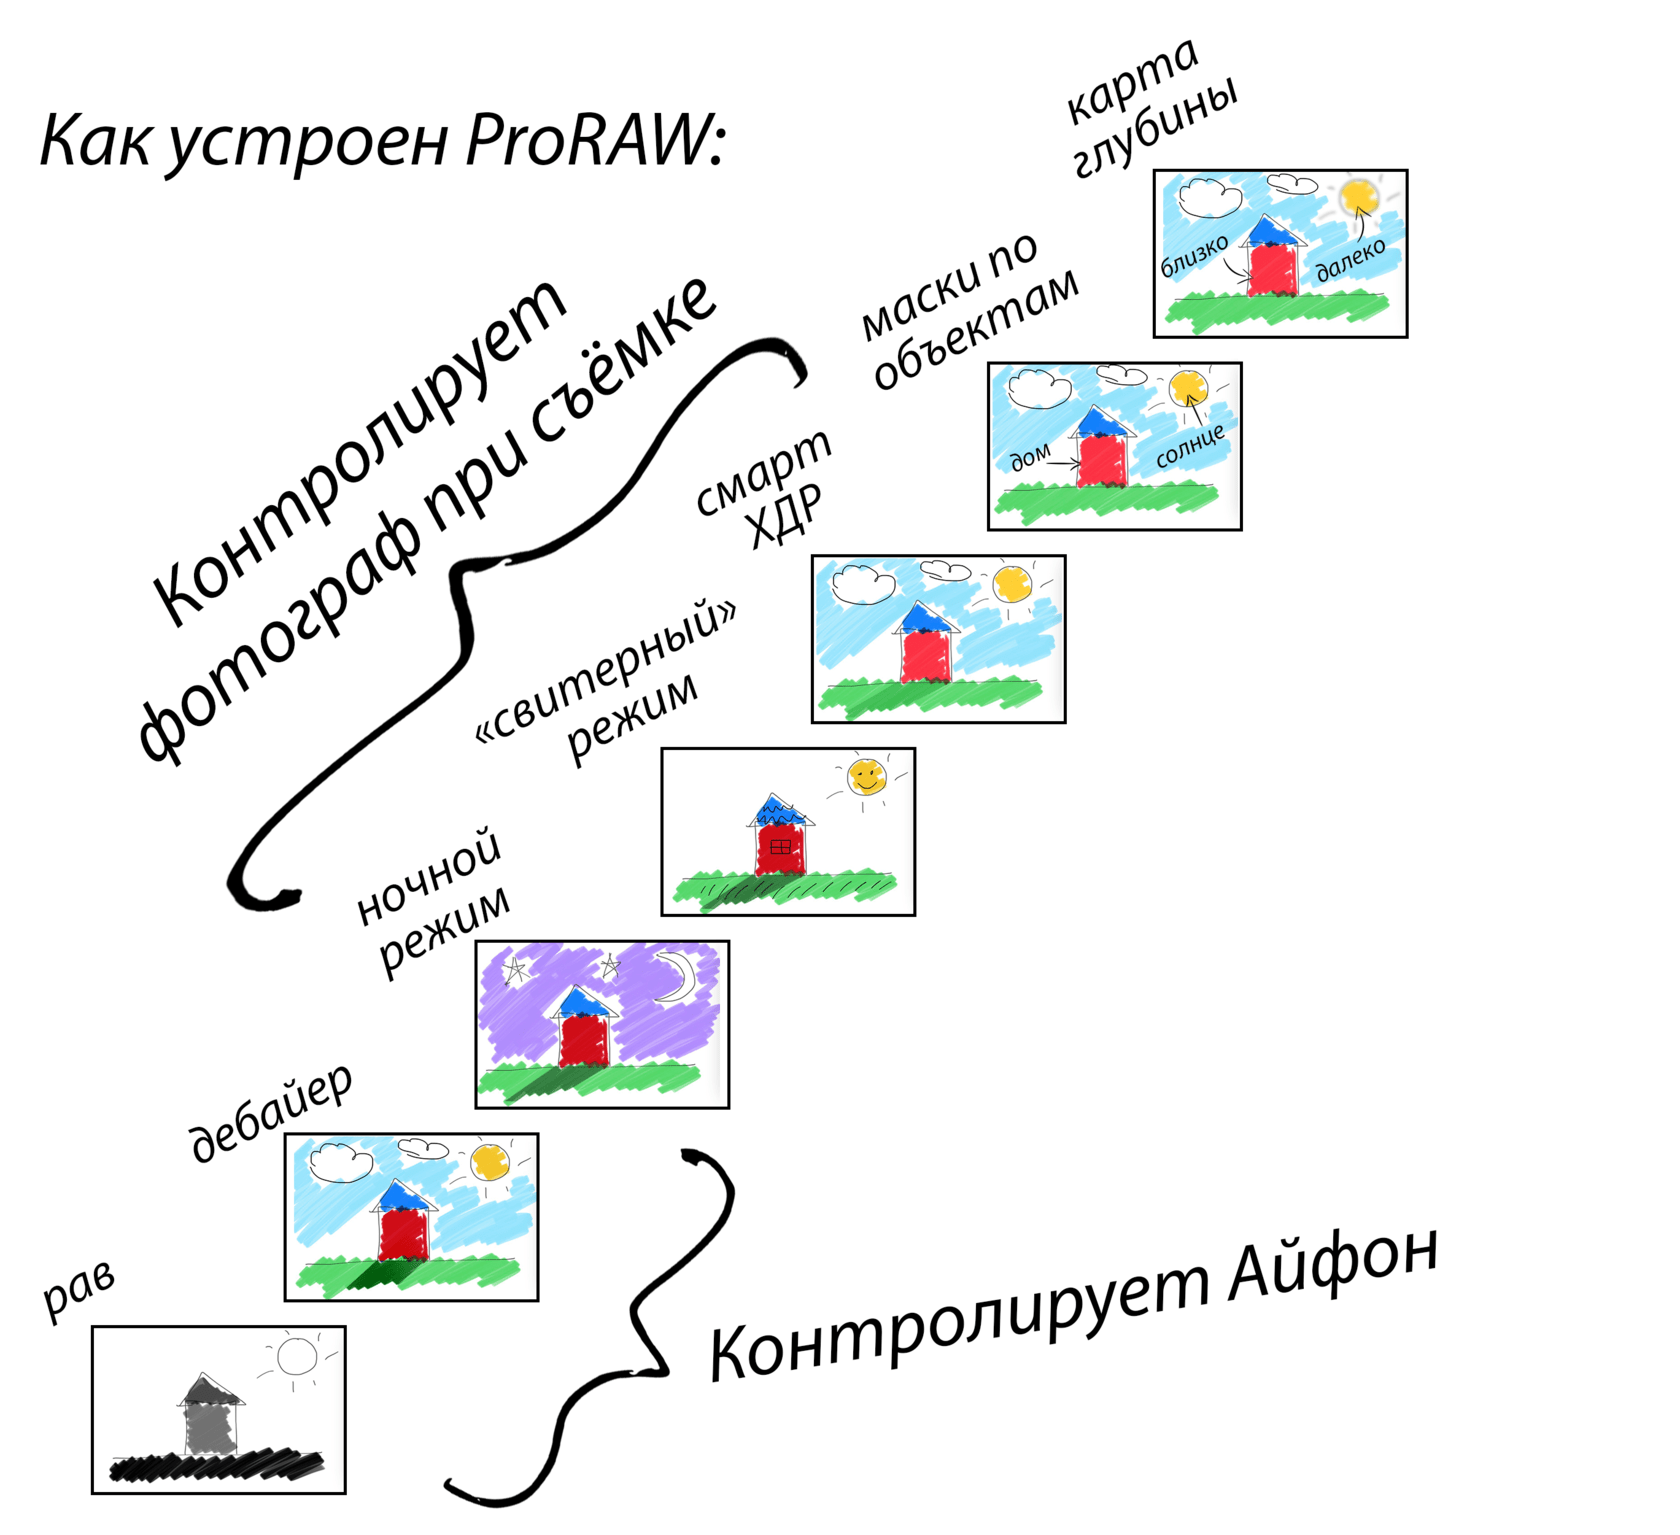
Así entra en escena el RAW computacional, presente en los Google Pixel desde 2018 y que llegó al iPhone en 2020 con el nombre de Pro RAW. Ambos usan el formato DNG.
La imagen de arriba la saqué de un artículo reciente de Gueorgui Dzhedzheya dedicado por entero a Pro RAW y a por qué es tan buena noticia para los fotógrafos. Te recomiendo pasar por allí 👇
💎 Fotografía computacional 2.0
La fiesta de los RAW computacionales acaba de empezar. Poca gente se tomaba en serio lo de fotografiar en RAW con un Android, así que tampoco se hacía mucho software para eso. En cambio, en cuanto apareció Apple Pro RAW, los desarrolladores se pusieron en marcha: ahora veremos a Pixelmator y Lightroom competir por ver quién presume de la edición multicapa más bonita.
En el blog de Halide publicaron un buen artículo sobre las entrañas del formato: Entender ProRAW.
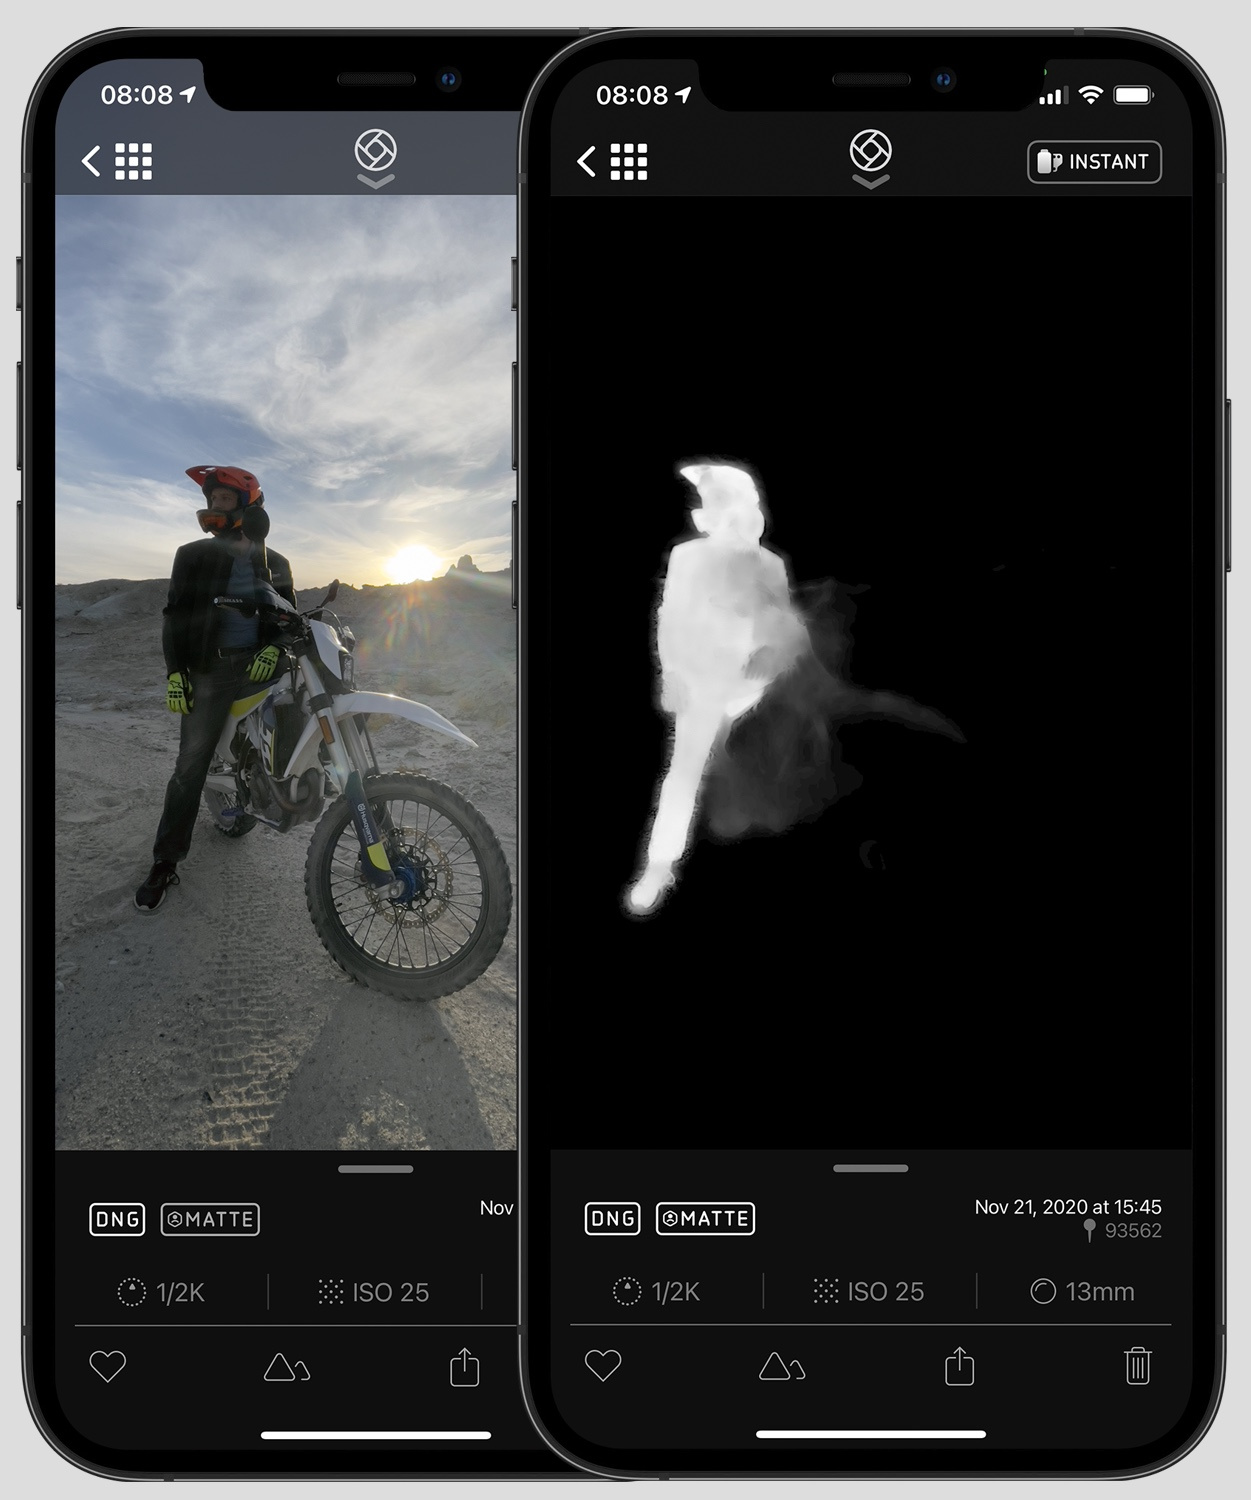
Como ya hemos visto, nuestros sensores son un engendro que se sostiene con muletas. Su diseño apenas ha cambiado desde el principio de los tiempos. Solo hemos mejorado el proceso de fabricación: redujimos la distancia entre píxeles, combatimos el ruido y las interferencias, añadimos píxeles especiales para el enfoque automático por detección de fase. Pero toma la réflex más cara e intenta fotografiar a un gato corriendo por casa con la luz de la habitación. Digamos que gana el gato.
🎥 La ciencia de los sensores de las cámaras
Llevamos tiempo intentando inventar algo mejor. Si buscas «computational sensor» o «non-bayer sensor» en Google encontrarás montones de intentos e investigaciones en ese campo. Hasta el Pixel Shifting de antes puede considerarse un intento de mejorar los sensores a base de cálculos.
Sin embargo, las historias más prometedoras de los últimos veinte años vienen del mundo de las llamadas cámaras plenópticas.
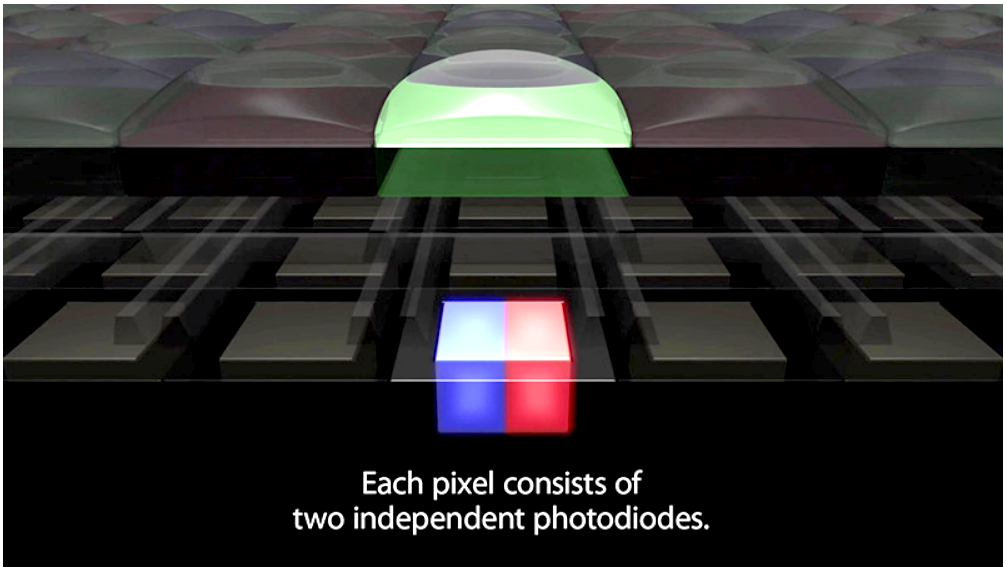
Para que no te duermas anticipando la que se te viene encima de palabras complicadas, te adelanto una cosa: la cámara de los últimos Google Pixel también es «un poquito» plenóptica. Solo dos píxeles, pero con eso ya le alcanza para calcular la profundidad real de la escena por medios ópticos y sin recurrir a una segunda cámara como todo el mundo.
La plenóptica es un arma potente que todavía no ha disparado. Aquí abajo te dejo uno de mis artículos recientes favoritos sobre lo que pueden hacer las cámaras plenópticas y lo que nos espera con ellas. De ahí tomé prestados los ejemplos.
📝 Vídeo computacional de 755 megapíxeles: la plenóptica ayer, hoy y mañana
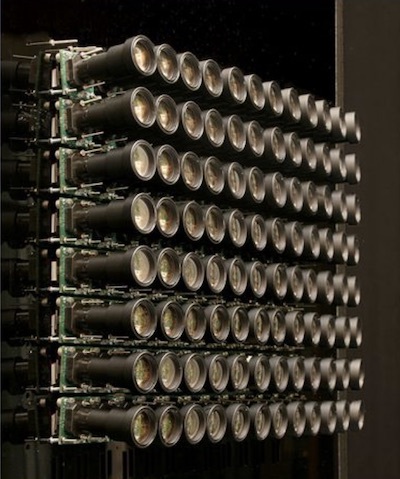
Se inventó en 1994 y se construyó en Stanford en 2004. La primera cámara de consumo, la Lytro, salió en 2012. La industria de la realidad virtual anda experimentando bastante con tecnologías parecidas.
La cámara plenóptica se diferencia de una normal en una sola modificación: su sensor está cubierto por una cuadrícula de lentes, cada una de las cuales abarca varios píxeles físicos. Más o menos así:
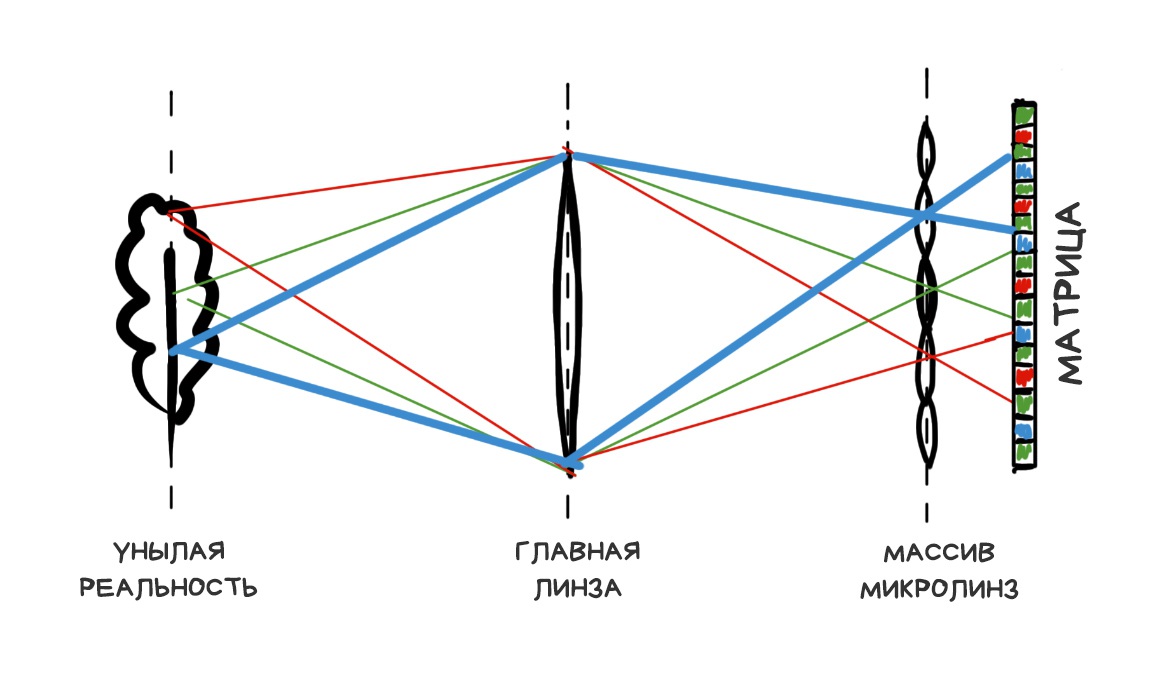
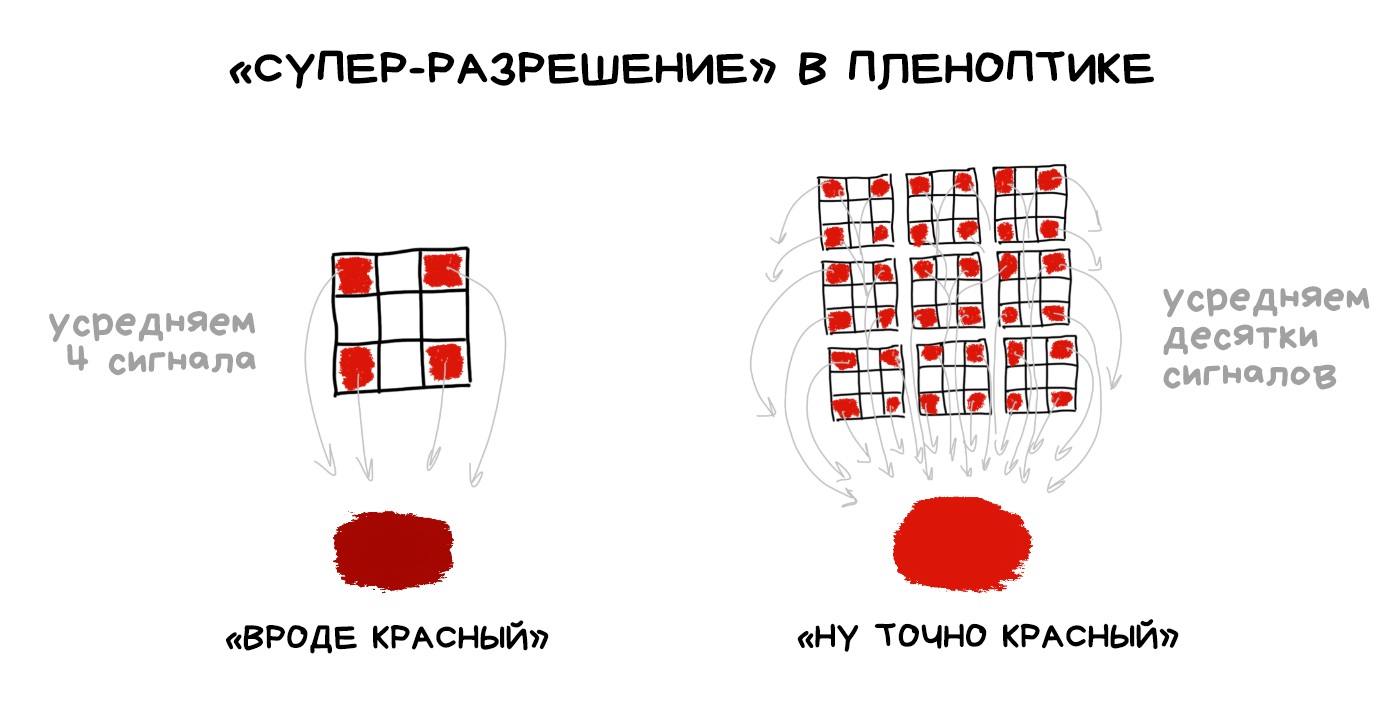
Si calculamos bien la distancia entre la cuadrícula y el sensor, así como el tamaño de la apertura, en la imagen final obtendremos grupos de píxeles bien definidos, una especie de versiones en miniatura de la imagen original.
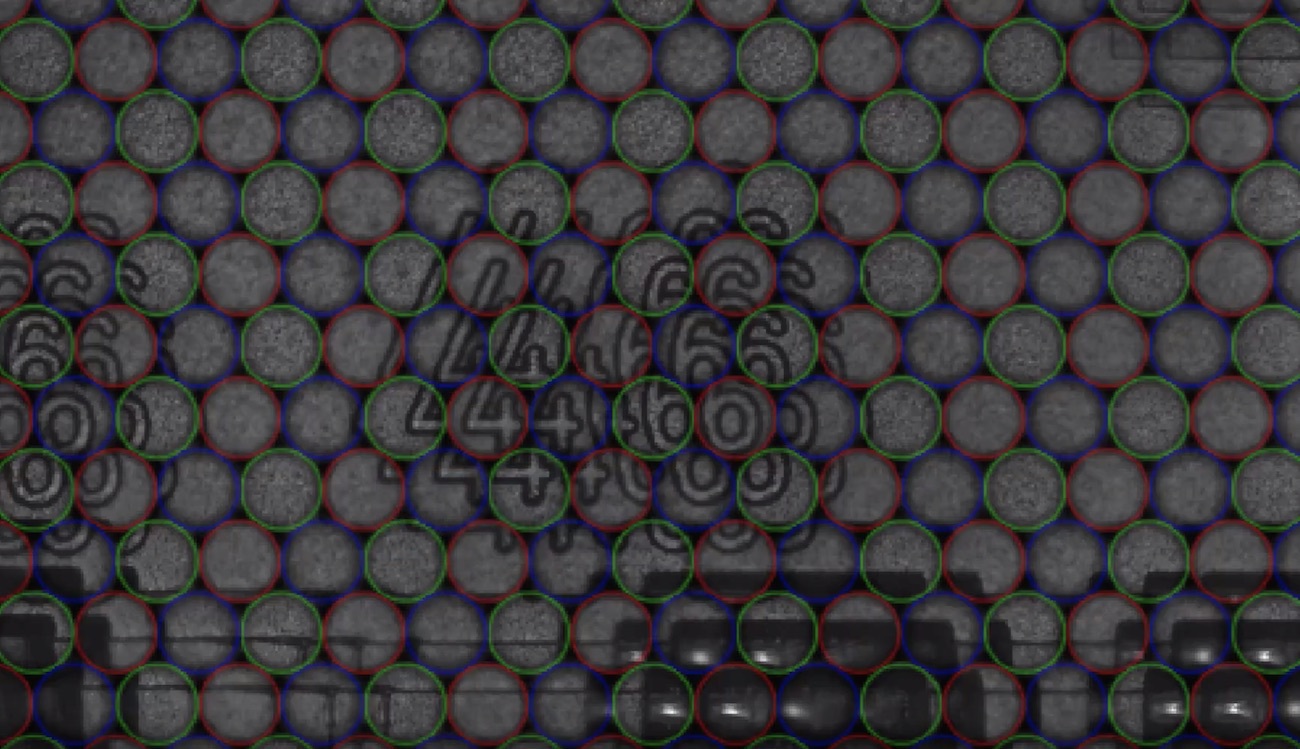
🎥 Vídeo sin sonido en el que se ve cómo se edita el archivo RAW
Resulta que si tomamos, por ejemplo, el píxel central de cada grupo y armamos una imagen solo con esos píxeles, no se distinguirá de una tomada con una cámara normal. Sí, hemos perdido algo de resolución, pero basta con pedirle a Sony que eche unos cuantos megapíxeles más en sus próximos sensores.
Y aquí empieza lo divertido. Si elegimos otro píxel de cada grupo y volvemos a armar la imagen, sale otra foto normal, solo que parece tomada desde una posición desplazada un píxel. Así, con grupos de 10 × 10 píxeles, tenemos 100 imágenes del objeto desde puntos «ligeramente» distintos.
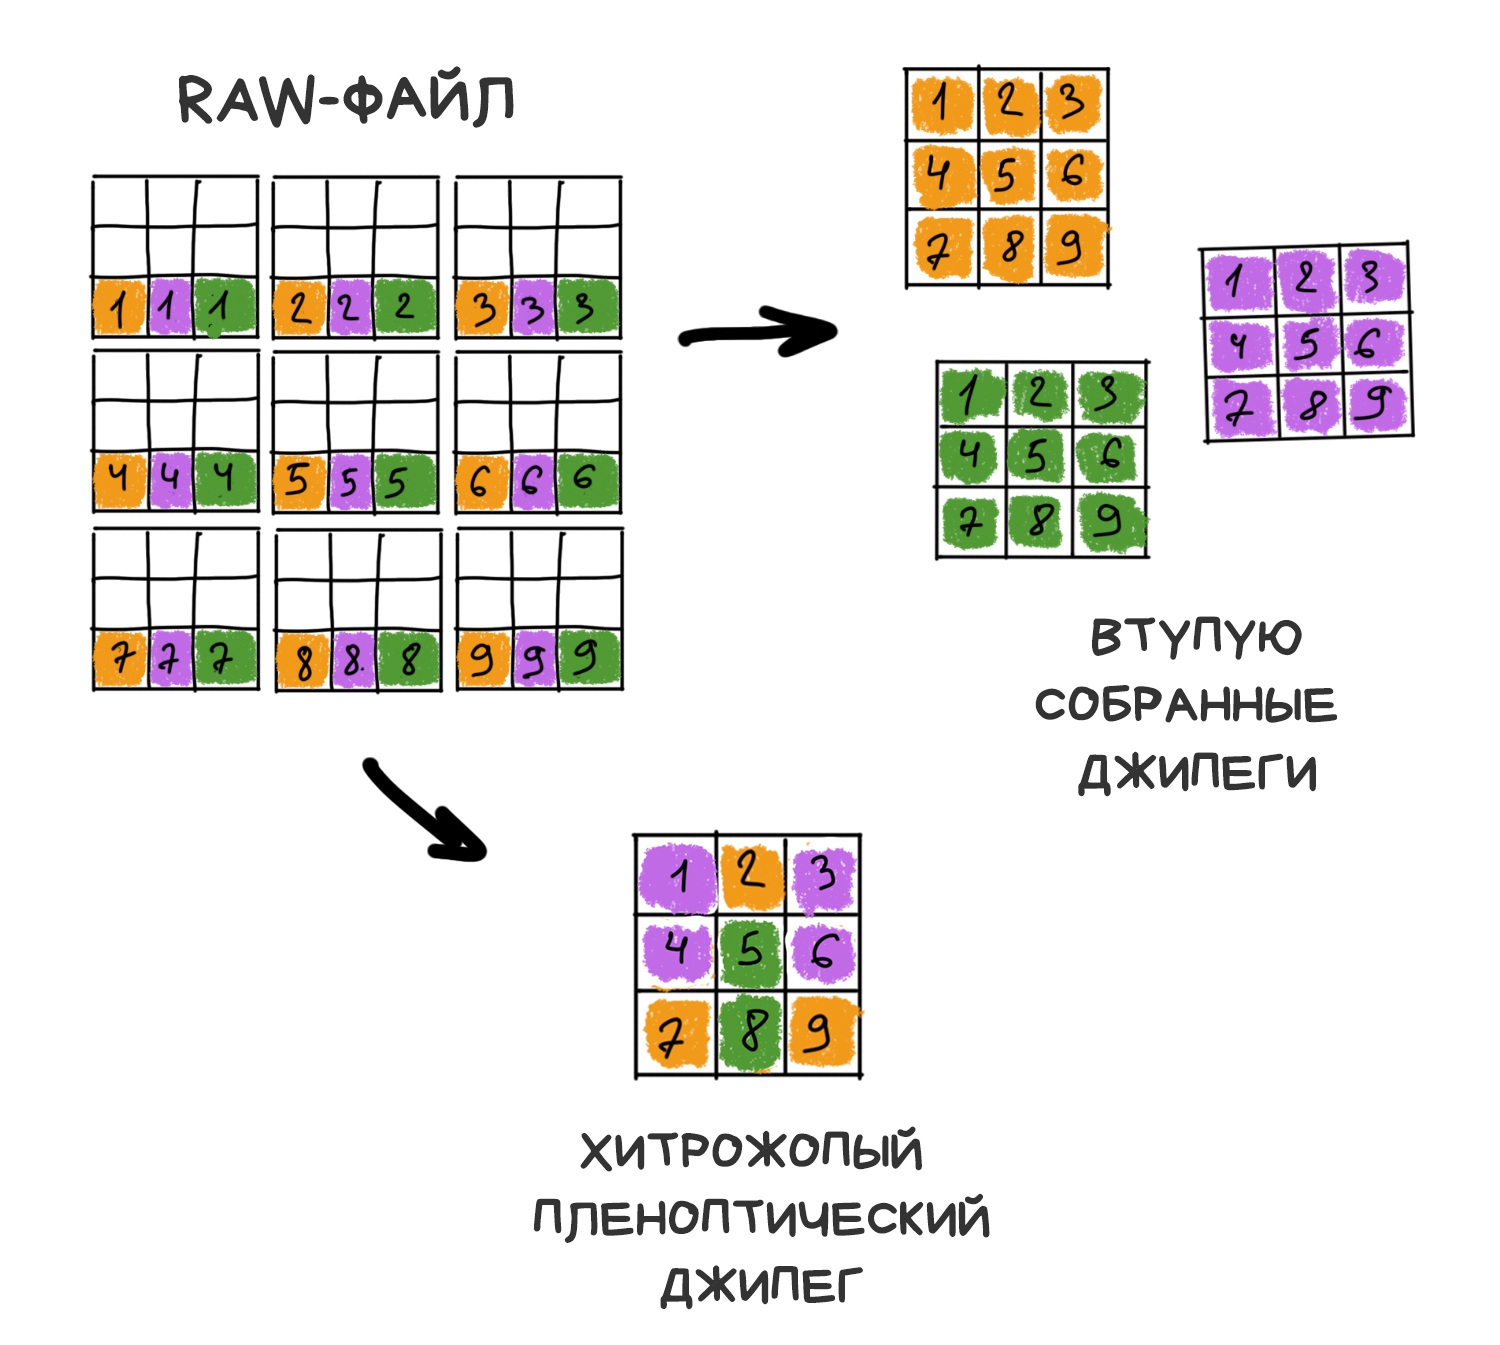
Cuanto más grande sea el grupo, más imágenes tendremos, pero de menor resolución. En un mundo de teléfonos con sensores de 41 megapíxeles podemos sacrificar un poco de resolución, pero todo tiene un límite. Hay que mantener el equilibrio.
📝 plenoptic.info: sitio sobre plenóptica con ejemplos de código en Python
Bien, ya hemos construido una cámara plenóptica. ¿Y qué ganamos con eso?
La función que tanto ruido hizo en todos los artículos sobre Lytro era la posibilidad de ajustar el enfoque de verdad en posproducción. Con «de verdad» quiero decir que no usamos algoritmos para quitar el desenfoque: trabajamos exclusivamente con los píxeles que ya tenemos, seleccionándolos de los grupos o promediándolos en el orden adecuado.
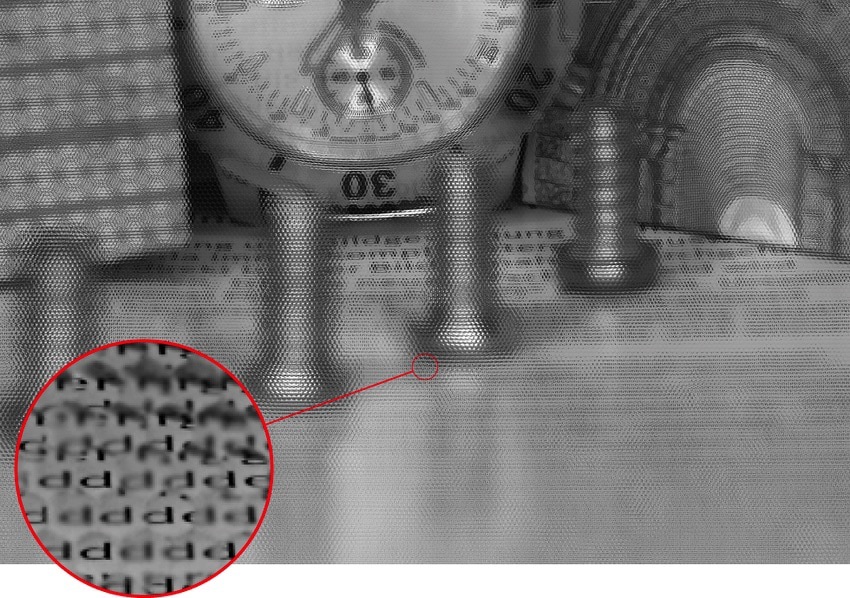
Una foto RAW de una cámara plenóptica tiene un aspecto raro. Para sacar el típico JPEG nítido, primero hay que armarlo. Para eso hay que elegir cada píxel del JPEG de entre los de un grupo del RAW. Según cómo los elijamos, cambiará el resultado.
Por ejemplo, cuanto más lejos esté el grupo del punto donde cayó el rayo original, más desenfocado aparece ese rayo. Cosas de la óptica. Para obtener una imagen enfocada en otro plano, basta con elegir los píxeles a la distancia que nos interese respecto al original, más cerca o más lejos.
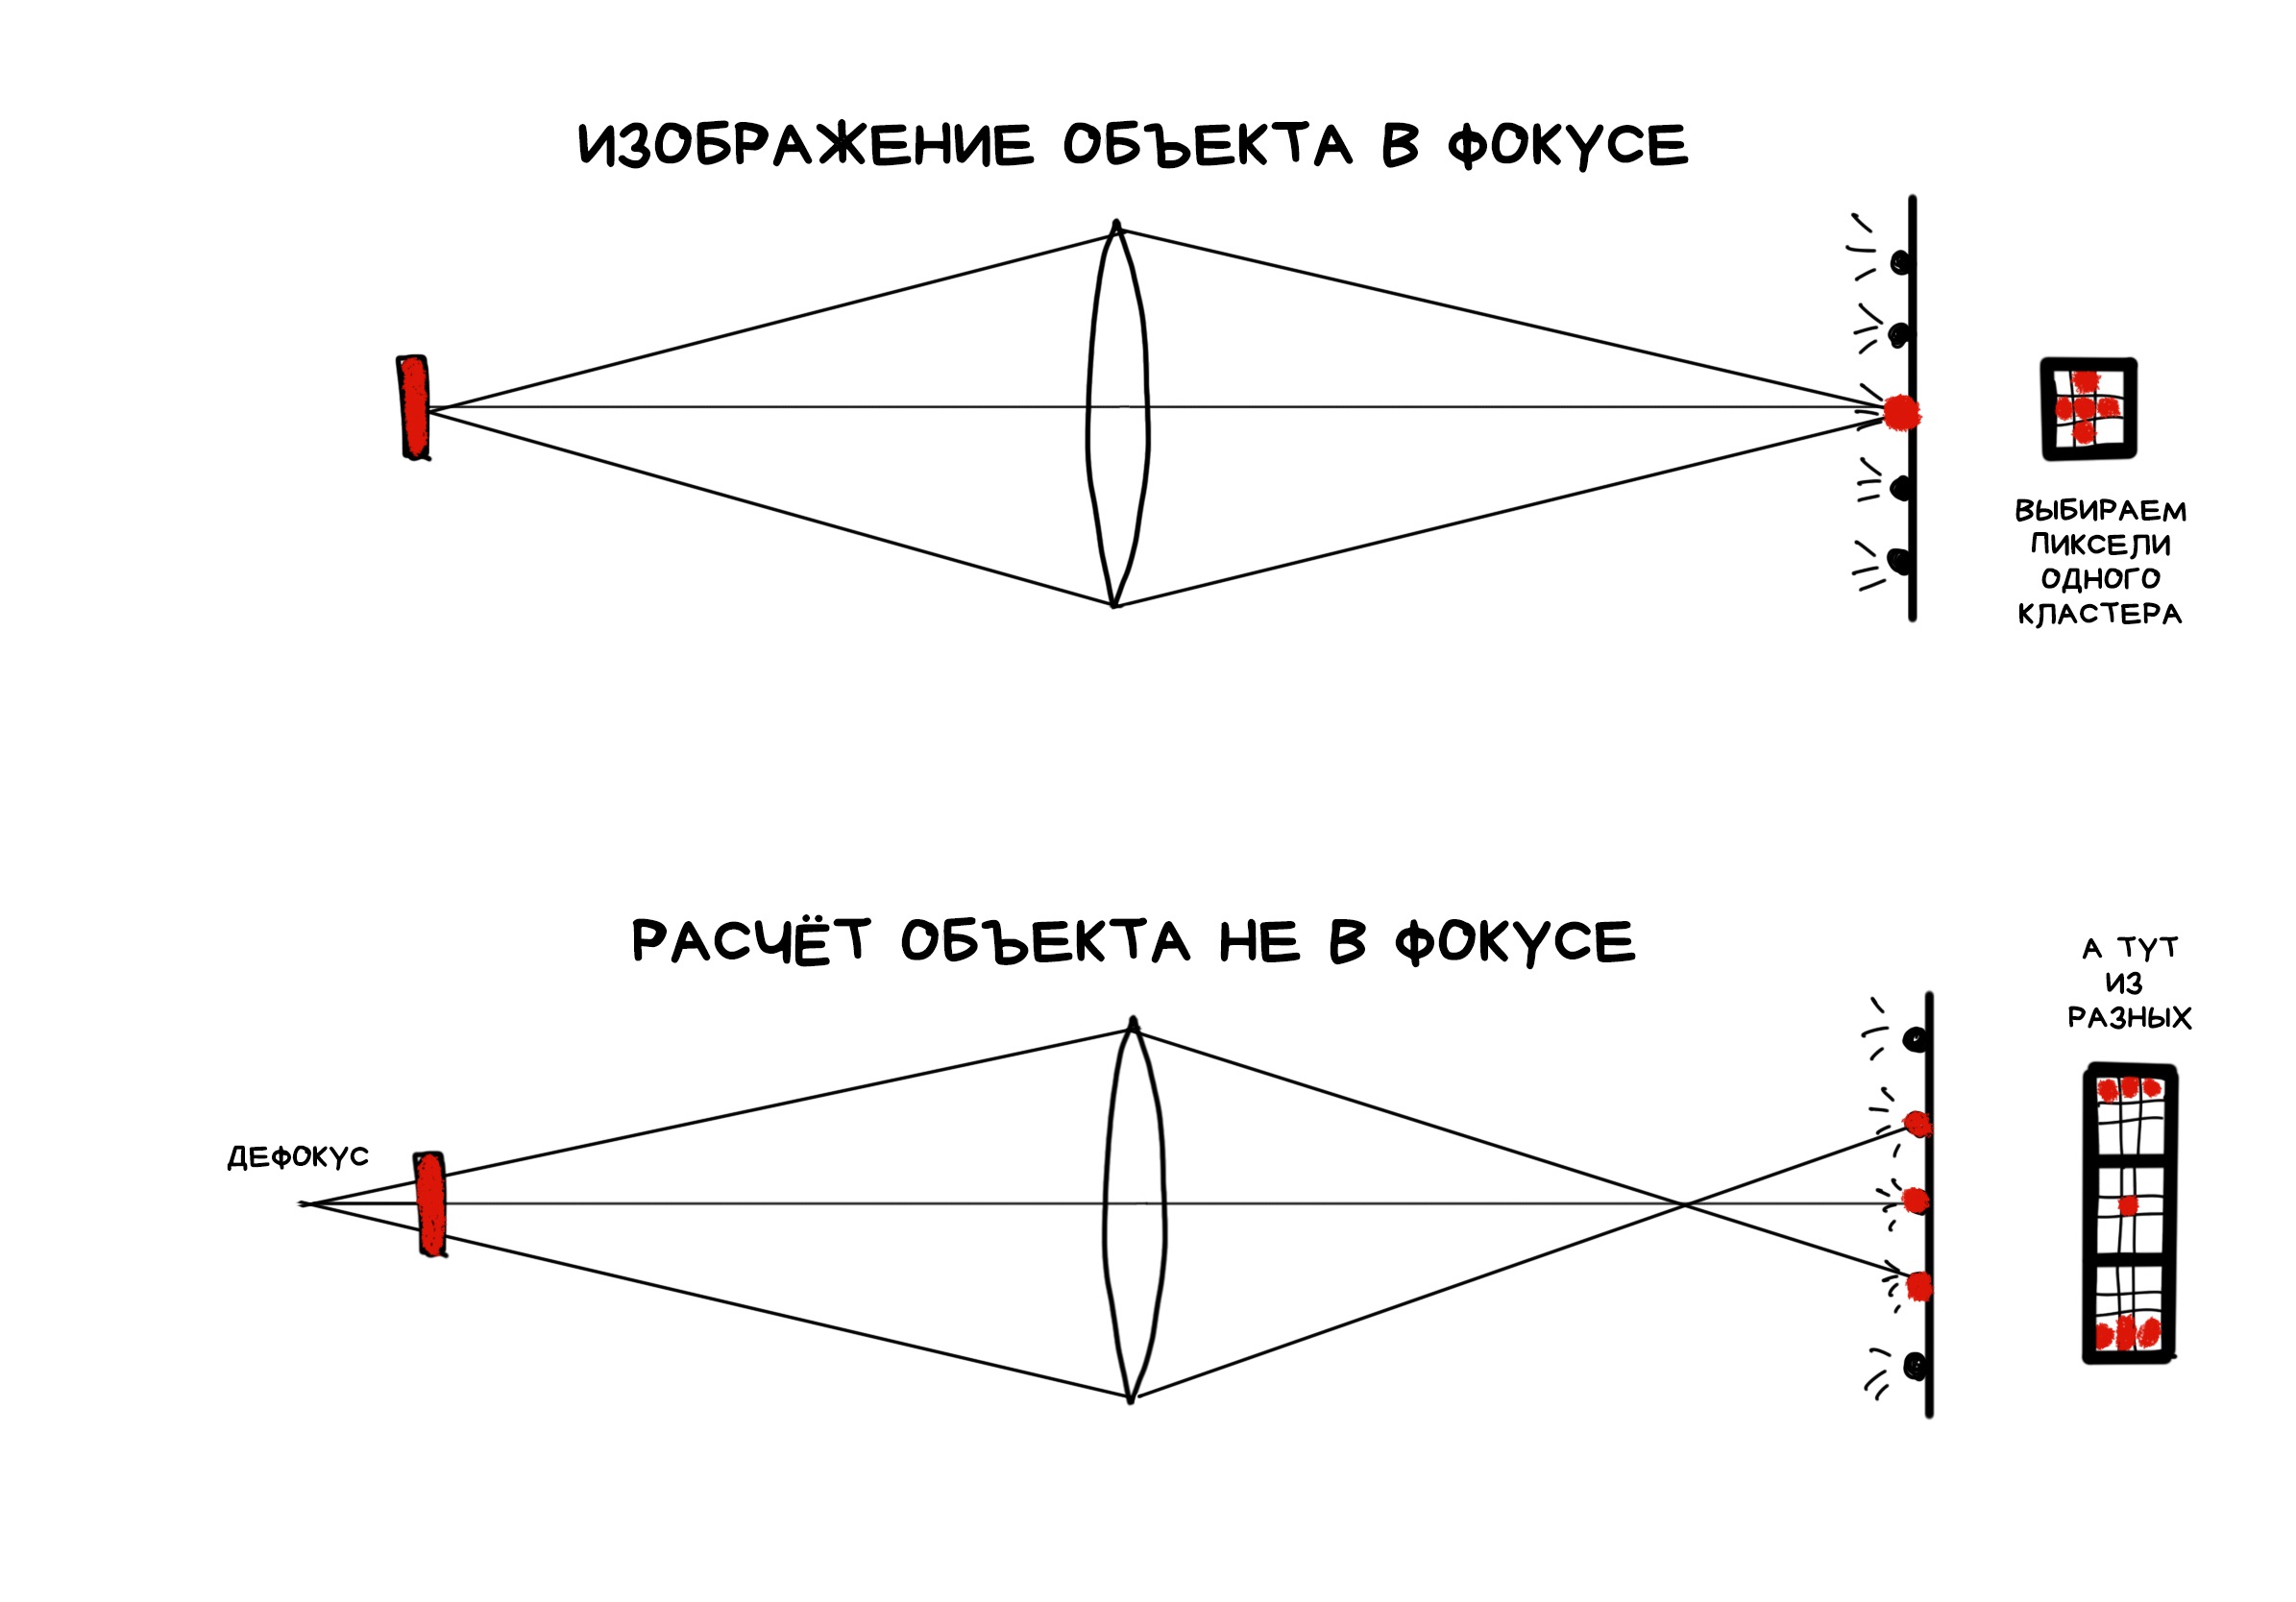
Acercar el enfoque hacia la cámara era más difícil: físicamente había menos píxeles de ese tipo en los grupos. Al principio los desarrolladores ni siquiera querían dejar que el usuario enfocara a mano: la cámara lo decidía por software. A los usuarios no les gustó ese futuro, así que en versiones posteriores del firmware añadieron la función con el nombre de «modo creativo». Eso sí, por esa misma razón dejaron muy limitado el margen de reenfoque.
Una de las operaciones más sencillas en plenóptica es obtener un mapa de profundidad. Basta con armar dos imágenes distintas y calcular cuánto se desplazan los objetos de una a otra. Más desplazamiento, más lejos de la cámara.
Hace poco Google compró Lytro y la liquidó, pero aprovechó su tecnología para sus proyectos de realidad virtual y… para la cámara del Pixel. A partir del Pixel 2 la cámara pasó a ser «un poquito» plenóptica, aunque solo con dos píxeles por grupo. Así Google pudo ahorrarse la segunda cámara que instalaban todos los demás y calcular el mapa de profundidad a partir de una sola foto.
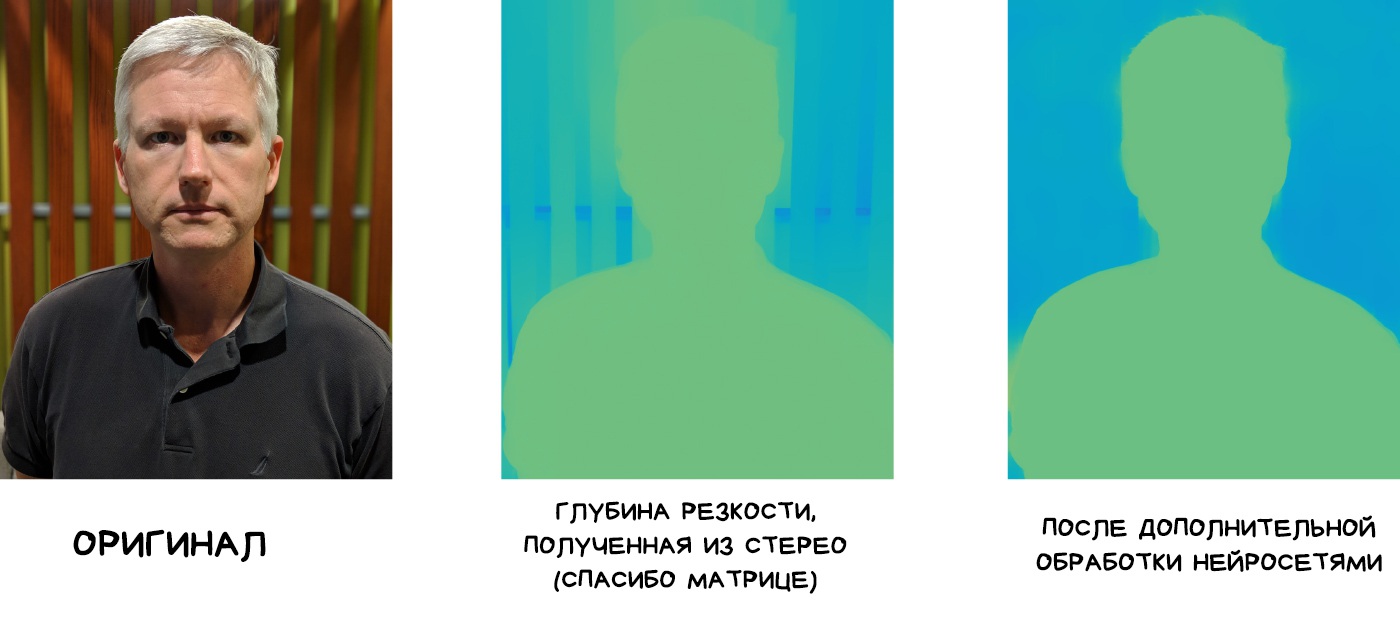
📝 El modo retrato en los smartphones Pixel 2 y Pixel 2 XL
El mapa de profundidad se construye con dos imágenes desplazadas un subpíxel. Eso basta para calcular un mapa de profundidad binario, separar el primer plano del fondo y desenfocar este último con ese bokeh tan de moda. El resultado de la separación en capas se suaviza y se «mejora» con redes neuronales entrenadas para mejorar mapas de profundidad (no para desenfocar, como cree mucha gente).
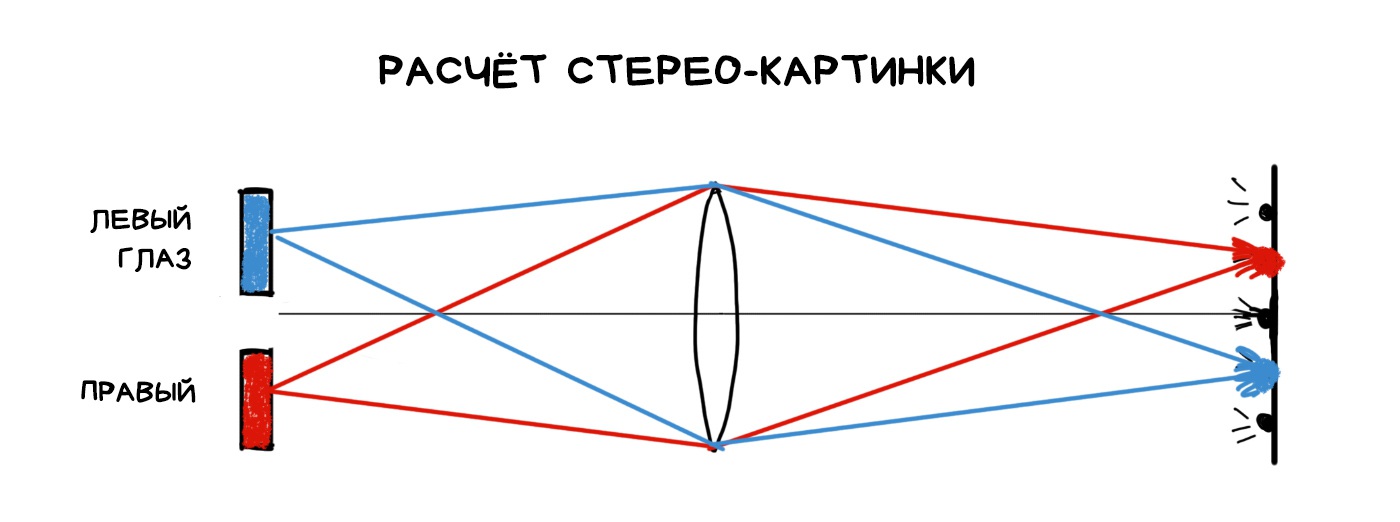
La gracia es que la plenóptica en los teléfonos nos salió casi gratis. Ya poníamos lentes sobre esos sensores diminutos para aumentar aunque fuera un poco el flujo luminoso. Para los próximos Pixel, Google quiere ir más allá y cubrir cuatro fotodiodos con una sola lente.
No ves tu propia nariz porque tu cerebro arma la imagen final combinando lo que ven tus dos ojos. Cierra uno y verás aparecer toda una pirámide egipcia en un extremo.
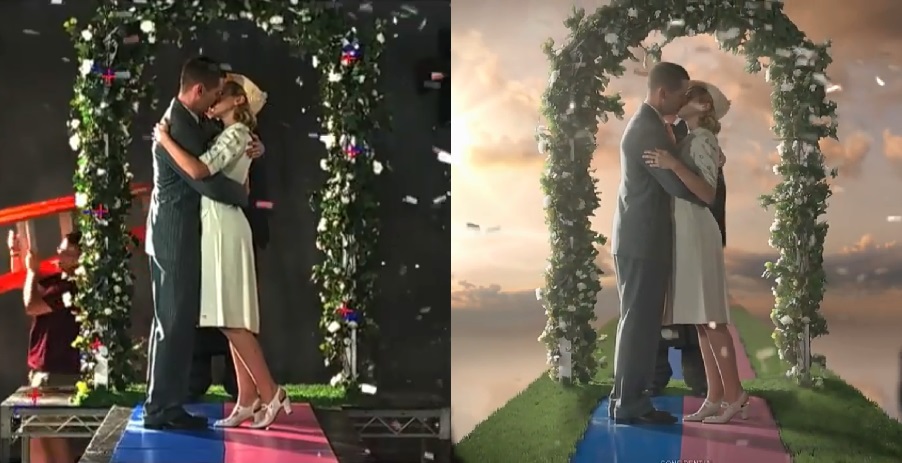
Podemos conseguir el mismo efecto con una cámara plenóptica. Si armamos imágenes desplazadas entre sí con los píxeles de distintos grupos, podemos mirar un objeto como si lo viéramos desde varios puntos. Igual que con nuestros ojos. Eso nos abre dos posibilidades bastante buenas: podemos estimar la distancia a los objetos, lo que nos permite separar fácilmente el primer plano del fondo, como en la vida real. Y si el objeto es pequeño, podemos eliminarlo por completo de la foto. Como la nariz. Por medios ópticos, de verdad y sin Photoshop.
Un par de aplicaciones que se me ocurren: quitar los árboles que se interponen entre la cámara y el sujeto, o eliminar el confeti que cae, como en el vídeo de abajo.
De un RAW plenóptico podemos sacar un centenar de fotos desplazadas unos píxeles a lo largo de toda la superficie del sensor. Es como tener un tubo del diámetro del objetivo dentro del cual podemos mover libremente el punto de vista para compensar el temblor de la imagen.
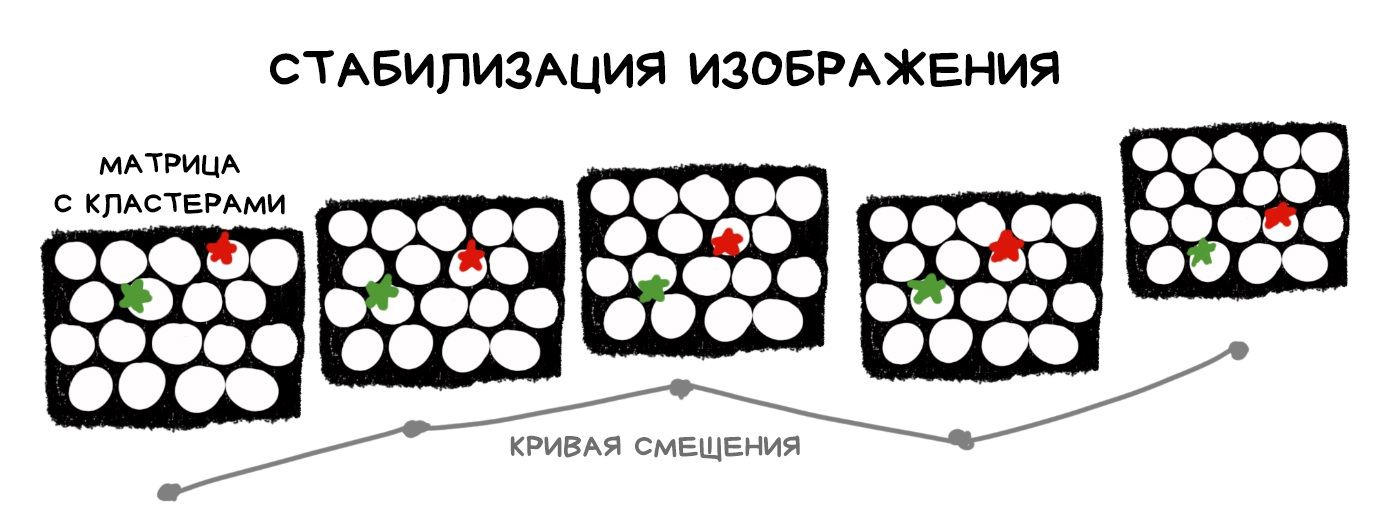
Técnicamente, la estabilización sigue siendo óptica, porque no tenemos que calcular nada: solo elegimos los píxeles en los lugares adecuados. Por otro lado, cualquier cámara plenóptica sacrifica megapíxeles a cambio de sus funciones plenópticas, y cualquier estabilizador digital hace exactamente eso. Vamos, que está bien tener la función de regalo, pero usar la plenóptica solo por ella no parece gran idea.
Cuanto mayores sean el sensor y el objetivo, más margen de movimiento, más posibilidades y más agujeros en la capa de ozono para alimentar y refrigerar todo este circo. ¡Vivaaa la tecnología!
Hasta en una cámara plenóptica sigue siendo necesario: aún no se nos ha ocurrido otra forma de conseguir una imagen digital en color. A cambio, ya no tenemos que promediar el color usando solo el puñado de píxeles vecinos, como en el desmosaicado clásico; también podemos usar las decenas de copias del mismo píxel que hay en los grupos de al lado.
En los artículos lo llaman «superresolución computacional», pero aquí vuelvo a tener mis dudas: primero dividimos la resolución real del sensor por esas mismas decenas para luego recuperarla tan orgullosos. A ver quién consigue venderle eso a alguien.
Aunque desde el punto de vista técnico sigue siendo más interesante que poner a temblar el sensor en un ataque de Pixel Shifting.
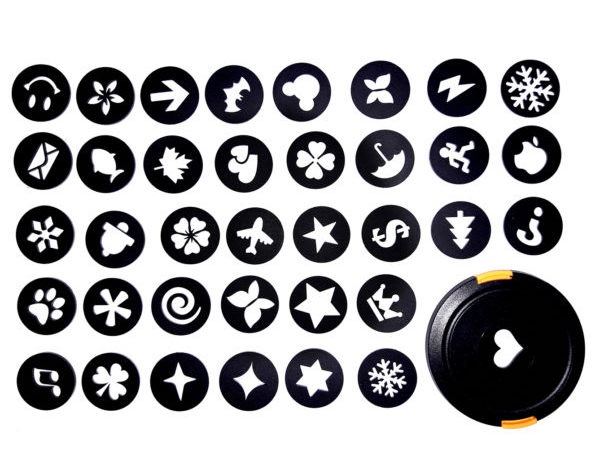
Los amantes del bokeh de corazoncitos van a estar encantados. Ya que sabemos controlar el reenfoque, podemos ir un paso más allá: tomar solo algunos píxeles de la imagen desenfocada y los demás de la normal. Así conseguimos un diafragma de la forma que queramos, para alegría de los grupos de fotografía.
Para no apartarme de la fotografía, a quien le interese el tema lo mando a leer y a ver lo que hay en los enlaces de arriba y de abajo. Ahí explican otra media docena de aplicaciones interesantes de la cámara plenóptica.
🎥 Mira cómo Lytro cambia la cinematografía para siempre
Las explicaciones de plenóptica suelen empezar por aquí, pero nunca entendí qué necesidad había de marear a la gente con esto desde el principio. Pues sí, desde el punto de vista de la física, una cámara plenóptica es un instrumento que registra el campo de luz. Hasta el nombre viene de ahí: plenus, «lleno» en latín, porque recoge toda la información sobre los rayos de luz. Como una sesión plenaria.
Veamos en palabras sencillas qué es un campo de luz y para qué lo queremos.
Toda fotografía tradicional es bidimensional: por donde entra el rayo en el objetivo se ilumina un píxel en la foto. A la cámara le importa una mierda de dónde venga ese rayo, si entró por casualidad desde un lado o si se reflejó en el culo de una bella dama. La foto solo registra el punto donde el rayo se cruza con la superficie del sensor.
Una imagen del campo de luz registra lo mismo, pero con un componente nuevo: de dónde llegó ese rayo. En otras palabras, registra el vector del rayo en el espacio. Es como calcular la iluminación de un nivel de un videojuego, pero al revés: intentamos averiguar el modelo de iluminación del mundo real. El campo de luz, entonces, es el conjunto de todos los rayos de luz de nuestra escena. Tanto los que llegan de las fuentes de luz como los reflejados.
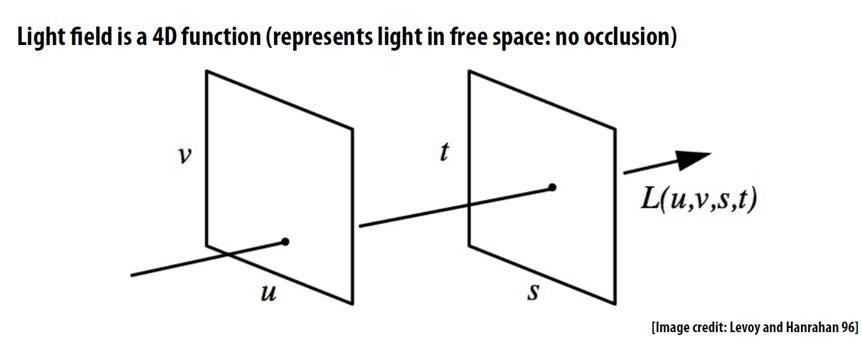
En el fondo, el campo de luz describe visualmente el espacio que nos rodea. Ahora podemos calcular matemáticamente cualquier foto dentro de ese espacio. El punto de vista, la profundidad de campo, la apertura: todo eso también se puede calcular.
Aquí me gusta usar la analogía de una ciudad. La foto es el camino de tu casa al quiosco donde compras cerveza, ese que te sabes de memoria. El campo de luz es el mapa de toda la ciudad. Con el mapa podemos calcular cualquier ruta del punto A al B. Del mismo modo, si conocemos el campo de luz, podemos calcular cualquier foto.
Para una simple foto es matar moscas a cañonazos, pero poco a poco asoma la realidad virtual. Ahí los campos de luz son una de las vías más prometedoras. Una captura del campo de luz permitirá observar un objeto en realidad virtual desde cualquier punto del espacio. Ya no hace falta construir un modelo 3D de una habitación para pasearse por ella: «solo» hay que registrar todos los rayos de luz que hay dentro. Solo, sí. En eso andamos.
📝 Google AR y VR: experimentos con campos de luz
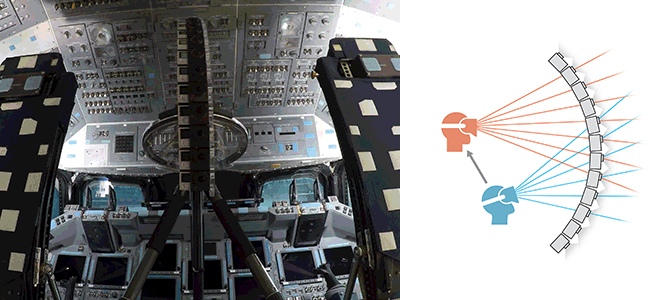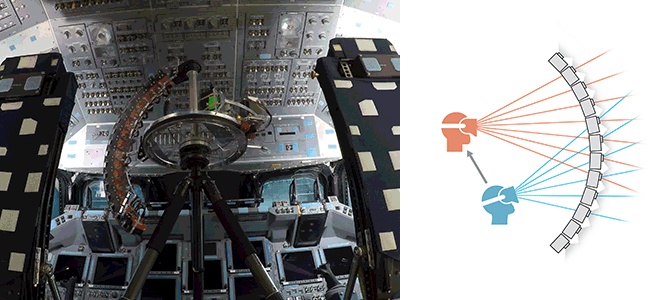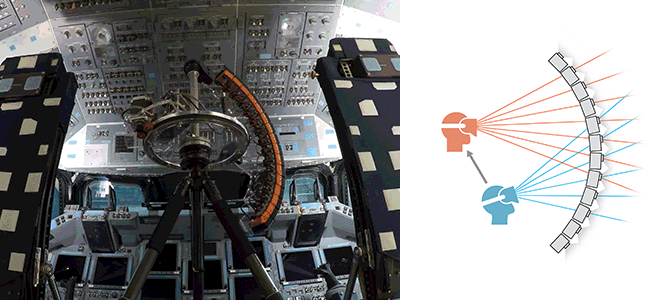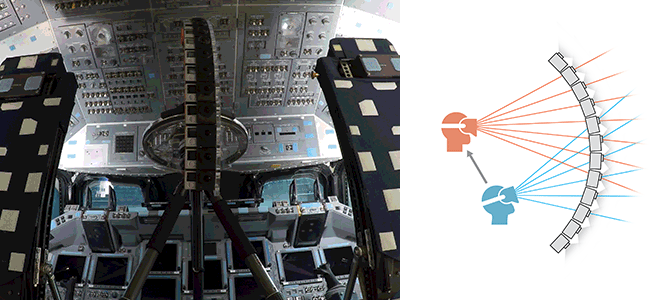
Por óptica, los chicos de Stanford y yo entendemos no solo las lentes y los objetivos, sino todo lo que se interpone entre el objeto y el sensor, incluidos el diafragma y el obturador. Los esnobs de la fotografía estarán que trinan.
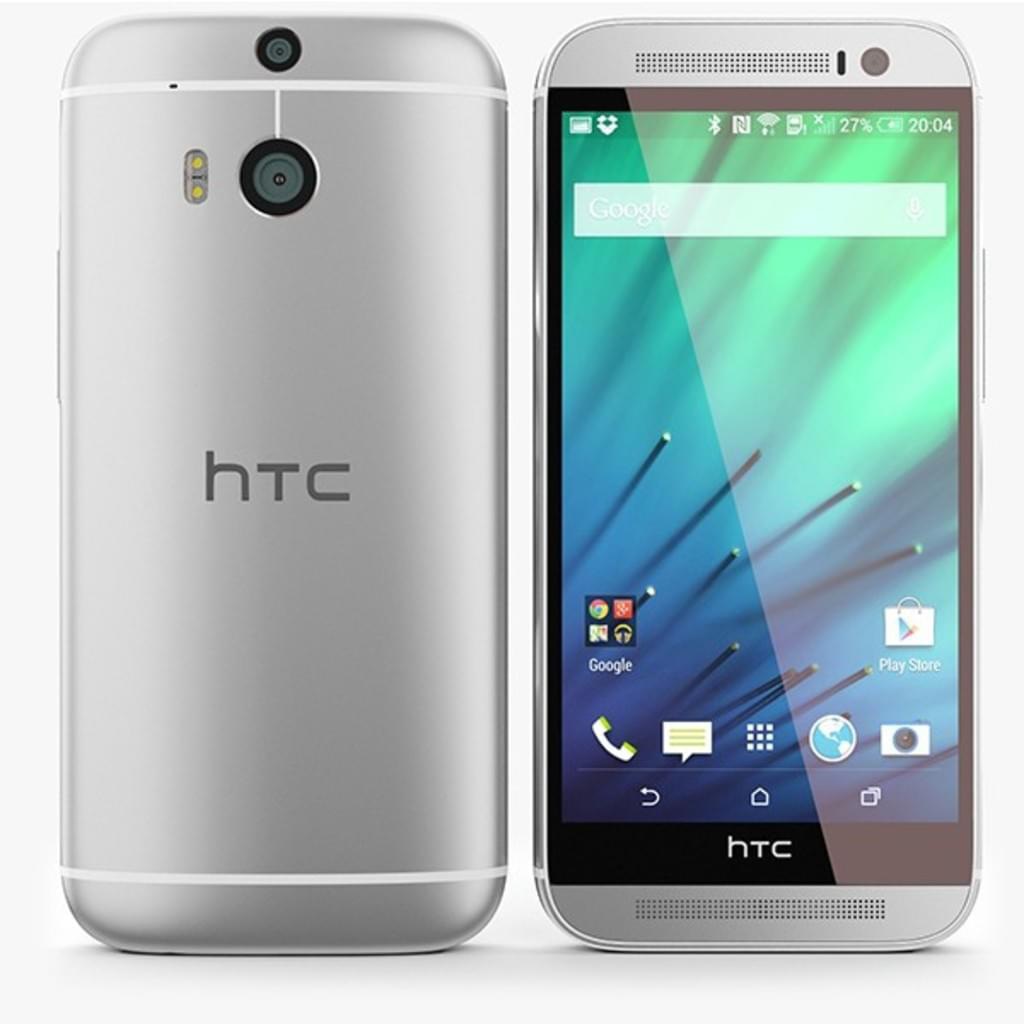
En 2014 salió el HTC One (M8), el primer smartphone con dos cámaras y unas funciones bastante cómicas de fotografía computacional, como cambiar el fondo por lluvia o brillitos, al más puro estilo de los mejores grupos de la red social Odnoklássniki.
Empezó la carrera. Todo el mundo se puso a meter dos, tres, cinco objetivos en sus teléfonos, mientras intentaba decidir qué era mejor, si un teleobjetivo o un gran angular. Y así llegamos a la Light L16, que llevaba, como habrás adivinado, la friolera de 16 objetivos.
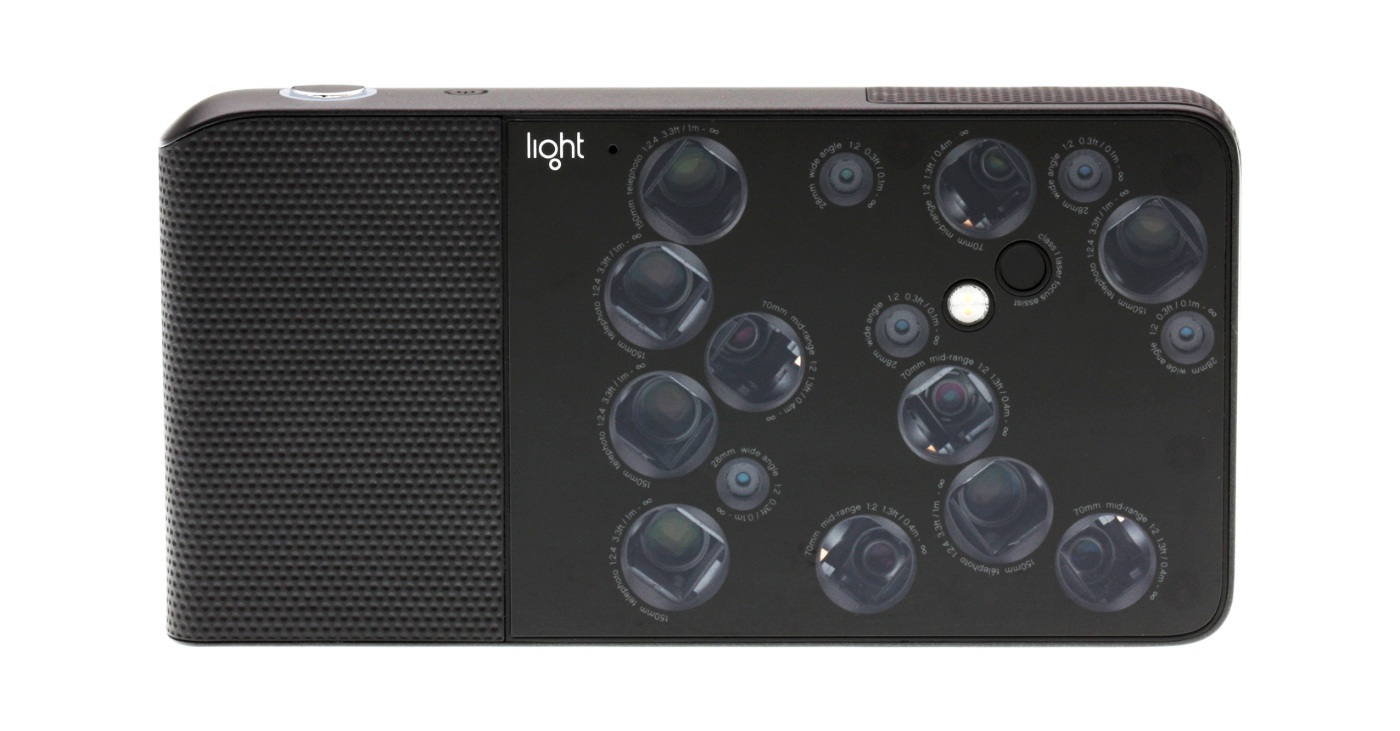
La L16 ya no era un teléfono, sino más bien una nueva especie de cámara de bolsillo. Se vendía como alternativa compacta a la réflex: en vez de conseguir la calidad de imagen con un objetivo luminoso carísimo y un sensor de formato completo, lo hacía con el poder de los algoritmos de fotografía computacional.
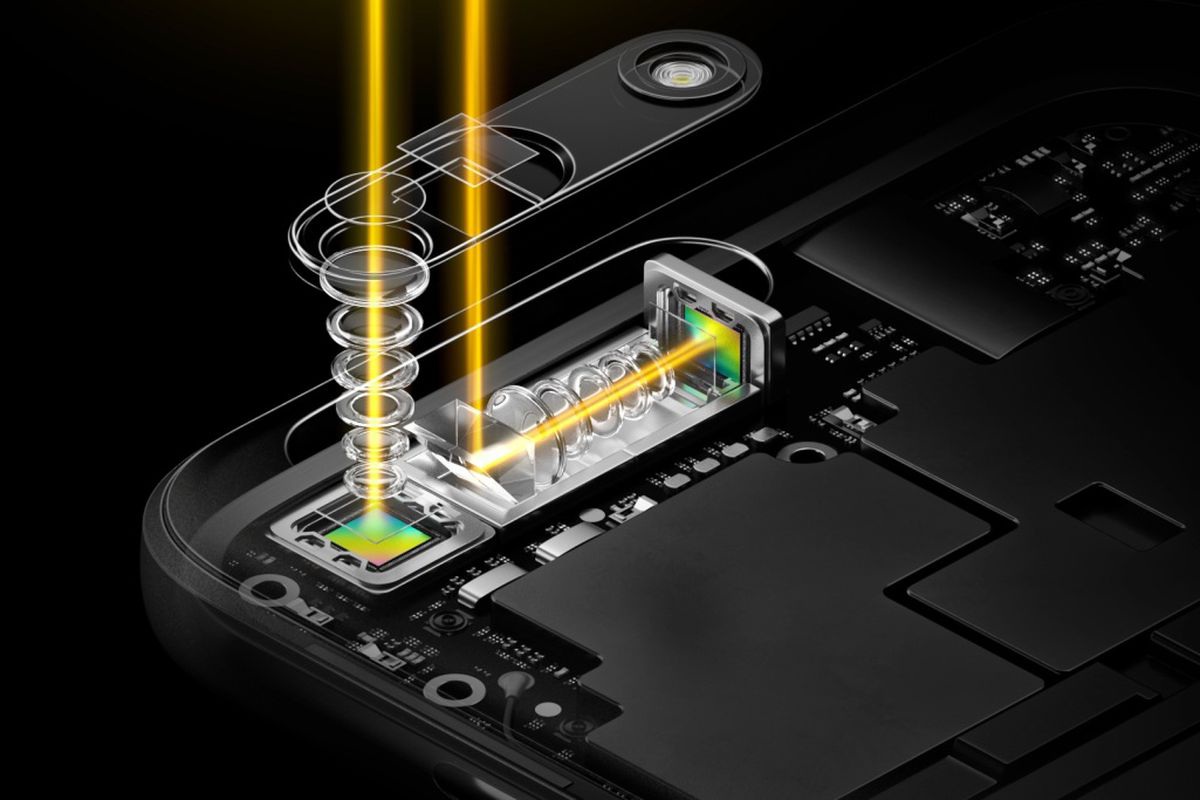
Entre sus 16 objetivos había grandes angulares de 28 mm y teleobjetivos de 70 y 150 mm. Cada teleobjetivo era periscópico: la luz no iba de la lente directamente al sensor, sino que un espejo la desviaba hacia el interior del cuerpo. Así se podía meter un teleobjetivo bastante largo en un cuerpo plano sin que le sobresaliera un tubo. Los chinos hicieron hace poco la misma jugada en el Huawei P30 Pro.
Para cada foto, la L16 disparaba simultáneamente con 10 objetivos o más y luego combinaba las tomas con bastante ingenio para obtener una imagen de 52 megapíxeles. La idea de sus creadores era que, al disparar con varios objetivos a la vez, se podía captar tanta luz como con el gran objetivo de una réflex, esquivando de paso todas las leyes de la óptica y la necesidad de cargar con un catalejo.
Entre las funciones de software de la primera versión estaba la de controlar la profundidad de campo y el enfoque después de hacer la foto: tener tomas desde distintos ángulos permitía calcular la profundidad de la escena y aplicar un desenfoque por software bastante decente. Sobre el papel sonaba bien y, antes del lanzamiento, hasta teníamos esperanzas de un luminoso futuro computacional.
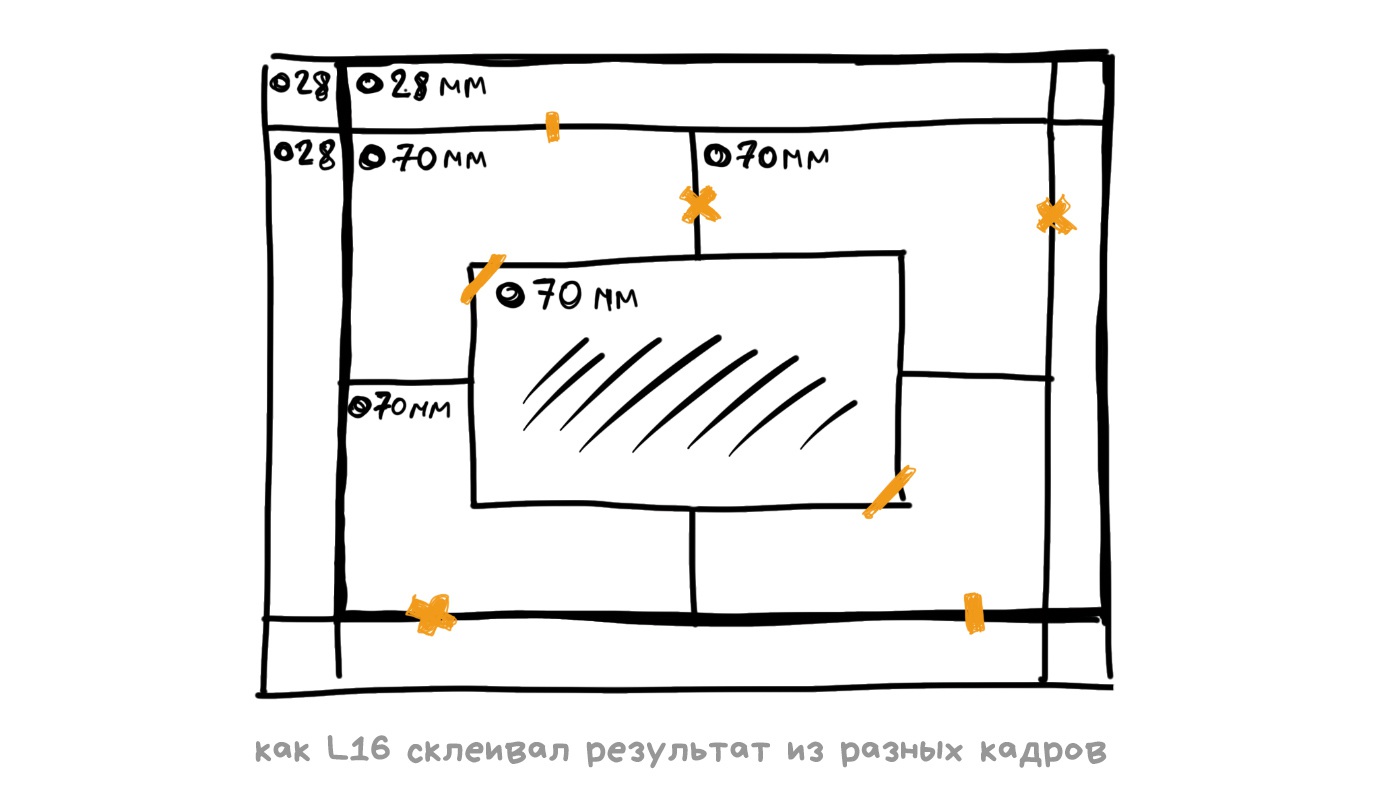
En marzo de 2018 la Light L16 salió al mercado y… fracasó estrepitosamente. Tecnológicamente sí que vivía en el futuro, pero costaba 2000 dólares y no tenía ni rastro de estabilización óptica, así que las fotos salían movidas todo el tiempo (nada raro con objetivos de 70-150 mm). El enfoque automático era demasiado lento, al unir varias tomas aparecían saltos de nitidez rarísimos y a oscuras la cámara era directamente inútil porque no tenía algoritmos como HDR+ o Night Sight de Google. Las compactas modernas de 500 dólares con soporte RAW le daban una paliza de entrada, así que en cuanto vendieron el primer lote dejaron de venderla.
Eso sí, Light no cerró. Al contrario: consiguió dinero y sigue trabajando en la nueva versión con el doble de ganas. Su tecnología, por ejemplo, se usó en el reciente Nokia 9, la pesadilla de cualquiera con tripofobia. A ver con qué más nos sorprenden, porque la idea da para mucho.
🎥 Análisis de la Light L16: locura óptica
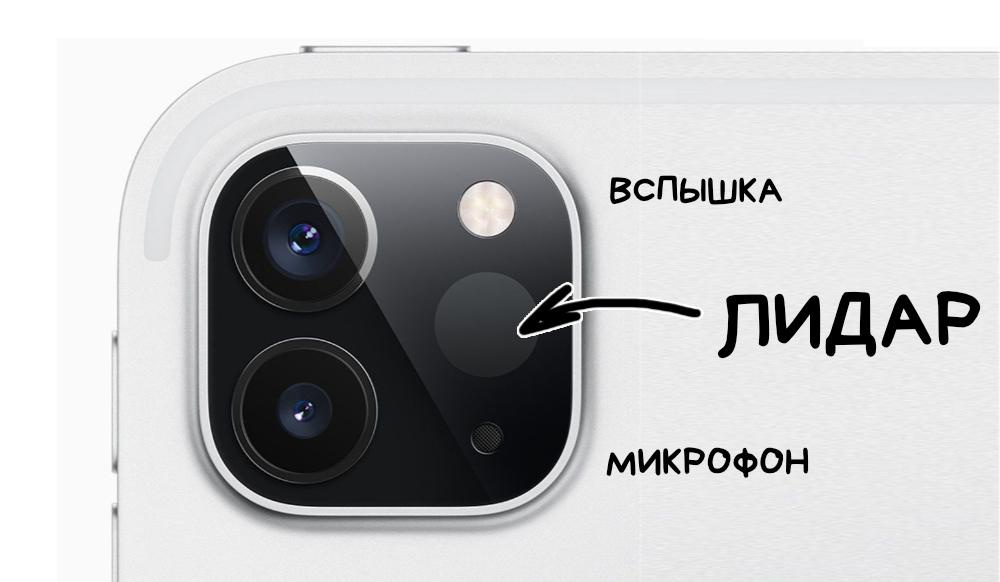
Un lidar es un aparato independiente que mide la distancia a un objeto. Lo habitual es que emita un pulso de luz y mida cuánto tarda en volver. Los avances en lidares se los debemos al furor de los últimos años por los coches autónomos. Esos cacharros raros que giran sobre sus techos son precisamente lidares.
Todavía no cabe un lidar láser en un smartphone, así que por ahora nos apañamos con su hermano pequeño: la cámara de tiempo de vuelo. El principio es ridículamente sencillo: una cámara aparte con un flash LED encima. La cámara emite muchos pulsos, registra a qué objetos llega primero la luz y con eso construye un mapa de profundidad de la escena.
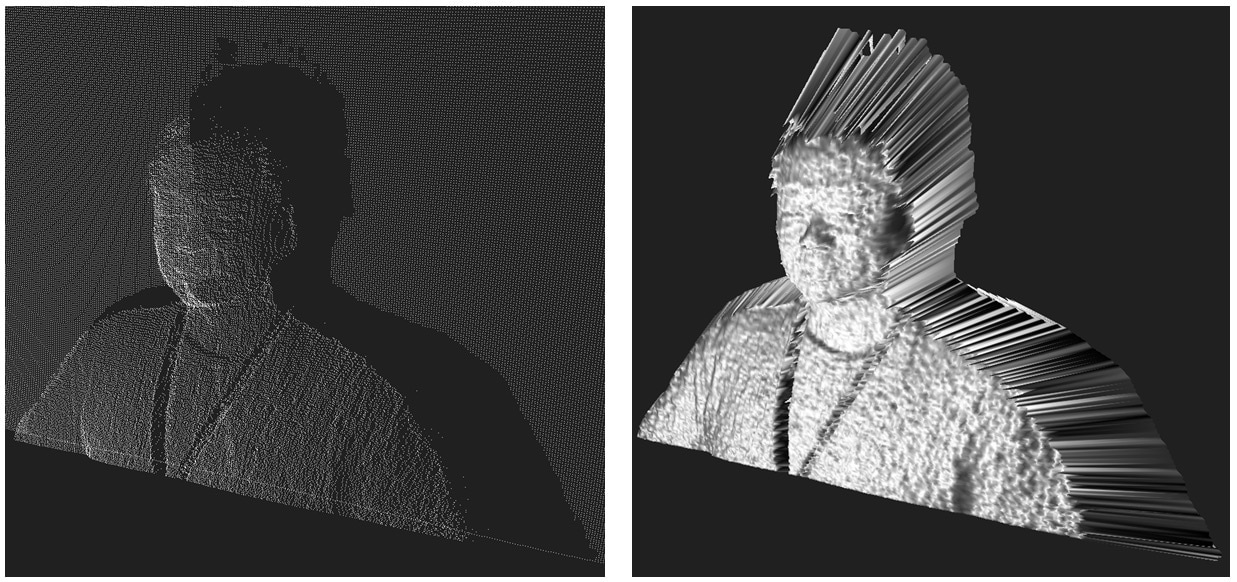
La precisión de los lidares de los teléfonos llega al centímetro. Los modelos de gama alta los usan para crear un mapa de bokeh y mejorar el enfoque automático en la oscuridad.
Conocer la profundidad exacta de la escena nos vendrá bien en la era de la realidad aumentada que se avecina: lanzar pulsos con el lidar contra las superficies para levantar un primer mapa 3D es mucho más preciso y sencillo que analizar imágenes de cámaras.
Los lidares se instalan en los teléfonos principalmente por tres motivos:
En mi otro artículo sobre realidad aumentada cuento con más detalle cómo funciona todo esto.
Entramos en territorio de telescopios, rayos X y demás niebla de guerra. No vamos a adentrarnos mucho, pero mejor abrocharse el cinturón de antemano. La historia de las aperturas codificadas empezó allí donde era físicamente imposible enfocar los rayos: con la radiación gamma y los rayos X. Pregúntale al profesor de física más cercano y te explicará por qué.
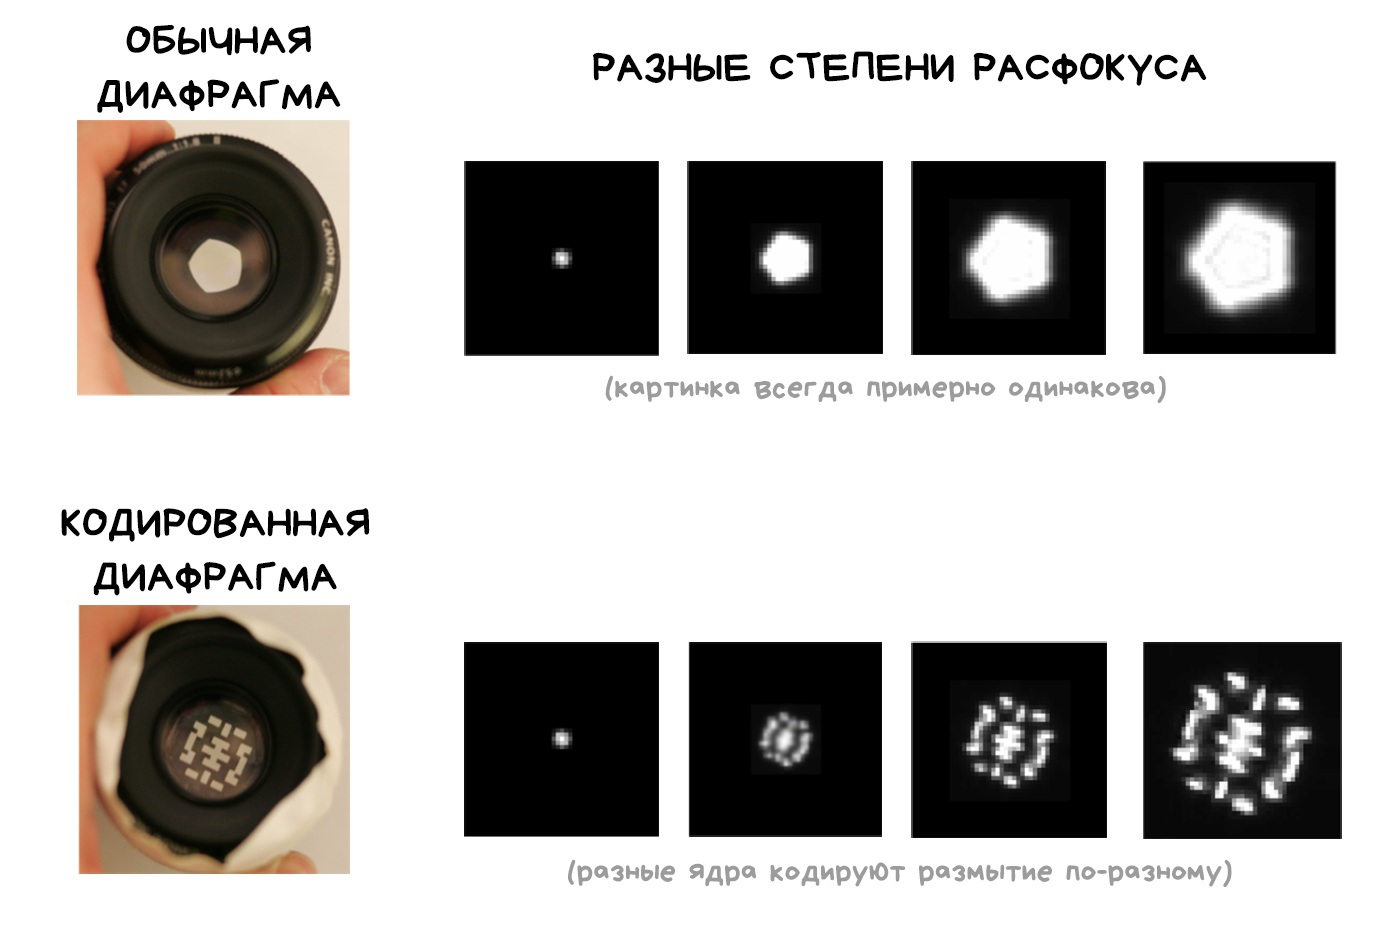
La idea de la apertura codificada es cambiar el agujero habitual del diafragma por un patrón. Los orificios deben disponerse de forma que el aspecto del conjunto varíe lo máximo posible según el grado de desenfoque. Cuanta más variedad, mejor. Los astrónomos han inventado una montaña de patrones así para sus telescopios. Aquí va el más clásico.
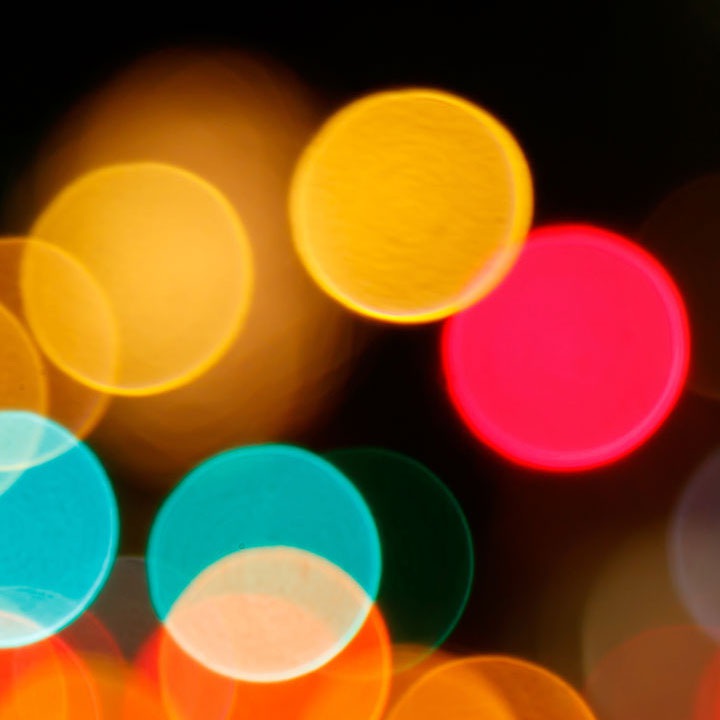
Cuando enfocamos un objeto, todo lo que queda fuera de la profundidad de campo se ve borroso. Físicamente, el desenfoque consiste en que la lente, por estar fuera de foco, proyecta un solo punto sobre varios píxeles del sensor. Así es como una farola se convierte en una tortita redonda de bokeh.
Los matemáticos llaman a estas operaciones convolución (convolution) y deconvolución (deconvolution). ¡Recordemos esas palabras, que suenan de maravilla!
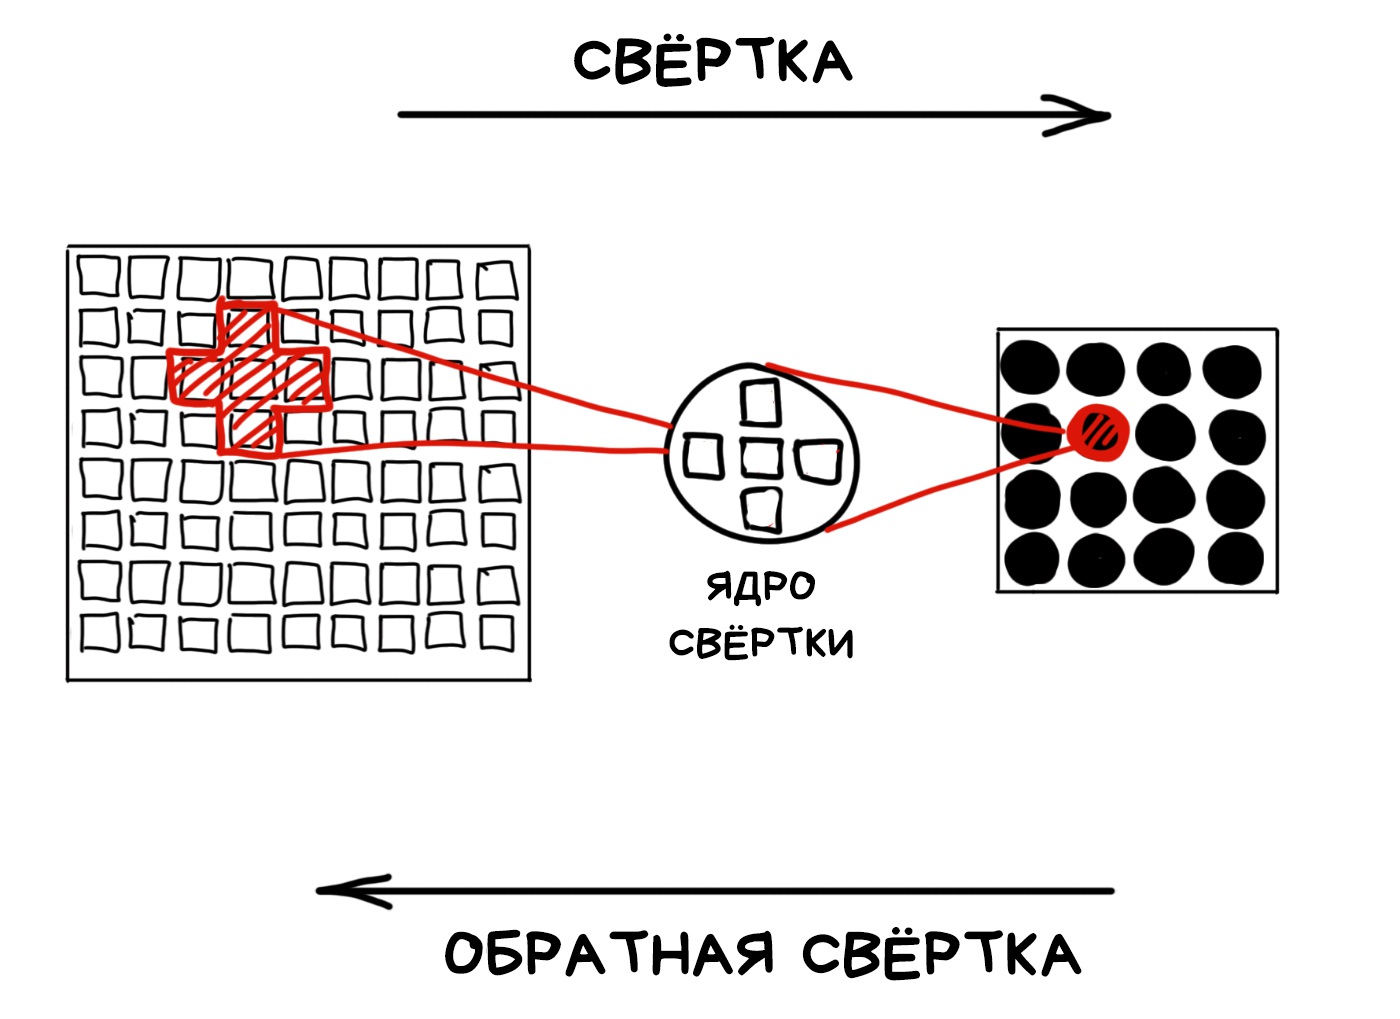
Técnicamente, podemos invertir cualquier convolución si conocemos el núcleo. Eso dicen los matemáticos. En la realidad, el rango del sensor es limitado y las lentes del objetivo no son perfectas. Así que nuestro bokeh dista mucho del ideal matemático y es imposible recuperar la imagen por completo.
📝 Vladímir Yúzhikov: restauración de imágenes desenfocadas y movidas
Aun así podemos intentarlo si averiguamos cuál es el núcleo de convolución. No te voy a tener en suspenso: en fotografía, ese núcleo es precisamente la forma de la apertura. El diafragma realiza una convolución matemática por medios puramente ópticos.
El problema es que una apertura circular sigue siendo circular sea cual sea el grado de desenfoque. Nuestro núcleo es siempre más o menos el mismo: es estable, pero no muy útil. Con una apertura codificada, los rayos con distintos grados de desenfoque quedarán codificados con núcleos diferentes. Los lectores con un CI > 150 ya habrán adivinado lo que viene.
Solo queda un problema: averiguar con qué núcleo está codificada cada zona de la imagen. Podríamos hacerlo a mano, probando núcleos y viendo con cuál encaja mejor la convolución, pero no es nuestro estilo. ¡Hace muchísimo que los humanos inventamos para eso la transformada de Fourier! Para no torturar a nadie con las matemáticas, dejo un enlace a mi explicación favorita para quien de verdad tenga curiosidad.
🎥 Pero ¿qué es la transformada de Fourier? Una introducción visual
Para los mortales, basta con saber que la transformada de Fourier permite extraer de un montón de ondas superpuestas los patrones que predominan. En música, Fourier nos mostrará las frecuencias de las notas de un acorde complejo; en fotografía, el patrón predominante con que se superpusieron un montón de ondas de luz. O sea, el núcleo de convolución. Listo.
Y como la forma que dibuja la apertura codificada cambia con la distancia al objeto, ¡podemos calcular esa distancia por medios puramente matemáticos a partir de una sola foto hecha con un sensor normal!
Si aplicamos la deconvolución con ese núcleo, podemos recuperar las zonas borrosas de la imagen. Volver a poner en su sitio todos los píxeles que habían quedado desparramados, por así decirlo.
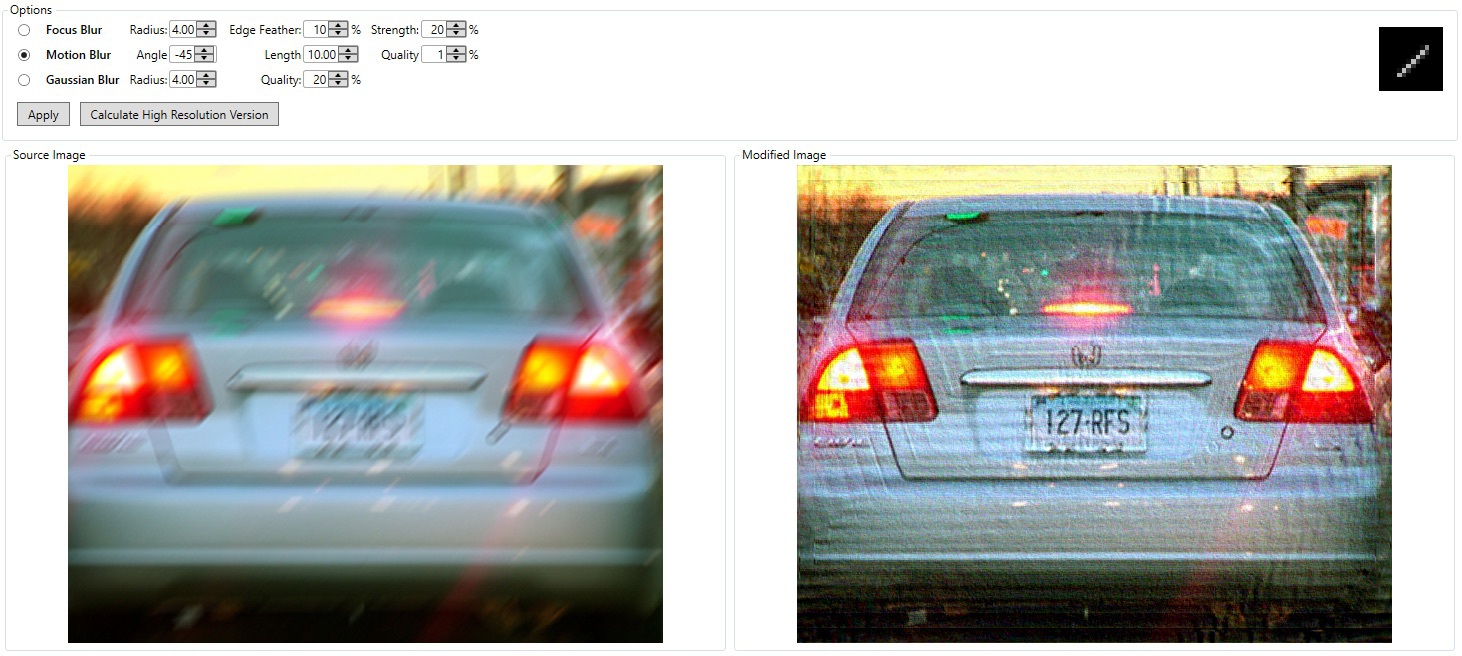
Así funcionan la mayoría de las herramientas para corregir el desenfoque. El truco sirve incluso con una apertura circular normal, pero el resultado es menos preciso.
La pega de las aperturas codificadas es que se pierde luz y aparece ruido, dos cosas que todavía no podemos permitirnos ignorar. La llegada de los lidares y de las cámaras ToF con una precisión bastante buena terminó de enterrar la idea de usar aperturas codificadas en aparatos de consumo. Si has visto alguna por ahí, cuéntalo en los comentarios.
📝 Imagen y profundidad con una cámara convencional de apertura codificada
📝 Apertura codificada. Fotografía computacional, semestre de invierno 07/08
🎥 Proyección con apertura codificada (charlas de SIGGRAPH 2008)
Según la última norma estatal rusa, la luz es medio onda. Al codificar la apertura controlábamos la transparencia de la lente, lo que, traducido al idioma de las ondas, significa que controlábamos la amplitud. Además de la amplitud está la fase, y también se puede codificar.
Para eso se usa una lente adicional que invierte la fase de la luz que la atraviesa. Como en la portada de Pink Floyd, sí.
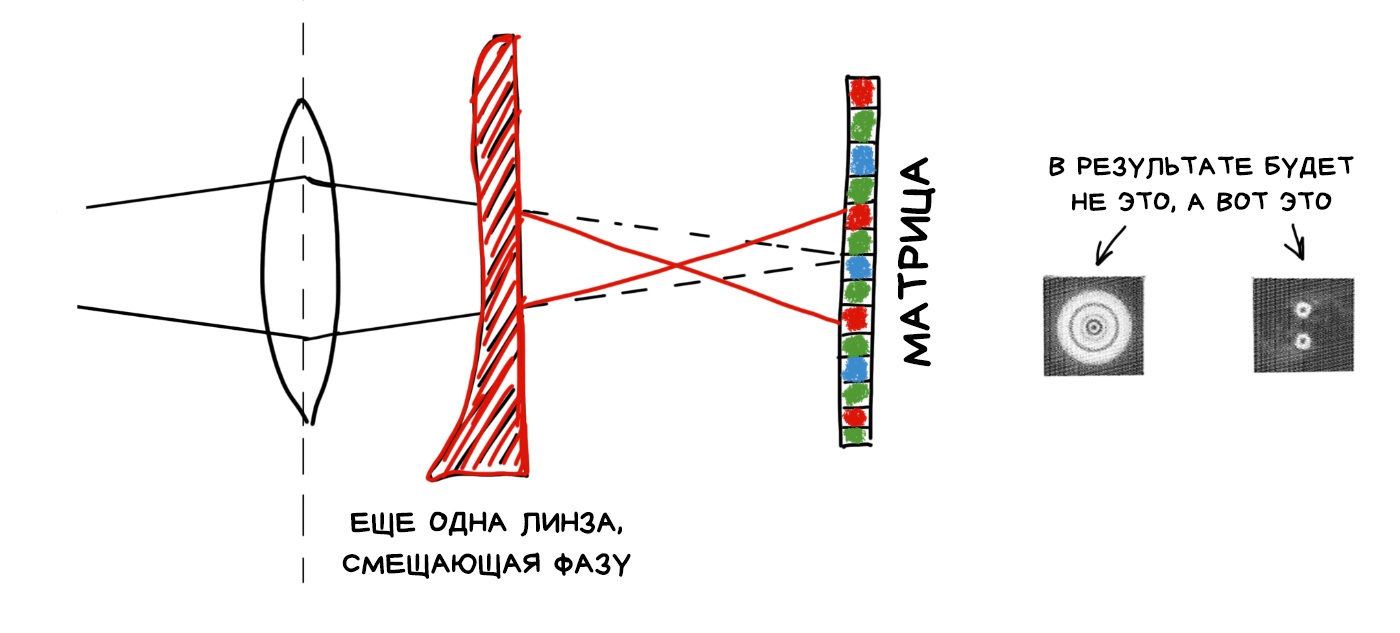
A partir de ahí funciona como cualquier otra codificación óptica. Las distintas zonas de la imagen quedan codificadas de distintas maneras, y podemos reconocerlas mediante algoritmos y hacerles algún arreglo. Desplazar el enfoque, por ejemplo.
La ventaja de la codificación de fase es que no perdemos luminosidad. Todos los fotones llegan sanos y salvos al sensor, a diferencia de lo que pasa con la apertura codificada, donde chocan contra las partes opacas (porque, según la segunda mitad de la norma, la luz es una partícula).
La desventaja es que siempre perdemos nitidez, porque incluso los objetos perfectamente enfocados quedan difuminados de manera uniforme sobre el sensor y no nos queda más remedio que llamar a Fourier para que nos los recomponga. Abajo dejo un enlace con una descripción más detallada y fotos de ejemplo.
📝 Óptica computacional, por Jongmin Baek, 2012
Lo último que podemos codificar en el camino de la luz hasta el sensor es el obturador. En lugar del ciclo habitual de «abrir, esperar, cerrar», lo abriremos y cerraremos varias veces durante una toma hasta sumar el tiempo de exposición deseado. Casi como en una exposición múltiple, cuando un mismo fotograma se expone varias veces.
Imagina que queremos fotografiar de noche un coche que pasa a toda velocidad y luego leer su matrícula. No tenemos flash, y una exposición larga tampoco nos sirve porque todo saldrá movido. Nos toca acortar la exposición, pero por ese camino acabaremos con una foto completamente negra sin haber reconocido siquiera el coche. ¿Qué hacemos?
Podemos hacer la misma toma con varios movimientos del obturador, de manera que el rastro del coche no sea uniforme, sino que forme una especie de escalera con pasos que conocemos de antemano. Siempre que no vaya a la velocidad del Lada 2114 del barrio con la suspensión rebajada, claro, pero la ciencia ignora ese caso.
Así hemos codificado la estela con una secuencia aleatoria de aperturas y cierres del obturador y podemos intentar descodificarla con la deconvolución de antes. Resulta que funciona muchísimo mejor que intentar recuperar así unos píxeles que una exposición larga ha emborronado de manera uniforme.
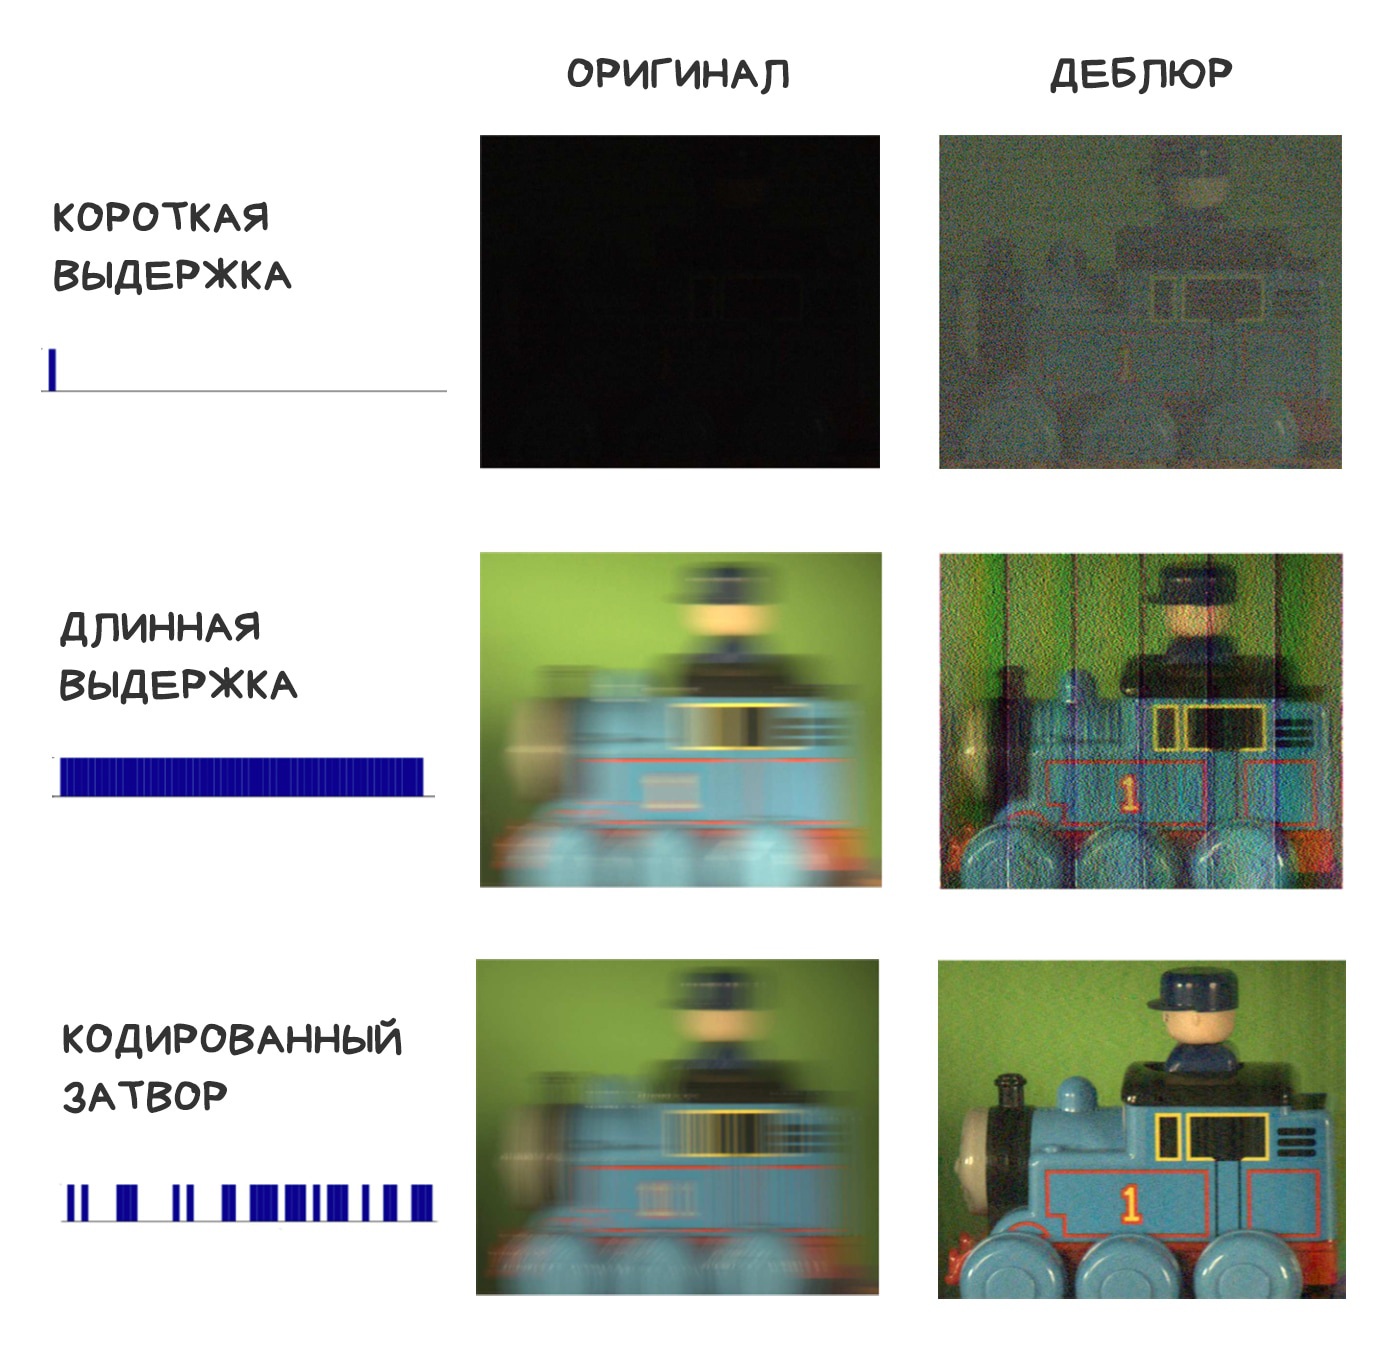
Se han inventado varios algoritmos para hacerlo. Para los detalles más duros, vuelvo a dejar enlaces a las publicaciones de unos indios que saben mucho del tema.
📝 Fotografía de exposición codificada: corrección del desenfoque de movimiento mediante un obturador intermitente
🎥 Filtro codificado con obturador intermitente
Pronto estaremos tan malacostumbrados que querremos controlar hasta la iluminación en posproducción. Cambiar un día nublado por uno soleado o equilibrar las sombras de una cara después de hacer la foto: ahora parece una barbaridad, pero ya hablaremos en diez años.
Ya inventamos un aparato bastante tonto para controlar la iluminación literalmente «de frente»: el flash. Al principio hacía falta por las limitaciones técnicas de las cámaras. Luego el enemigo empezó a instalarlo en todas las compactas para arruinarte las fotos familiares. Y en la era del smartphone lo usamos todos de linterna.
De momento, nuestros avances hacia la iluminación computacional son bastante caóticos y poca gente los entiende.
A los Nokia de antes les encantaba presumir de flashes de xenón que se comían un uno por ciento de batería por foto. Hoy la vida es más aburrida y todos llevan un simple LED de bajo consumo. Un LED no da para mucha fiesta, pero lo intentamos igualmente.
Para empezar, todos nos pasamos a los flashes LED dobles: una combinación de un LED naranja y otro azul cuyas intensidades se ajustan para intentar igualar la temperatura de color de la escena. En el iPhone se llama True Tone y lo controla un trocito de código con una fórmula bastante ingeniosa. Ni a los desarrolladores les dejan tocarlo.
📝 El misterio del flash ámbar del iPhone
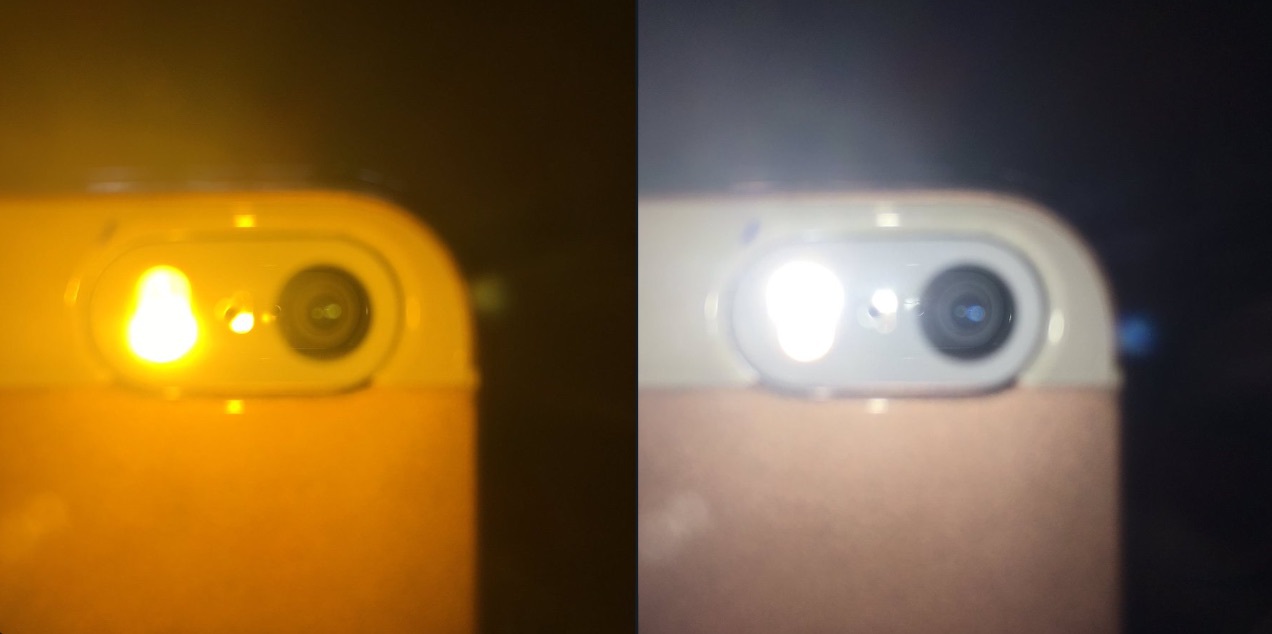
Cuando los teléfonos empezaron a llevar sensores de profundidad y redes neuronales, quisimos usarlos para resolver el gran problema de todos los flashes: las caras quemadas y, en general, todo el primer plano. Cada uno lo hizo a su manera. En el iPhone apareció el flash de sincronización lenta: la cámara alargaba el tiempo de exposición a propósito cuando había poca luz. En el Google Pixel y otros Android apareció un algoritmo que combinaba tomas con y sin flash. El teléfono hace dos fotos seguidas, una con flash y otra sin él. Toma las zonas más cercanas a la cámara de la foto sin flash y los detalles iluminados del fondo de la foto con flash. Así la iluminación queda más o menos uniforme.
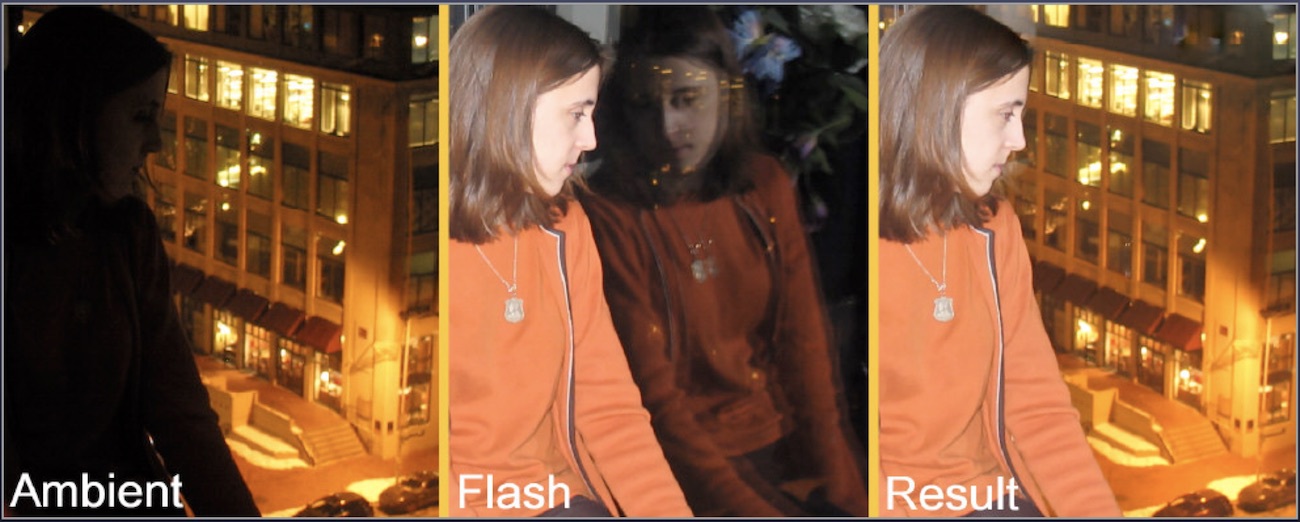
El futuro de los flashes múltiples programables no está muy claro. Donde sí les encontraron una aplicación interesante fue en visión por computador, cuando hacía falta detectar con mayor precisión los bordes de los objetos. Por ejemplo, así se puede hacer un diagrama de montaje de un armario de IKEA.
La luz siempre ha sido lo más fácil de codificar. Podemos cambiar la iluminación cien veces por fotograma y aun así ni nos acercamos a la velocidad a la que va la luz. Así que ya en aquel lejano 2005 a estos chicos se les ocurrió Lightstage.
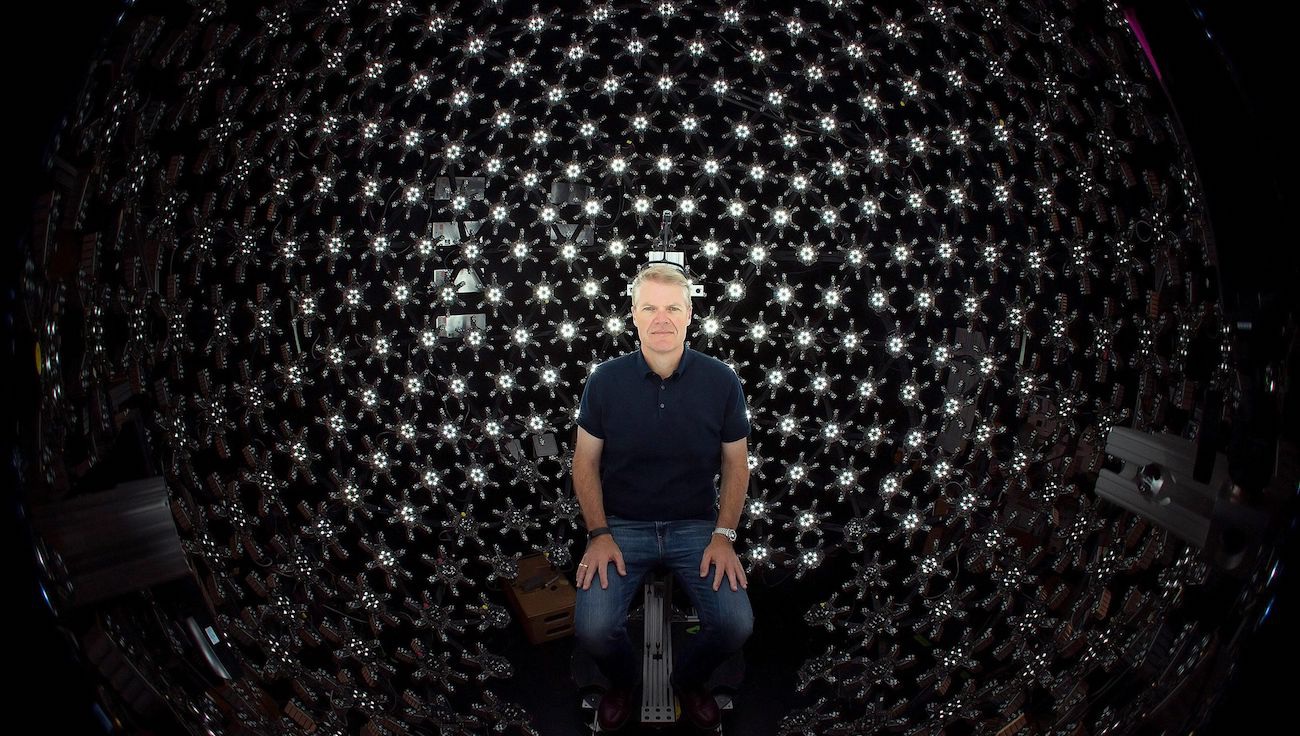
🎥 Vídeo de demostración de Lightstage
La idea es que en lo que dura cada fotograma de una película normal de 24 fps dé tiempo a iluminar al sujeto desde todos los ángulos posibles. Para eso se usan más de 150 lámparas y una cámara de alta velocidad que, por cada fotograma de la película, captura cien imágenes con distinta iluminación. Así de tontas parecen todas las innovaciones en cuanto te pones a explicarlas.
Hoy se usa algo parecido cuando el cine combina rodajes reales con imágenes generadas por ordenador. Permite controlar por completo la iluminación del sujeto en posproducción y meterlo en escenas iluminadas de cualquier manera. Tomas los fotogramas en los que la luz viene de los lados que te interesan, les ajustas un poco el tono y listo.
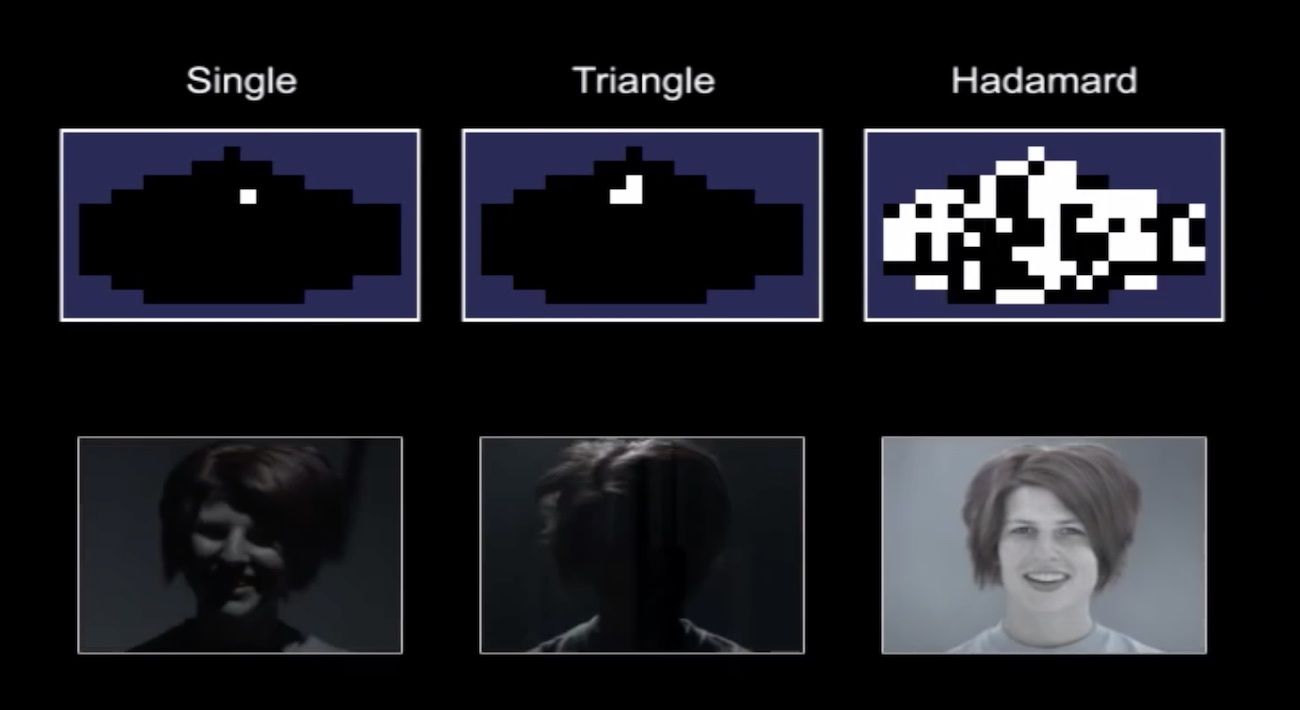
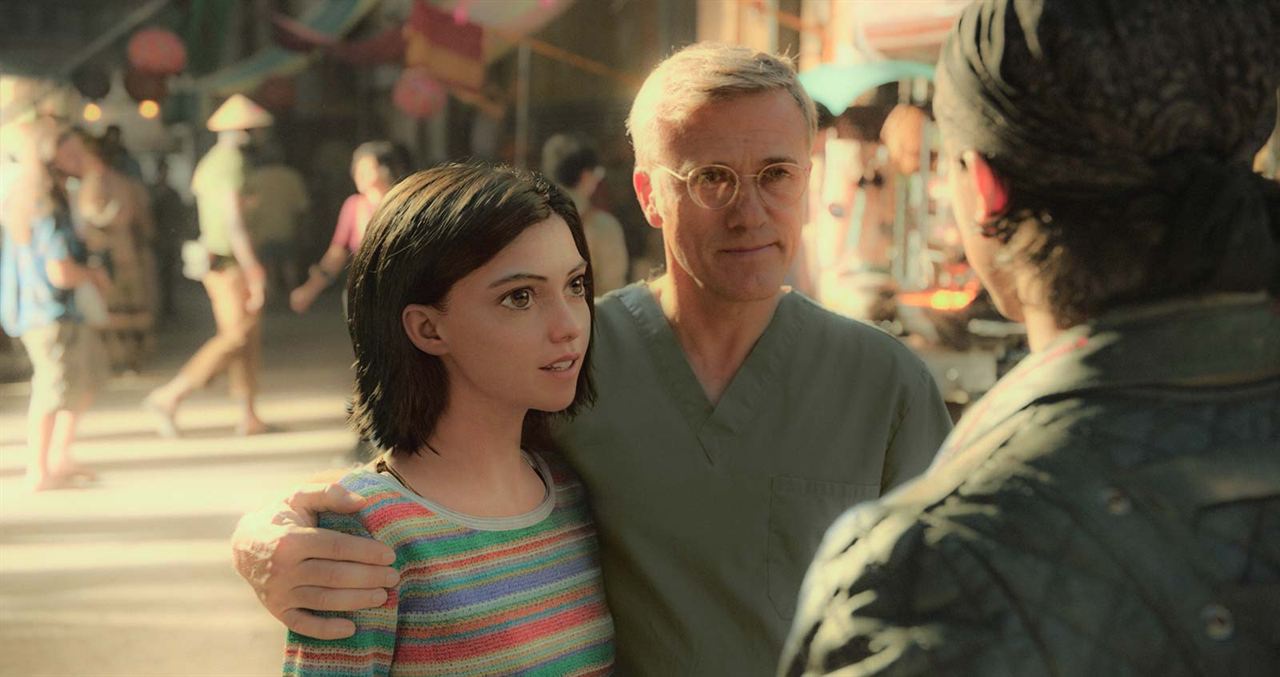
Lástima que en dispositivos móviles sea complicado hacer algo así, pero igual la idea le sirve a alguien. Vi una aplicación de unos chicos que capturaban un modelo 3D de una cara iluminándola desde distintos lados con la linterna del teléfono.
Para tomarnos en serio la iluminación computacional en los teléfonos, tendremos que pasar de los flashes LED de toda la vida a los proyectores: cualquier cacharro capaz de proyectar una imagen 2D sobre una superficie. Para empezar, basta con una simple cuadrícula monocroma.
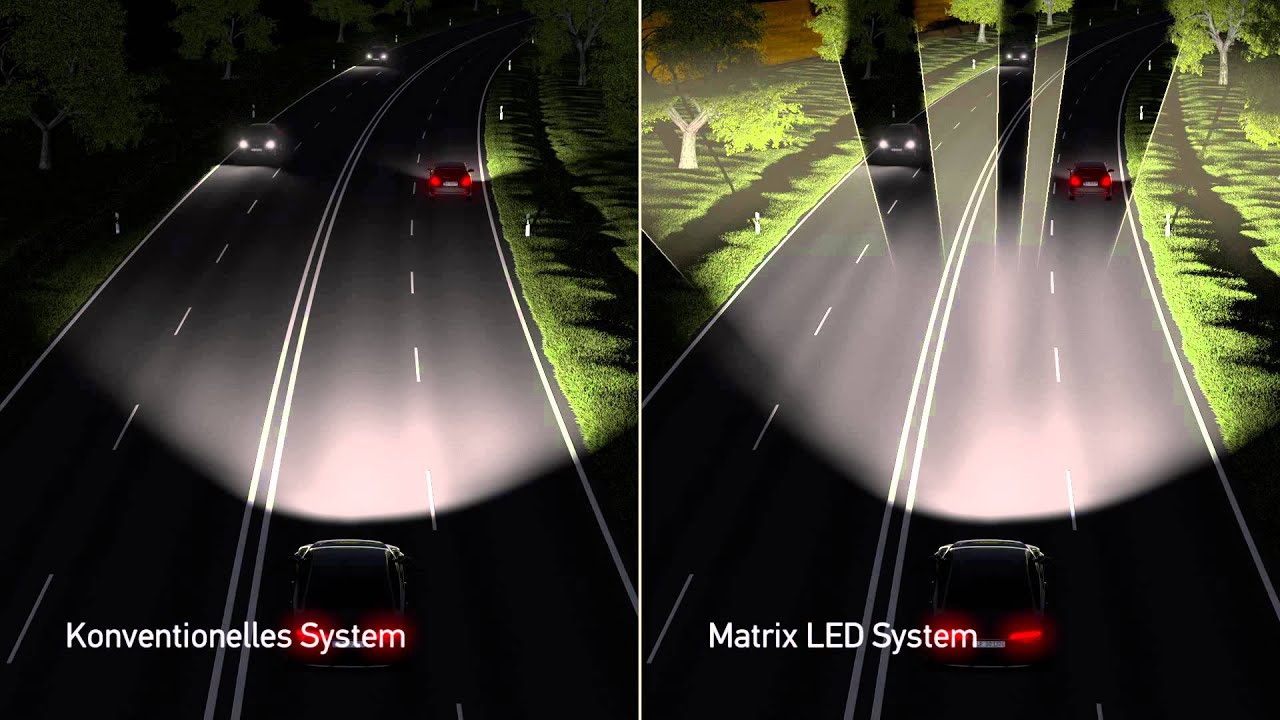
La primera ventaja del proyector es que puede iluminar solo la parte de la escena que realmente lo necesita. Se acabaron las caras quemadas en primer plano: se pueden reconocer y dejar sin iluminar, como hacen los faros láser de los coches modernos, que no deslumbran a los conductores que vienen de frente pero sí iluminan a los peatones. Incluso con una resolución mínima del proyector, digamos 100 × 100 puntos, esa iluminación selectiva ofrece posibilidades bastante interesantes.
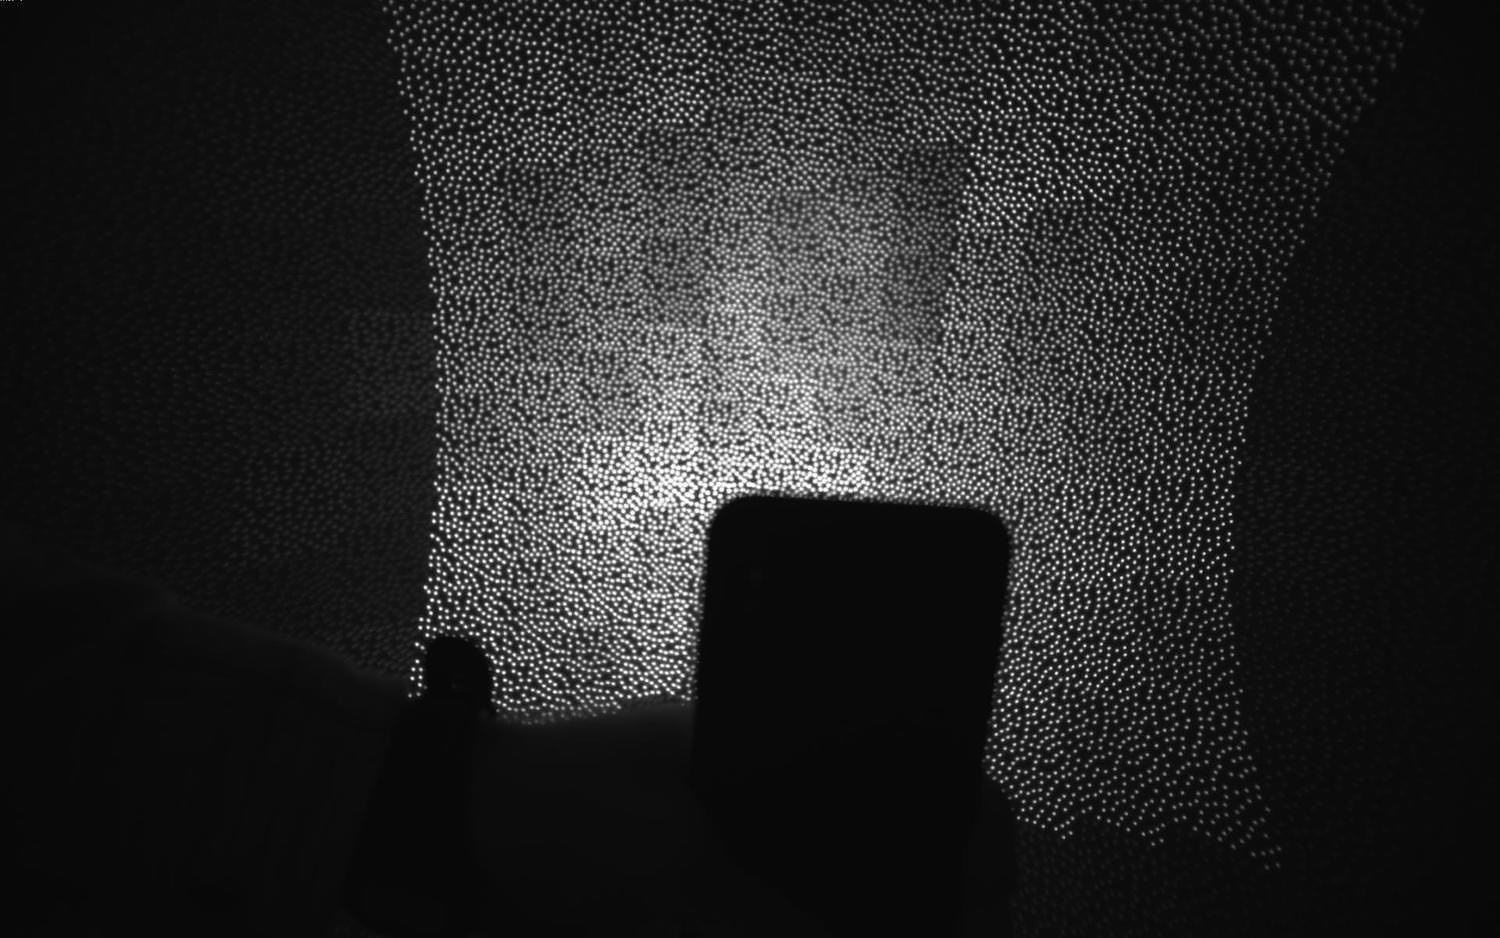
La segunda aplicación del proyector, algo más realista, es proyectar sobre la escena una cuadrícula invisible para el ojo. Con eso podemos olvidarnos de todas esas redes neuronales para calcular la profundidad: a partir de la cuadrícula, unos algoritmos de visión por computador sencillísimos calculan la distancia a todos los objetos de la escena. Ya se hacía en tiempos de Microsoft Kinect, que en paz descanse, y funcionaba de puta madre.
Claro que aquí no podemos dejar de mencionar el Dot Projector de Face ID en el iPhone X y los modelos posteriores. De momento es nuestro primer paso hacia estas tecnologías de proyección, pero ya se nota bastante.
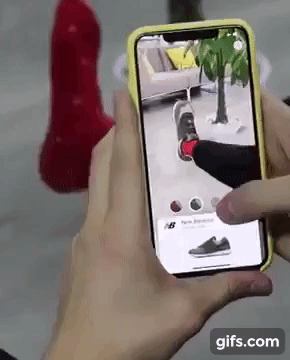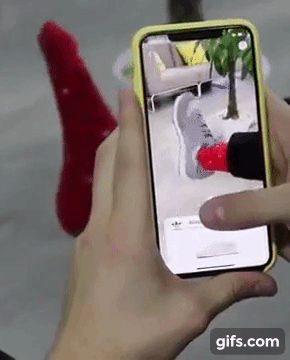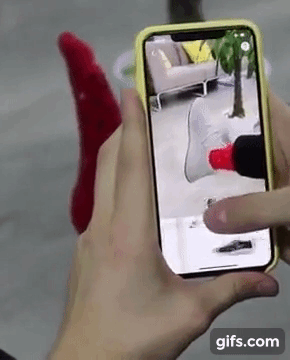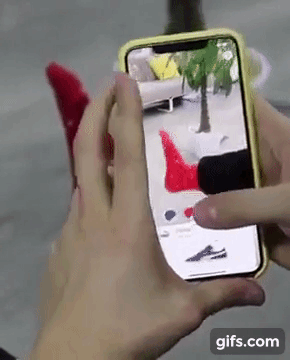
Hora de darle unas vueltas al asunto. A juzgar por lo que se cuece en las grandes tecnológicas, los próximos diez años vamos a estar metidos de lleno en la realidad aumentada. Ahora la RA parece un juguete: sirve para palpar a una waifu en 3D, probarte unas zapatillas, ver cómo te queda el maquillaje o entrenar al ejército estadounidense. Mañana la estaremos usando a todas horas sin darnos cuenta. Ya se notan los ríos de dinero que llegan de Google y Nvidia.
Para la fotografía, eso significa que se pondrá de moda la foto con RA: podremos controlar la escena 3D. Escanear el espacio como los teléfonos con Tango, añadir objetos nuevos como en HoloLens, todo eso. No te dejes desanimar por los gráficos de mierda de las aplicaciones de RA actuales: en cuanto lleguen las empresas de videojuegos con sus peliculitas borrosas, la cosa mejorará bastante.
Autor: Píxel muerto
¿Recuerdas la que armó Huawei con su falso modo Luna? Por si te lo perdiste: cuando la cámara del Huawei detectaba que querías fotografiar la Luna, te pegaba en la toma una foto de la Luna en alta resolución que ya tenía preparada. Y es verdad que quedaba mejor. Ciberpunk chino en estado puro. Todo internet se rio bastante más fuerte de lo habitual.
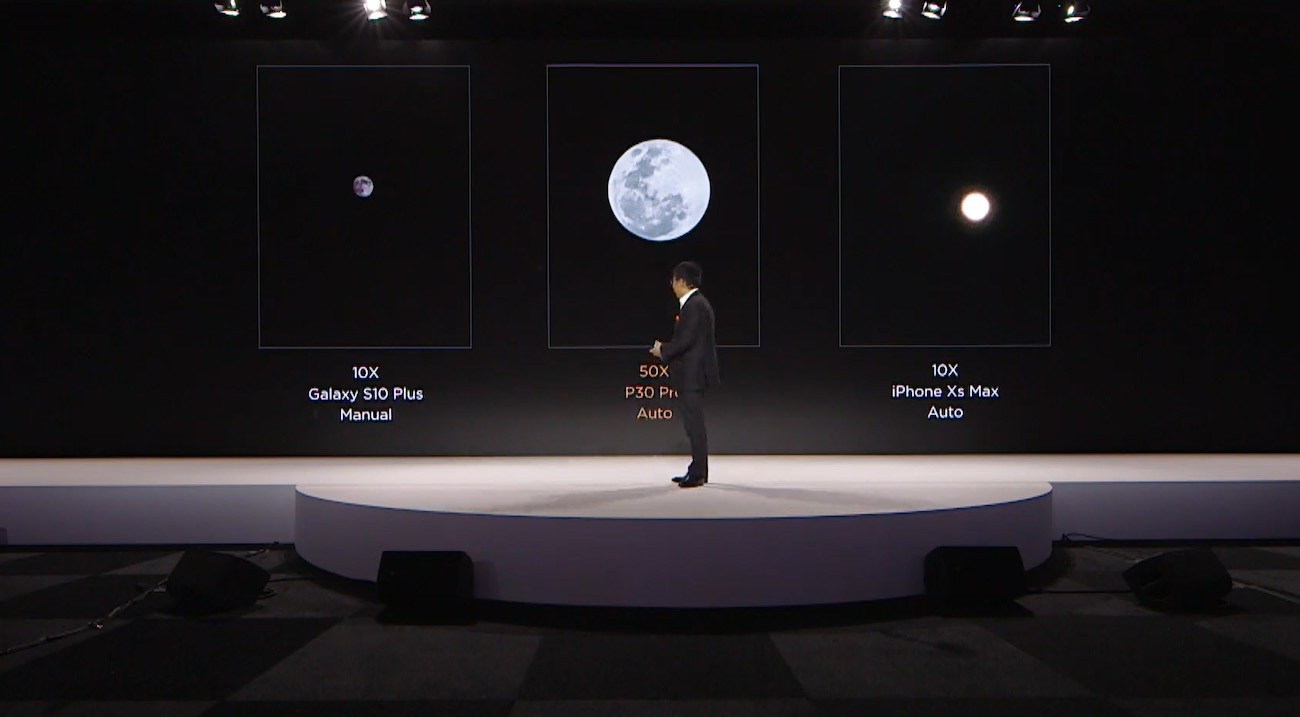
Luego me compré unos pulmones nuevos y me puse a pensar: el tío Liao, allí en el escenario, tenía razón. Le dio a la gente exactamente lo prometido: la Luna era de verdad y la cámara permitía fotografiarla ASÍ. Para más reclamaciones, escriban a la lotería deportiva. Si mañana el teléfono te ofrece pegar una bonita puesta de sol o un cielo azul en lugar de las nubes, ¡los cinco millones de habitantes de San Petersburgo van a estar encantados!
En el futuro, las máquinas «terminarán de pintar» nuestras fotos. Así lo veo yo
Ya hay algún modo de RA medio tonto en las cámaras de los Pixel, Galaxy y demás teléfonos Android. Uno te deja añadir personajes de dibujos animados para hacerte fotos con ellos, otro pegar emojis por toda la habitación, otro ponerte máscaras en la cara como en Snapchat.
No son más que nuestros primeros pasos ingenuos. Hoy la cámara de Google ya incluye Google Lens, que busca en Google la información de cualquier objeto al que apuntes. En Samsung, Bixby sabe hacer lo mismo. De momento, esas funciones solo sirven para humillar a la gente con iPhone, pero no cuesta imaginar que la próxima vez que te hagas un selfi delante de la Torre Eiffel, el teléfono te diga: Mira, tu selfi es una puta mierda. Te he puesto de fondo una foto decente y nítida de la torre desde el mismo ángulo, te he arreglado el pelo y te he tapado ese grano debajo del labio. El filtro que mejor le queda es el L4 de VSCO. No hace falta que me des las gracias.
Después la cámara empezará a cambiarte la hierba por otra más verde, los amigos por otros más íntimos y las tetas por otras más grandes, o algo así. Un mundo feliz.
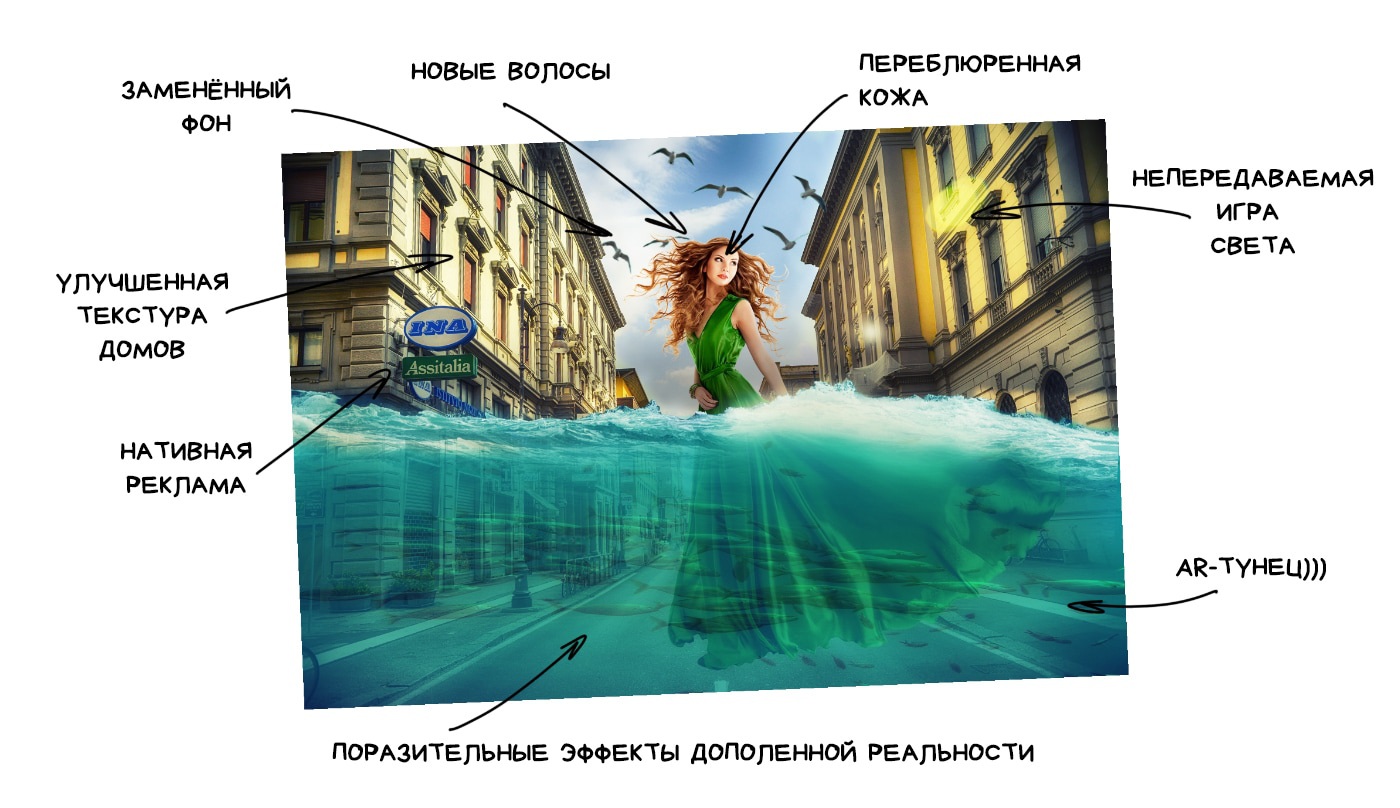
Todo esto va a parecer ridículo, hasta horrible al principio. Los viejos estetas van a echar humo y los defensores de lo natural irán casa por casa a confiscarle las redes neuronales a la población. El gran público, en cambio, estará encantado. Porque para él la fotografía no es más que una forma de expresarse y transmitir emociones. Cada vez que ha aparecido una herramienta para expresarlas de manera más viva y eficaz, todo el mundo ha empezado a usarla: emojis, filtros, pegatinas, máscaras, mensajes de voz. A alguno ya le dará asco la lista y eso que se puede seguir un buen rato.
Las fotos de la «realidad objetiva» parecerán tan aburridas como las fotos de familia en la mesa de Año Nuevo con la ensaladilla rusa. No morirán, pero acabarán como los libros de papel: una afición para estetas que le encuentran un sentido especial. «¿A quién le puede interesar complicarse la vida con la luz y la composición de la escena si mi teléfono me pinta lo mismo?», se preguntarán unos, perplejos. «Cococó, cocó», replicarán los otros.
Al gran público le importa una mierda la objetividad. Quiere que los algoritmos le rejuvenezcan la cara y que sus vacaciones se vean mejores que las del compañero de la mesa de al lado. La realidad aumentada terminará de pintarles la realidad, incluso con más detalle del que tiene de verdad. Por raro que suene, vamos a empezar a mejorar los gráficos del mundo real.
Y sí, como siempre, todo empezará con los adolescentes y sus «estúpidas aficiones incomprensibles para degenerados». Así empieza todo, siempre. En cuanto hay algo que ya no entiendes, eso es el futuro. No los pierdas de vista.