 Vastrik
Volvamos a explicarlo con Oleg.
Supongamos que Oleg quiere comprarse un auto y está calculando cuánto dinero necesita ahorrar. Ha mirado una decena de anuncios en internet y ha visto que los autos nuevos cuestan unos 20 000 dólares; los de un año, unos 19 000; los de dos, 18 000, y así sucesivamente.
Oleg, en plan analista, saca una fórmula de cabeza: el precio razonable de un auto empieza en 20 000 dólares y baja 1000 por año hasta tocar fondo en 10 000.
Oleg acaba de hacer lo que en aprendizaje automático se llama regresión: predecir un precio a partir de datos conocidos. Lo hacemos todo el tiempo, por ejemplo, cuando calculamos en cuánto vender el iPhone viejo o cuánta carne llevar a la casa de campo para la parrilla (mi fórmula: medio kilo por persona y día).
Sí, sería muy cómodo tener una fórmula para cada problema del mundo. Pero volvamos al precio de los autos: aparte del kilometraje, hay decenas de opciones de equipamiento, el estado mecánico varía, la demanda cambia según la temporada y hay tantos otros factores poco evidentes que Oleg, por mucho que quisiera, no podría tenerlos todos en cuenta de cabeza.
Los humanos somos tontos y perezosos: que trabajen los robots. Que la máquina mire nuestros datos, encuentre patrones y aprenda a predecir la respuesta por nosotros. Lo interesante es que acabó encontrando hasta patrones que nadie sospechaba que existieran.
Así nació el aprendizaje automático.
El objetivo del aprendizaje automático es predecir un resultado a partir de los datos de entrada. Cuanto más variados sean esos datos, más fácil le resultará a la máquina encontrar patrones y más preciso será el resultado.
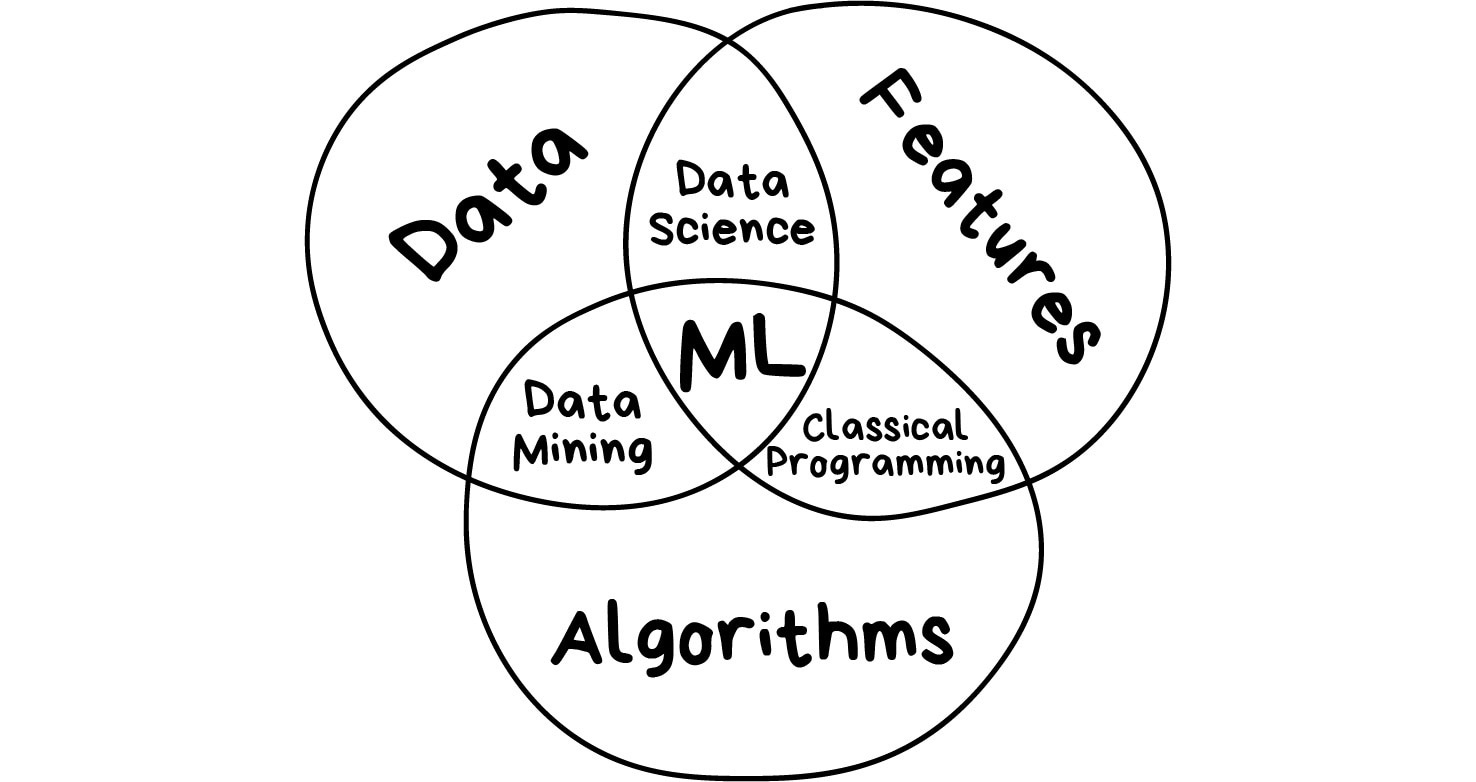
Así que, para enseñar a una máquina, necesitamos tres cosas:
Datos ¿Queremos detectar spam? Necesitamos ejemplos de correos basura. ¿Predecir la cotización de las acciones? El historial de precios. ¿Averiguar qué le interesa a un usuario? Sus «me gusta» o sus publicaciones. Necesitamos todos los datos que podamos conseguir. Decenas de miles de ejemplos es el mínimo de los mínimos, y eso si estás desesperado.
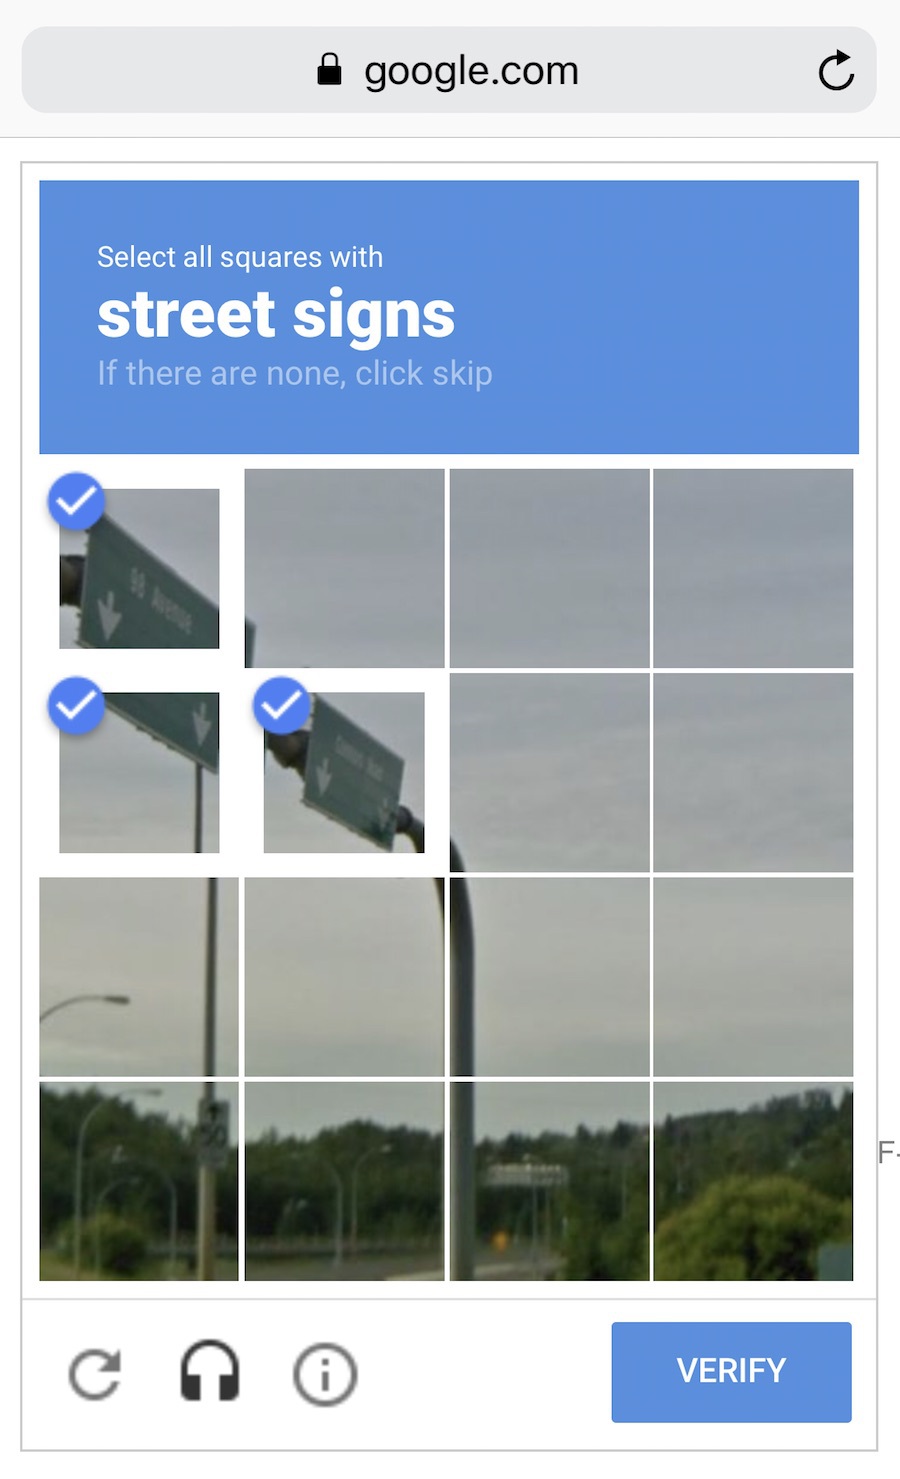
Cada cual reúne los datos como puede. Unos lo hacen a mano: tardan más, consiguen menos, pero sin errores. Otros lo hacen automáticamente: le echan a la máquina todo lo que encuentran y esperan que salga bien. Los más listos, como Google, ponen a sus propios usuarios a etiquetar datos gratis. ¿Recuerdas ese reCAPTCHA que a veces te pide que «selecciones todas las señales de tránsito de la foto»? Pues eso.
Los buenos conjuntos de datos (o datasets) están muy buscados. Las grandes empresas a veces hacen públicos sus algoritmos, pero sus datos, casi nunca.
Características Nosotros les decimos features, así que a los enemigos de los anglicismos les va a tocar sufrir. Features, propiedades, características, atributos: puede ser el kilometraje de un auto, el sexo de un usuario, el precio de una acción. Hasta el número de veces que aparece una palabra en un texto puede ser una característica.
La máquina tiene que saber en qué fijarse. Si los datos están en tablas, perfecto: los nombres de las columnas son las características. ¿Y si lo que tenemos son cien gigabytes de fotos de gatos? Con demasiadas características, el modelo se vuelve lento e ineficiente. Muchas veces, elegir las adecuadas lleva más tiempo que todo el resto del entrenamiento. Pero también pasa lo contrario: el saco de carne decide quedarse solo con las características que a él le parecen «correctas», le mete su propia subjetividad al modelo y el modelo empieza a mentir como loco.
Algoritmo Casi siempre hay varias maneras de resolver un problema. Del método que elijas dependen la precisión, la velocidad y el tamaño del modelo final. Eso sí: si los datos son una mierda, ni el mejor algoritmo te va a salvar. No te obsesiones con los porcentajes; mejor consigue más datos.
Una vez vi un artículo en una revista hípster titulado «¿Reemplazarán las redes neuronales al aprendizaje automático?». Los de relaciones públicas llaman «inteligencia artificial» en sus comunicados a cualquier regresión lineal, de esas con las que ya juegan hasta los niños en el patio. Voy a explicar la diferencia con un dibujo, de una vez por todas.
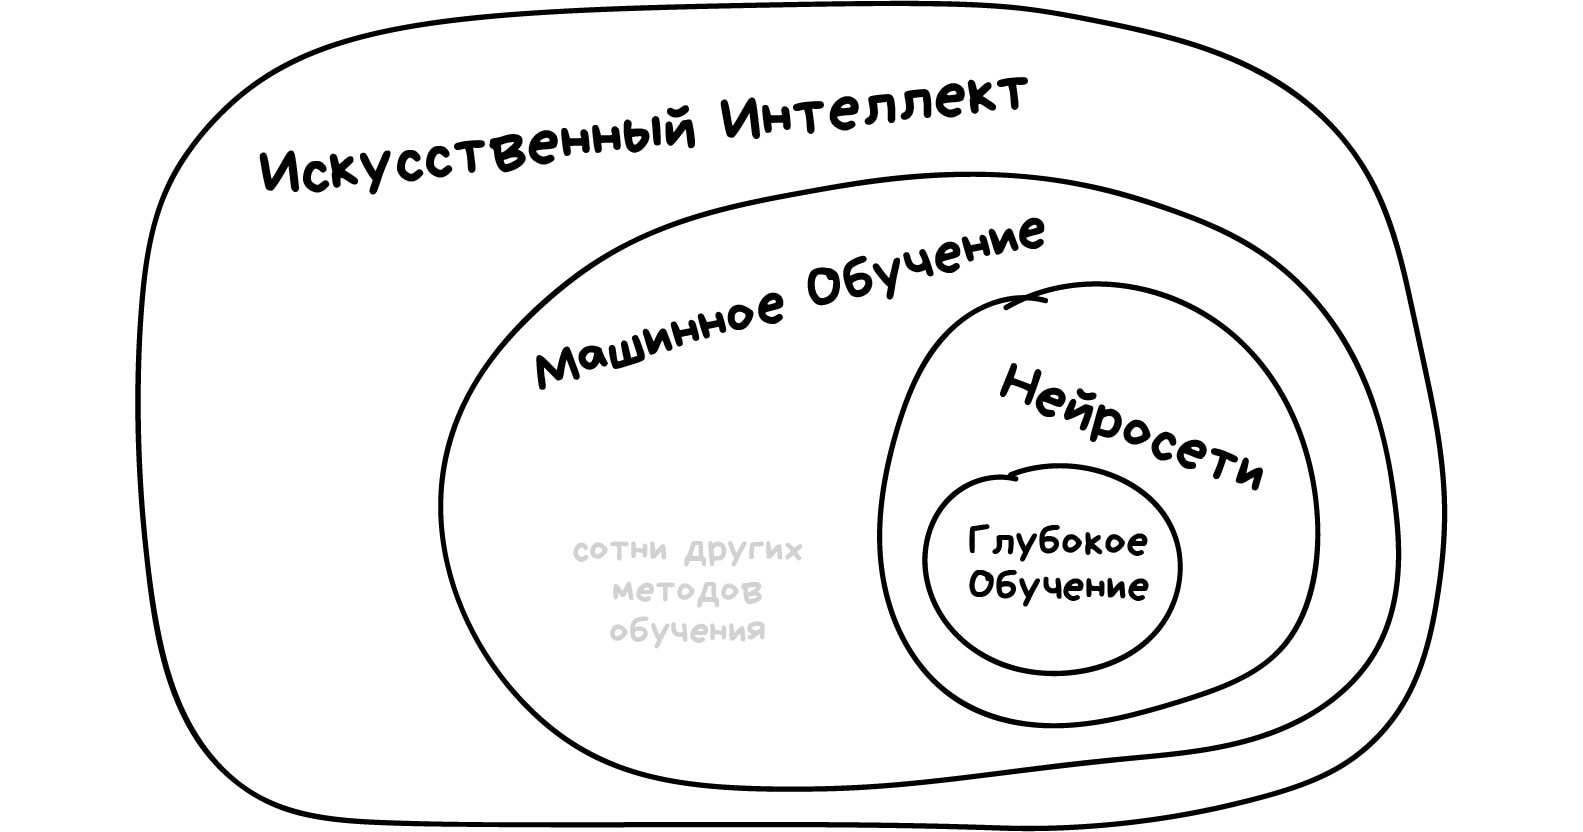
Inteligencia artificial es el nombre de todo un campo de estudio, como la biología o la química.
El aprendizaje automático es una rama de la inteligencia artificial. Importante, pero no la única.
Las redes neuronales son un tipo de aprendizaje automático. Muy popular, sí, pero hay otros igual de buenos.
El aprendizaje profundo es una arquitectura de redes neuronales, una manera de construirlas y entrenarlas. Hoy, en la práctica, casi nadie se detiene a distinguir qué redes son profundas y cuáles no tanto. Se dice el nombre de la red concreta y listo.
Solo tiene sentido comparar cosas que estén al mismo nivel. De lo contrario salen estupideces del tipo «¿qué es mejor, un auto o una rueda?». No uses los términos como sinónimos sin motivo, que vas a quedar como un tonto.
Esto es lo que saben hacer hoy las máquinas y lo que no pueden hacer ni las mejor entrenadas.
La máquina puede | La máquina no puede
--- | ---
Predecir | Crear algo nuevo
Memorizar | Volverse lista de golpe
Reproducir | Salirse de su tarea
Elegir lo mejor | Matar a todos los humanos
Si te da pereza leer un artículo tan largo, al menos quédate un rato mirando el dibujo. Algo sacarás.
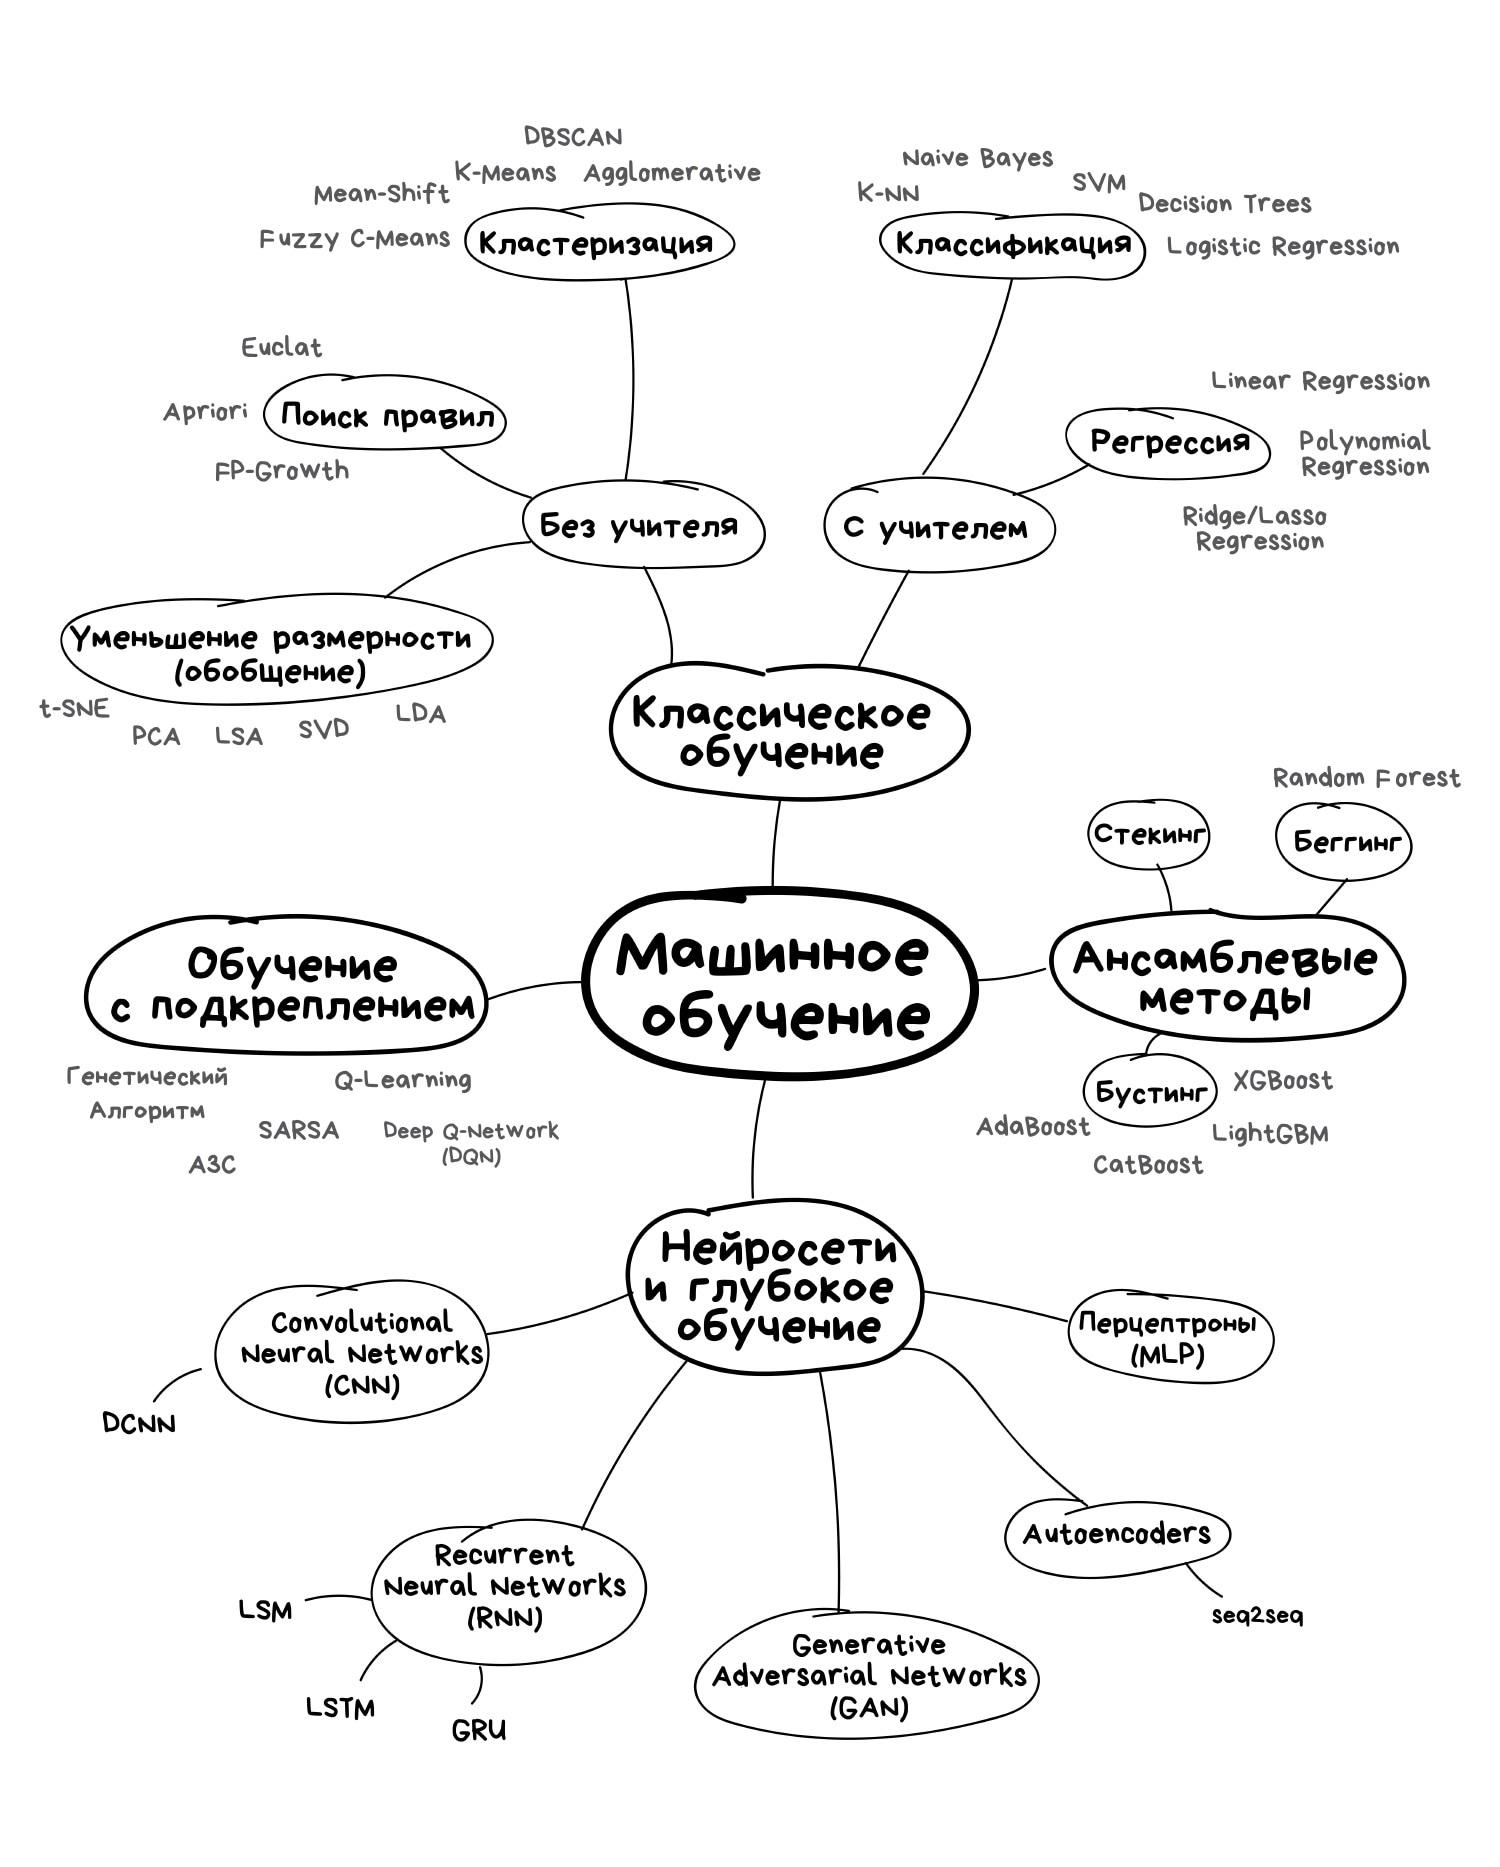
Si el artículo gusta, estoy pensando en dibujar un mapa de verdad, de los que se cuelgan en la pared, con flechitas y explicaciones de dónde se usa cada cosa.
Y sí, los algoritmos se pueden clasificar de diez maneras distintas. Elegí esta porque me parece la más cómoda para contarlo. Eso sí, no hay problemas que solo admitan un método. Voy a poner ejemplos conocidos de aplicaciones, pero ten presente que «el hijo de la amiga de tu madre» sabe resolver todo esto con redes neuronales.
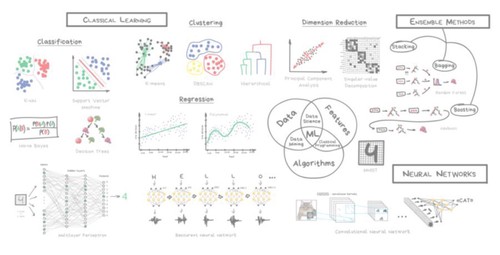
Empecemos con un vistazo general. Hoy en día hay cuatro grandes ramas del aprendizaje automático.
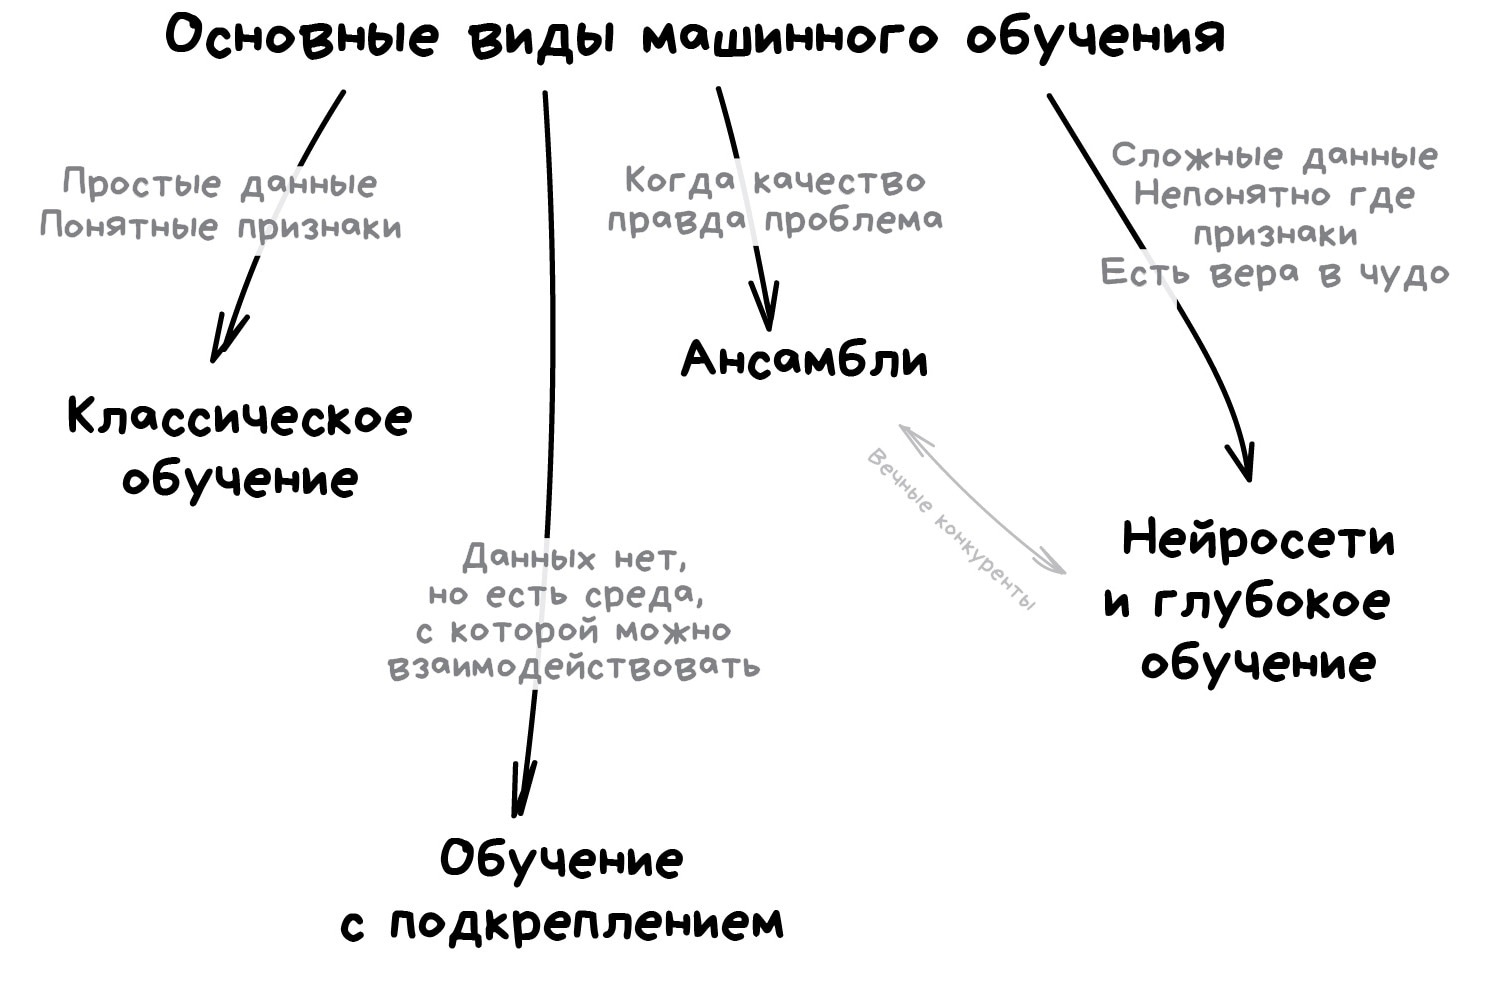
Los primeros algoritmos salieron de la estadística pura allá por los años cincuenta. Resolvían problemas formales: buscaban patrones entre numeritos, medían lo cerca que estaban unos puntos de otros en el espacio y calculaban direcciones.
Hoy, una buena mitad de internet se sostiene sobre algoritmos clásicos. Cuando ves un bloque de «Artículos recomendados» en una web, o cuando el banco te bloquea todo el dinero de la tarjeta apenas pagas tu primer café en el extranjero, casi siempre es obra de uno de estos algoritmos.
Sí, a las grandes corporaciones les encanta resolverlo todo con redes neuronales. A ellas, un 2 % más de precisión se les convierte fácilmente en 2000 millones más de beneficios. Los demás haríamos bien en usar la cabeza. Si el problema se puede resolver con métodos clásicos, sale más barato empezar por montar con ellos un sistema que le sirva de algo al negocio y pensar después en las mejoras. Si no has resuelto el problema, no resolverlo un 2 % mejor tampoco te va a servir de mucho.
Conozco varias historias bastante graciosas de equipos que pasaron tres meses reescribiendo el sistema de recomendaciones de una tienda en línea con un algoritmo más preciso, solo para descubrir después que los compradores ni lo usaban. La mayoría llegaba directamente desde un buscador.
Por muy extendidos que estén, los algoritmos clásicos son tan sencillos que hasta un niño los entendería. Hoy son como la aritmética básica: sirven a cada rato, pero a algunos ya se les están olvidando.
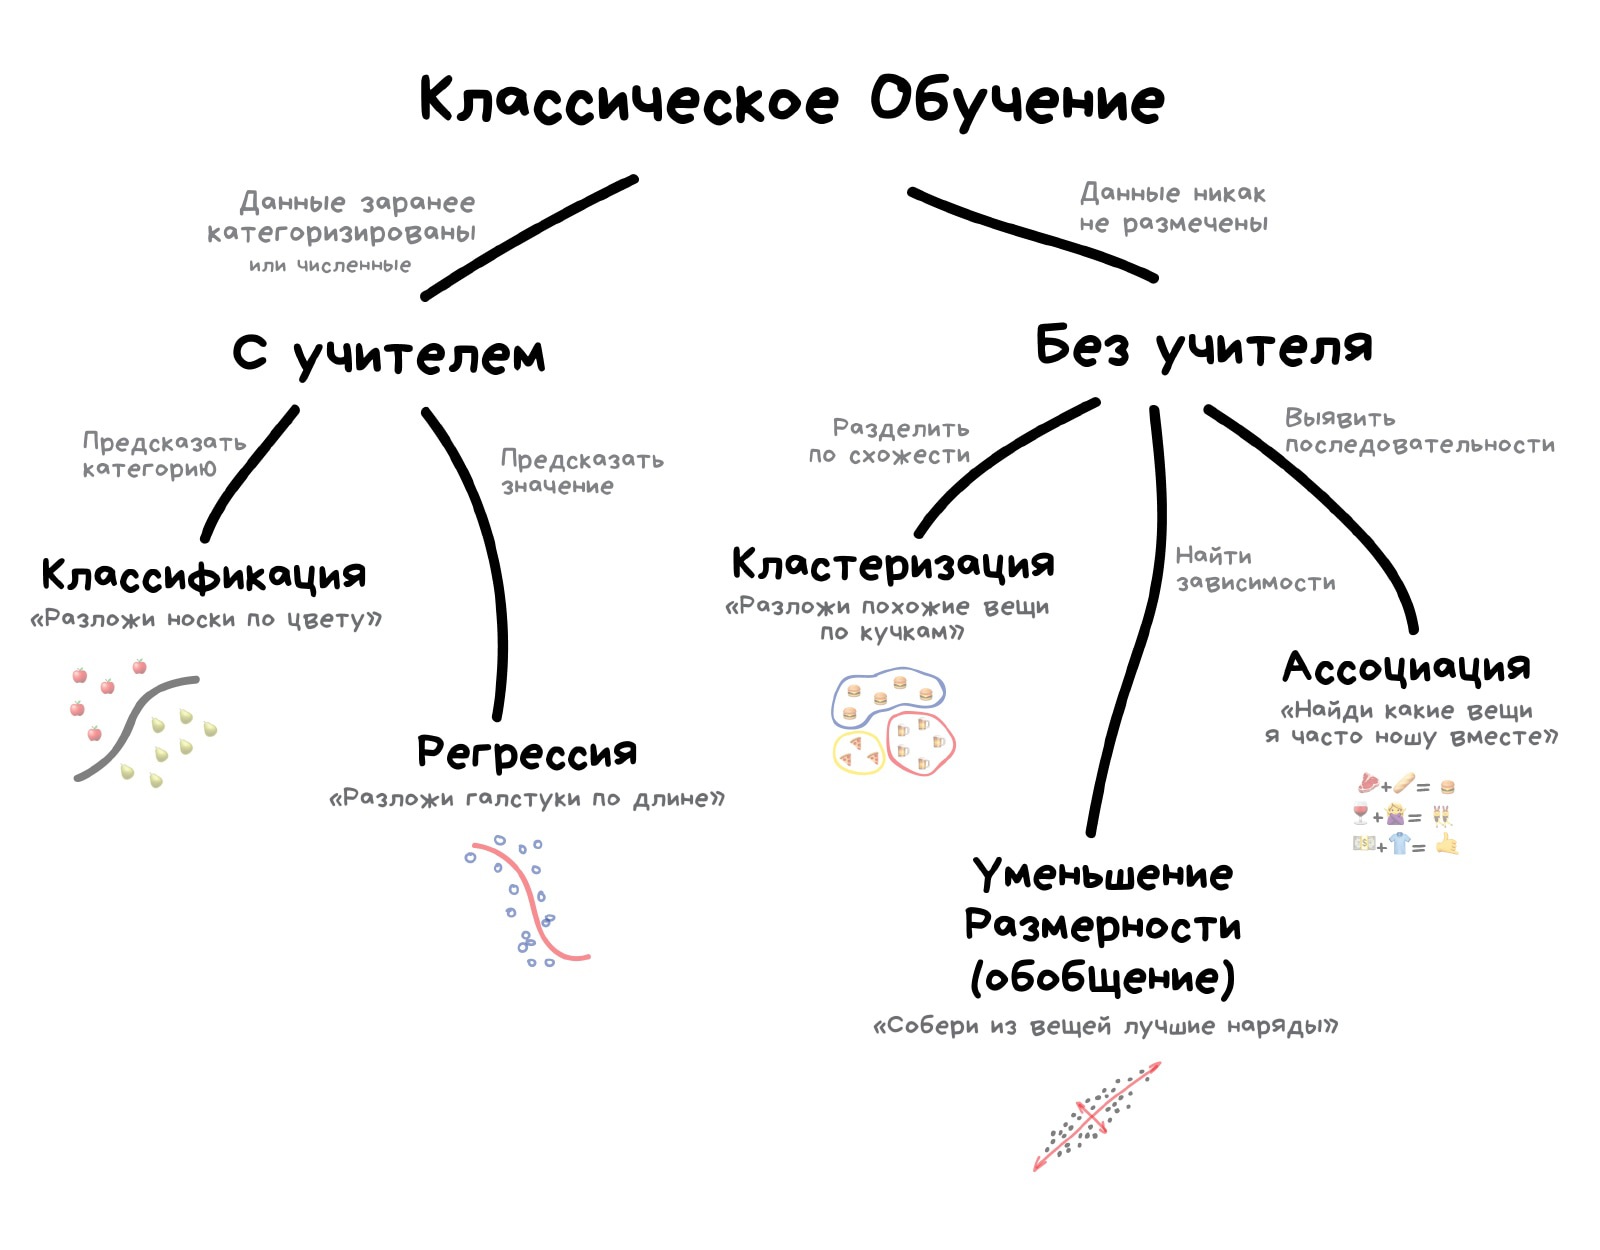
El aprendizaje clásico se suele dividir en dos categorías: con profesor o sin él. En español se llaman aprendizaje supervisado y no supervisado; en inglés los verás a menudo como Supervised y Unsupervised Learning.
En el primer caso, la máquina tiene una especie de profesor que le dice cuál es la respuesta correcta. En esta foto hay un gato; en esta otra, un perro. Es decir, el profesor ya separó (etiquetó) todos los datos en gatos y perros, y la máquina aprende con ejemplos concretos.
En el aprendizaje no supervisado, le sueltan a la máquina un montón de fotos de animales sobre la mesa y le dicen: «A ver, averigua quién se parece a quién». Los datos no están etiquetados, la máquina no tiene profesor e intenta encontrar algún patrón por su cuenta. De estos métodos hablaremos más abajo.
Como es lógico, con profesor la máquina aprende más rápido y con mayor precisión, así que este enfoque se usa mucho más en problemas reales. Los hay de dos tipos: clasificación, que predice a qué categoría pertenece un objeto, y regresión, que predice un punto en la recta numérica.
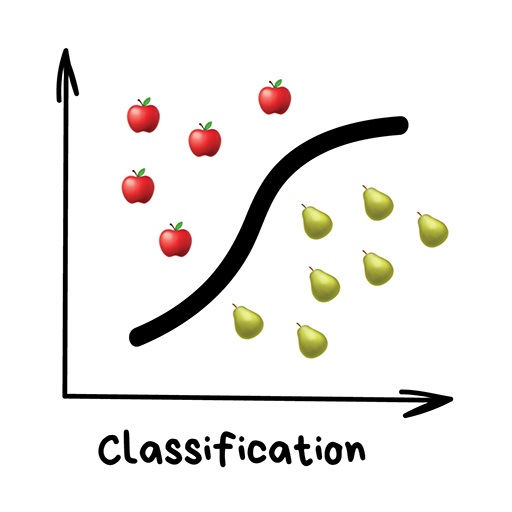
«Separa objetos según una característica conocida de antemano. Los calcetines por colores, los documentos por idiomas, la música por géneros»
Hoy se usa para:
Algoritmos populares: clasificador bayesiano ingenuo, árboles de decisión, regresión logística, k vecinos más cercanos, máquinas de vectores de soporte
Aquí y en los siguientes bloques puedes aportar lo que falte en los comentarios. Pon tus propios ejemplos de problemas, campos de aplicación y algoritmos, que los míos salen de mi experiencia y eso es bastante subjetivo.
Clasificar cosas es la tarea más popular de todo el aprendizaje automático. Aquí la máquina es como un niño que aprende a guardar sus juguetes: los robots en una caja, los tanques en otra. Un momento, ¿y si es un robot tanque? Pues nada, a llorar y a dar error.
Para clasificar siempre hace falta un profesor: datos etiquetados con sus características y las categorías que la máquina aprenderá a identificar a partir de ellas. Después puedes clasificar lo que quieras: usuarios por intereses, como hacen los algoritmos que deciden qué publicaciones ves; artículos por idioma y tema, algo importante para los buscadores; música por género, como en las listas de Spotify y Yandex Music. Hasta los correos de tu bandeja de entrada.
Antes, todos los filtros de spam usaban el clasificador bayesiano ingenuo. La máquina contaba cuántas veces aparecía la palabra «viagra» en el spam y cuántas en los correos normales. Multiplicaba esas dos probabilidades según la fórmula de Bayes, sumaba los resultados de todas las palabras y ¡pum, todos al suelo, que tenemos aprendizaje automático!
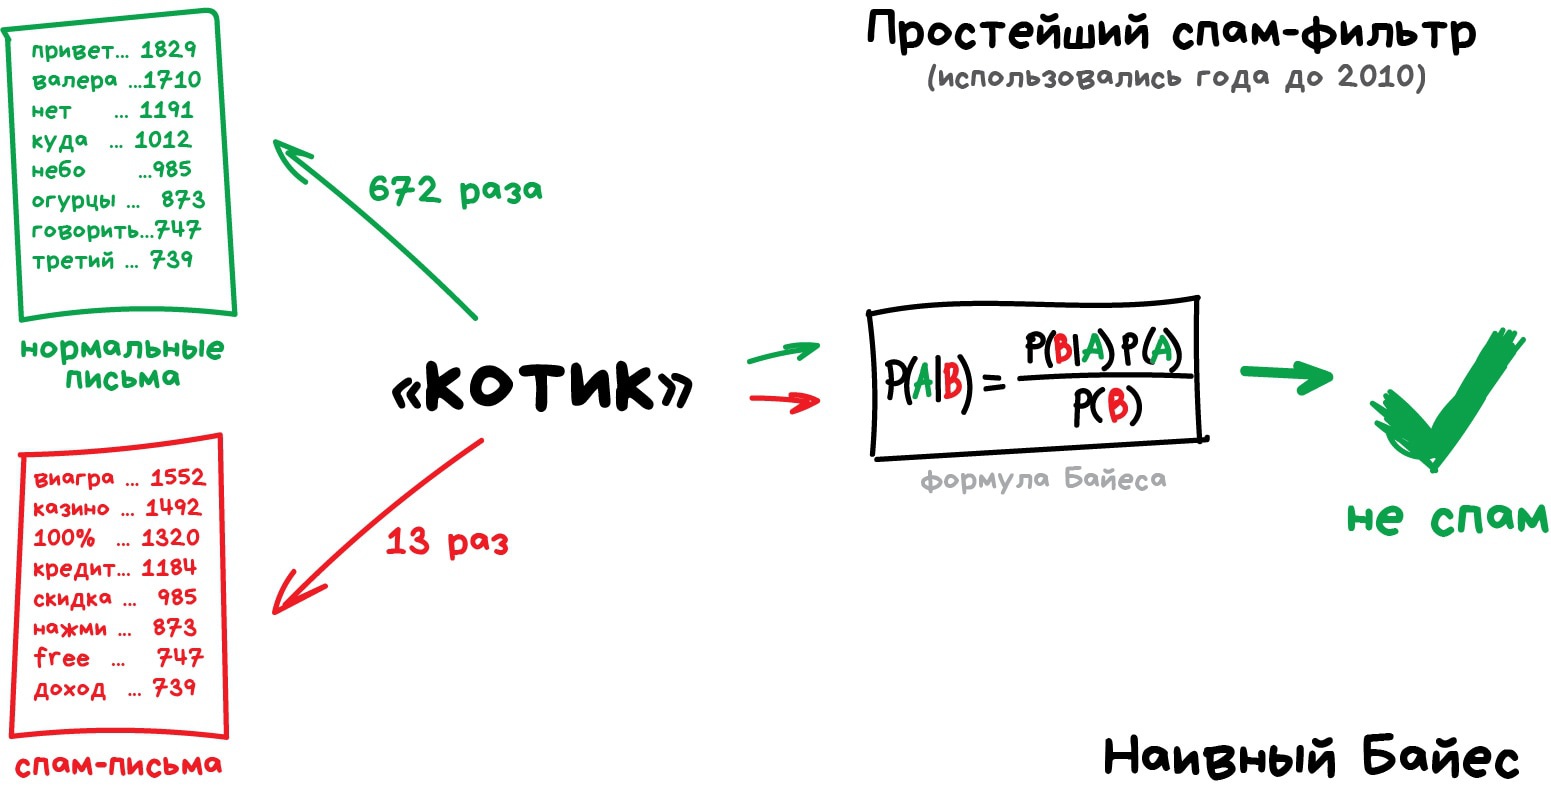
Luego los que mandaban spam aprendieron a esquivar el filtro de Bayes añadiendo al final del correo un montón de palabras con «buena» puntuación. La técnica recibió el irónico nombre de envenenamiento bayesiano y para filtrar spam se pasó a otros algoritmos. Pero el método se ganó un sitio permanente en los libros de texto por ser el más sencillo, el más elegante y uno de los primeros en servir para algo en la práctica.
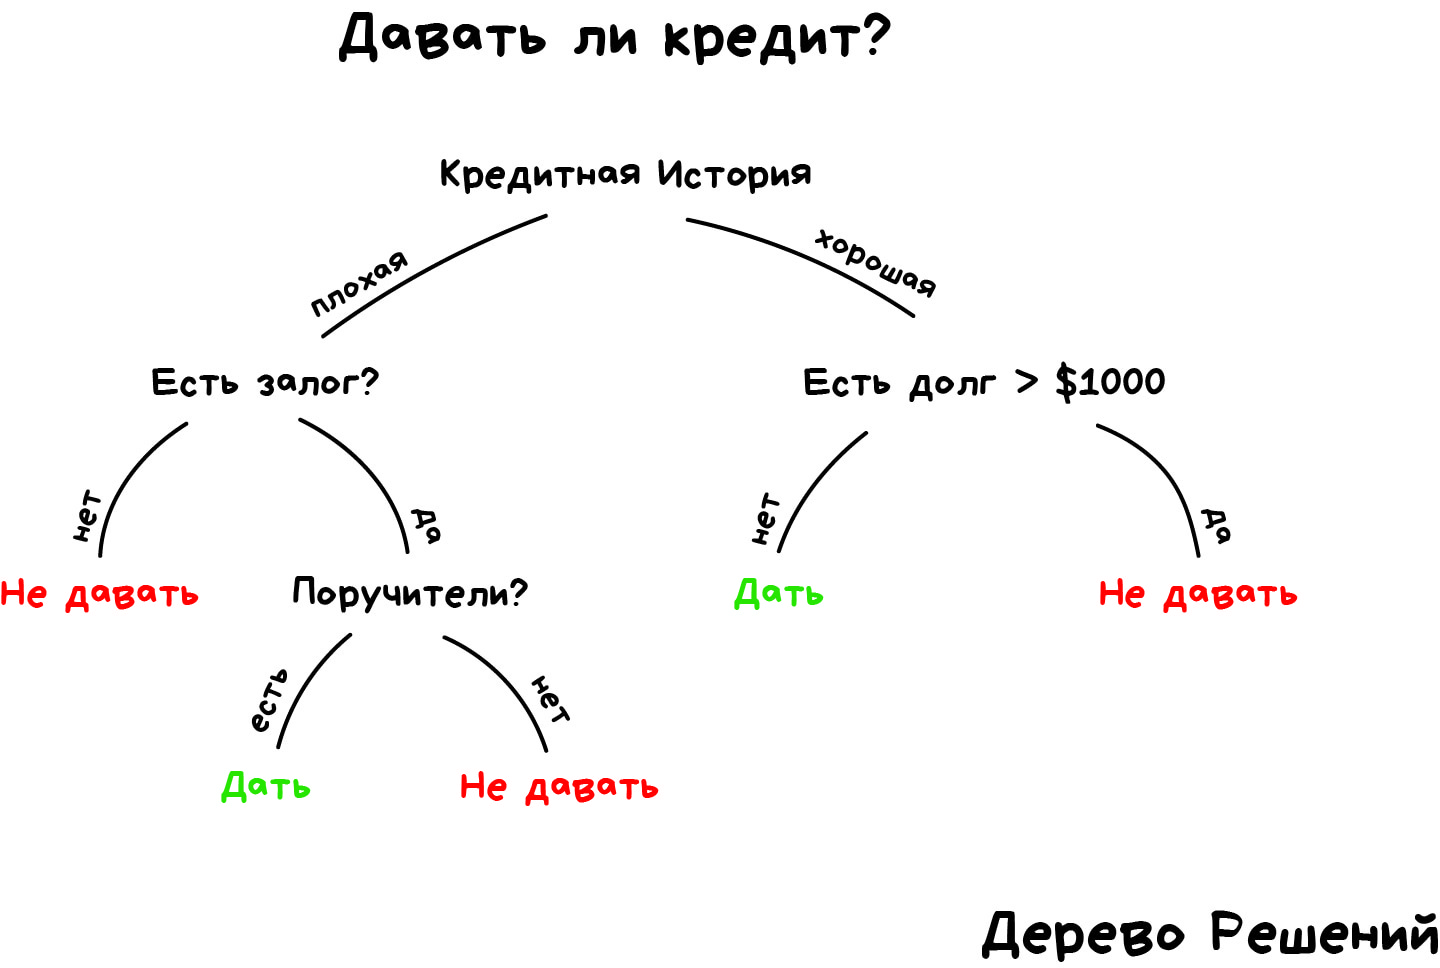
Veamos otro ejemplo útil de clasificación. Vas al banco a pedir un préstamo. ¿Cómo se asegura el banco de que vas a devolverlo? Con certeza no puede, pero tiene miles de fichas de personas que pidieron préstamos antes que tú. Ahí figuran su edad, sus estudios, su puesto de trabajo, su sueldo y, lo más importante, quién devolvió el dinero y con quién hubo problemas.
Sí, todos vemos cuáles son los datos y qué resultado hay que predecir. Entrenamos la máquina, encontramos patrones y obtenemos una respuesta. La cuestión no es esa. El problema es que el banco no puede fiarse a ciegas de la respuesta de la máquina sin una explicación. ¿Y si hubo un fallo, un ataque de hackers o un administrador borracho decidió arreglar un script rapidito?
Para eso se inventaron los árboles de decisión. La máquina divide automáticamente los datos mediante preguntas que se responden con un sí o un no. A un humano le pueden sonar un poco raras, por ejemplo: «¿El sueldo del solicitante supera los 25 934 rublos?». Pero la máquina las elige de modo que la división sea lo más precisa posible en cada paso.
Así se forma un árbol de preguntas. Cuanto más arriba, más general es la pregunta. Luego hasta puedes pasarles las preguntas a los analistas, que ya se inventarán una explicación.
Los árboles han encontrado su sitio en campos de mucha responsabilidad: diagnóstico, medicina, finanzas.
Hoy rara vez se usan árboles solos, pero sus conjuntos (de los que hablaremos más abajo) son la base de grandes sistemas y muchas veces les ganan hasta a las redes neuronales. Por ejemplo, cuando le haces una pregunta a Yandex, lo que sale corriendo a ordenarte los resultados es una multitud de árboles tontos.
Pero el método de clasificación clásica más popular, y con razón, es el de las máquinas de vectores de soporte (SVM). Se ha usado para clasificar de todo: especies de plantas, caras en fotos, documentos por tema, hasta extrañas modelos de Playboy. Durante años fue la respuesta por excelencia a «¿qué clasificador uso?».
La idea de las SVM es sencilla: buscan cómo trazar dos rectas entre las categorías de manera que el margen entre las rectas sea lo más ancho posible. En el dibujo se ve mejor:
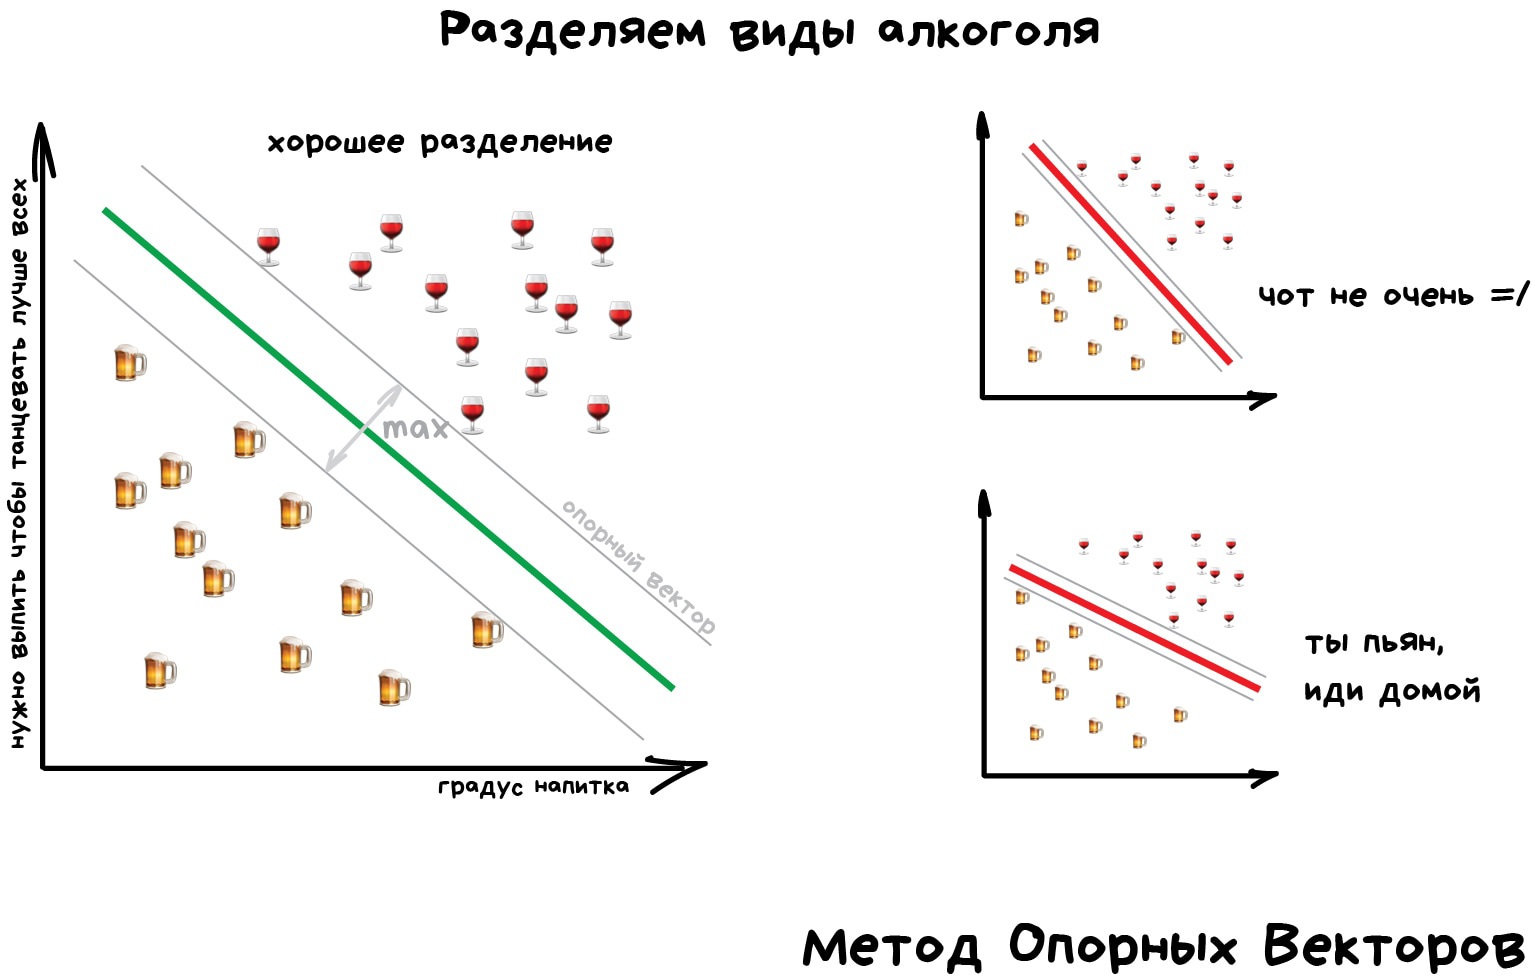
La clasificación tiene un reverso muy útil: la detección de anomalías. Si una característica de un objeto se sale por mucho de nuestras clases, la resaltamos bien en la pantalla. Ya se hace en medicina: la computadora le señala al médico las zonas sospechosas en una resonancia o los valores anómalos en unos análisis. En las bolsas se identifican así los operadores que se salen de la norma y que probablemente tengan información privilegiada. Al enseñarle a la computadora «lo correcto», nos llevamos de regalo el clasificador inverso: lo que no es correcto.
Hoy cada vez se usan más las redes neuronales para clasificar. Al fin y al cabo, para eso se inventaron.
Mi regla de andar por casa: a datos más complejos, algoritmos más complejos. Para texto, números y tablas, yo empezaría por los clásicos. Los modelos son más pequeños, se entrenan más rápido y es más fácil entender qué hacen. Para imágenes, video y demás big data difícil de descifrar, miraría directamente las redes neuronales.
Hace unos cinco años todavía podías encontrarte un clasificador de caras basado en SVM, pero hoy tienes por ahí en internet un centenar de redes listas para eso. ¿Por qué no usarlas? En cambio, los filtros de spam se siguen haciendo con SVM y no veo por qué dejar de hacerlo.
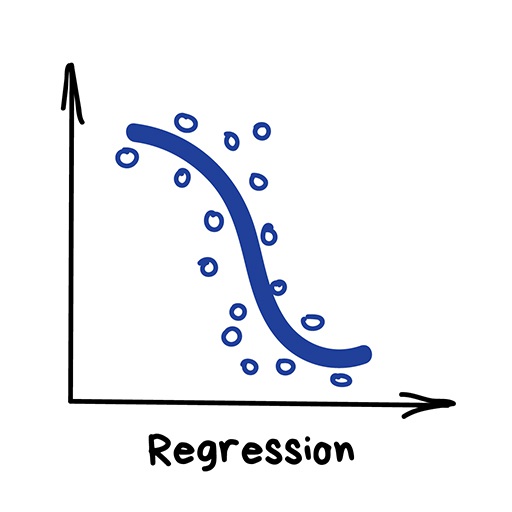
«Dibuja una línea que siga mis puntos. Sí, eso es aprendizaje automático»
Hoy se usa para:
Algoritmos populares: regresión lineal o polinómica
La regresión es como la clasificación, solo que en vez de una categoría predecimos un número. El precio de un auto según su kilometraje, la cantidad de atascos según la hora, la demanda de un producto según cuánto crezca la empresa, etc. La regresión les viene como anillo al dedo a los problemas en los que algo depende del tiempo.
A los financieros y a los analistas les encanta la regresión. Hasta Excel la trae incorporada. Y por dentro, otra vez, la cosa no tiene ningún misterio: la máquina simplemente intenta trazar una línea que, en promedio, refleje la relación. Eso sí, a diferencia de una persona con un marcador y una pizarra, lo hace con precisión matemática: calcula la distancia media a los puntos e intenta dejar a todos contentos.
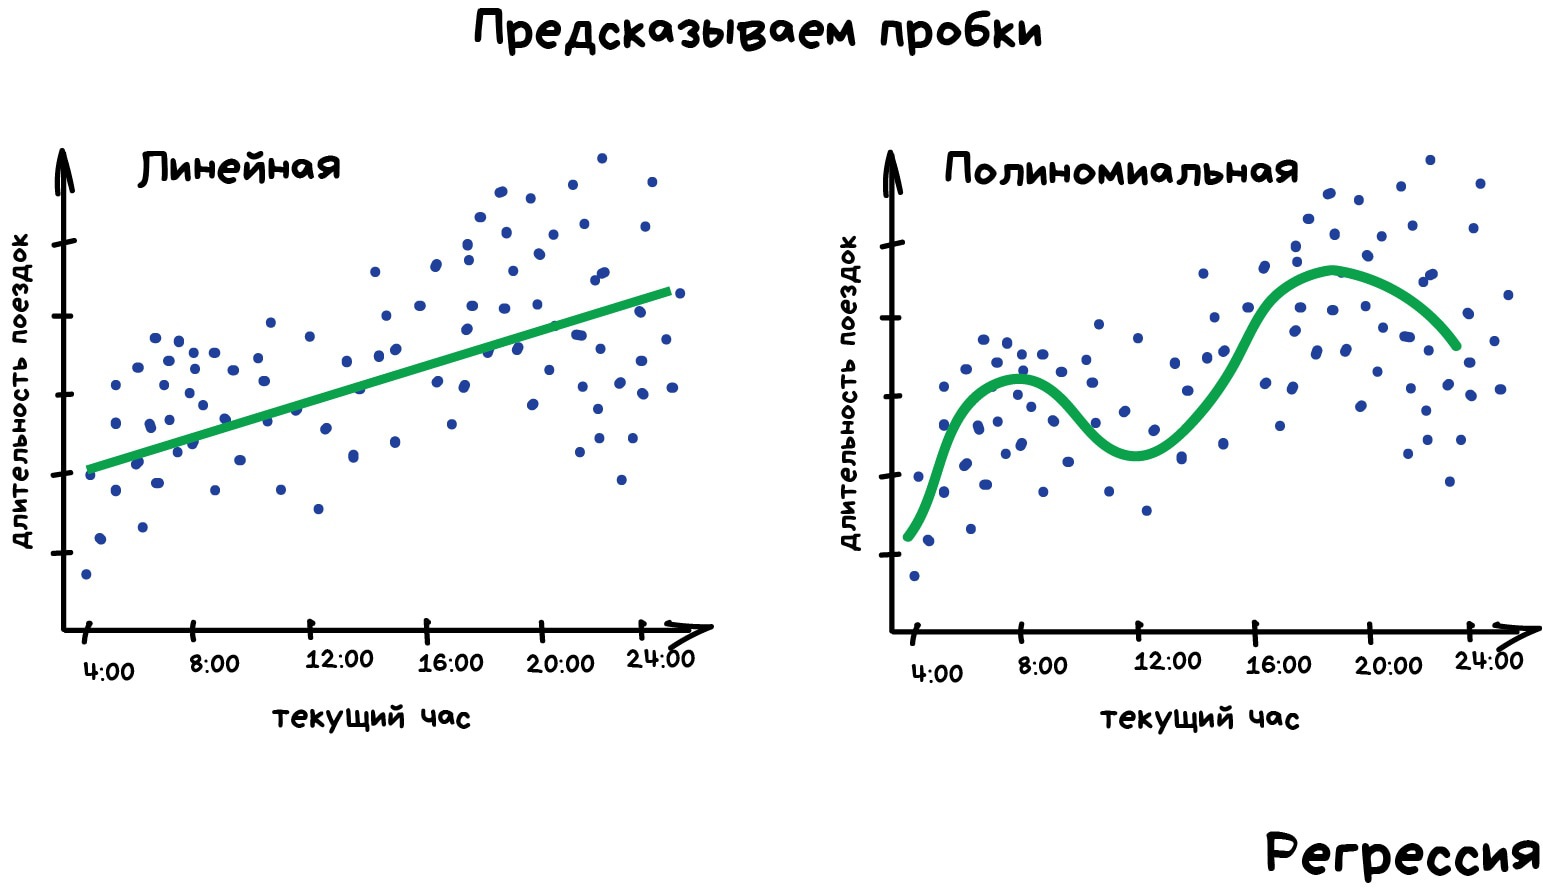
Si la regresión dibuja una recta, se llama lineal; si dibuja una curva, polinómica. Esos son los dos tipos principales de regresión; a partir de ahí ya entramos en las especies exóticas. Pero como en toda familia hay una oveja negra, también está la regresión logística, que en realidad no es una regresión sino un método de clasificación, y así, claro, todo el mundo se confunde. No hagas esas cosas.
Otra prueba del parecido entre regresión y clasificación es que, con un par de ajustes, muchos clasificadores se convierten en regresores. Por ejemplo, en vez de mirar solo a qué clase pertenece un objeto, podemos guardar también lo cerca que está de ella. Y ya tenemos una regresión.
Si quieres profundizar sin renunciar a las palabras sencillas, te recomiendo la serie Machine Learning for Humans.
El aprendizaje no supervisado (Unsupervised Learning) se inventó bastante después, ya en los noventa, y en la práctica se usa menos. Pero hay problemas en los que no nos queda otra.
Como decía, los datos etiquetados son un lujo difícil de conseguir. Pero ¿qué hago si quiero programar, por ejemplo, un clasificador de autobuses? ¿Salgo a la calle a fotografiar yo mismo un millón de putos autobuses Ikarus y anoto cuál es cuál? Se me va a ir la vida y todavía tengo juegos pendientes en Steam.
Si no hay etiquetas, siempre nos queda confiar en el capitalismo, en la desigualdad social y en un millón de chinos de servicios como Yandex Toloka, dispuestos a hacer lo que les pidas por cinco centavos. En la práctica eso es lo que se suele hacer. ¿De dónde creías que sacaba Yandex todos esos conjuntos de datos tan buenos?
O podemos probar con aprendizaje no supervisado. Aunque, la verdad, en mi experiencia no recuerdo ningún caso en que haya dado muy buen resultado.
El aprendizaje no supervisado se usa más para analizar datos que como algoritmo principal. Un saco de carne especializado con un título de la Universidad Estatal de Moscú le echa un montón de basura a la máquina y se queda mirando. ¿Hay grupos? ¿Apareció alguna relación? ¿No? Pues sigue, que el trabajo te hará libre. ¿No querías trabajar en ciencia de datos?
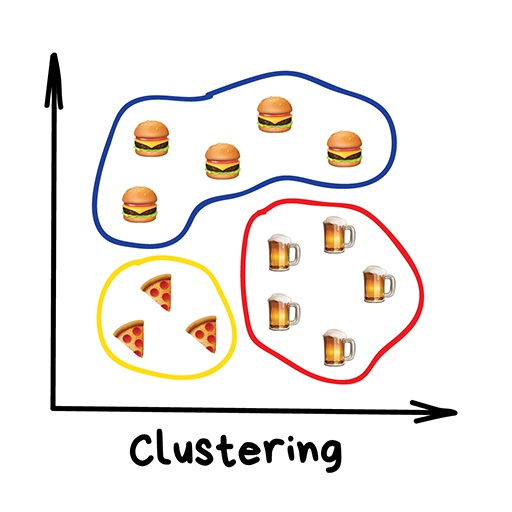
«Separa objetos según una característica que no conocemos de antemano. La máquina decide sola cómo le conviene hacerlo»
Hoy se usa para:
Algoritmos populares: k-medias, Mean Shift, DBSCAN
El agrupamiento, o clustering, es una clasificación sin clases conocidas de antemano. El algoritmo busca por su cuenta objetos parecidos y los reúne en grupos o clústeres. Podemos fijar el número de grupos de antemano o dejar que lo decida la máquina. Para saber si los objetos se parecen, la máquina se fija en las características que le hemos señalado: si tienen muchas en común, a la misma clase.
Un buen ejemplo son los marcadores de los mapas en la web. Cuando buscas todos los bares de cerveza artesanal de Moscú, el motor del mapa tiene que agruparlos en circulitos con un número. Si no, el navegador se quedaría colgado intentando dibujar un millón de marcadores.
Hay ejemplos de agrupamiento más complejos en aplicaciones como iPhoto o Google Photos, que encuentran caras en tus fotos y las agrupan en álbumes. La aplicación no sabe cómo se llaman tus amigos, pero sabe distinguirlos por sus rasgos faciales. Agrupamiento de manual.
Eso sí, primero tienen que encontrar esos «rasgos característicos», y para eso sí que hace falta un profesor.
La compresión de imágenes es otro problema muy habitual. Al guardar una imagen en PNG, puedes limitar la paleta a, digamos, 32 colores. Entonces el algoritmo de agrupamiento busca todos los píxeles «más o menos rojos», calcula una especie de «rojo promedio de todo el barrio» y reemplaza todos los rojos por ese. Menos colores, archivo más pequeño.
El problema es qué hacemos con colores como el cian ◼︎: ¿está más cerca del verde o del azul? Aquí nos ayuda un algoritmo de agrupamiento muy conocido: k-medias (K-Means). Tiramos nuestros 32 puntos al azar sobre la paleta de colores y les ponemos el nombre de centroides. Asignamos cada punto restante al centroide más cercano: nos quedan algo así como constelaciones de colores parecidos. Luego movemos cada centroide al centro de su constelación y repetimos hasta que los centroides dejen de moverse. Ya tenemos los grupos, son estables y hay exactamente 32, justo los que queríamos.
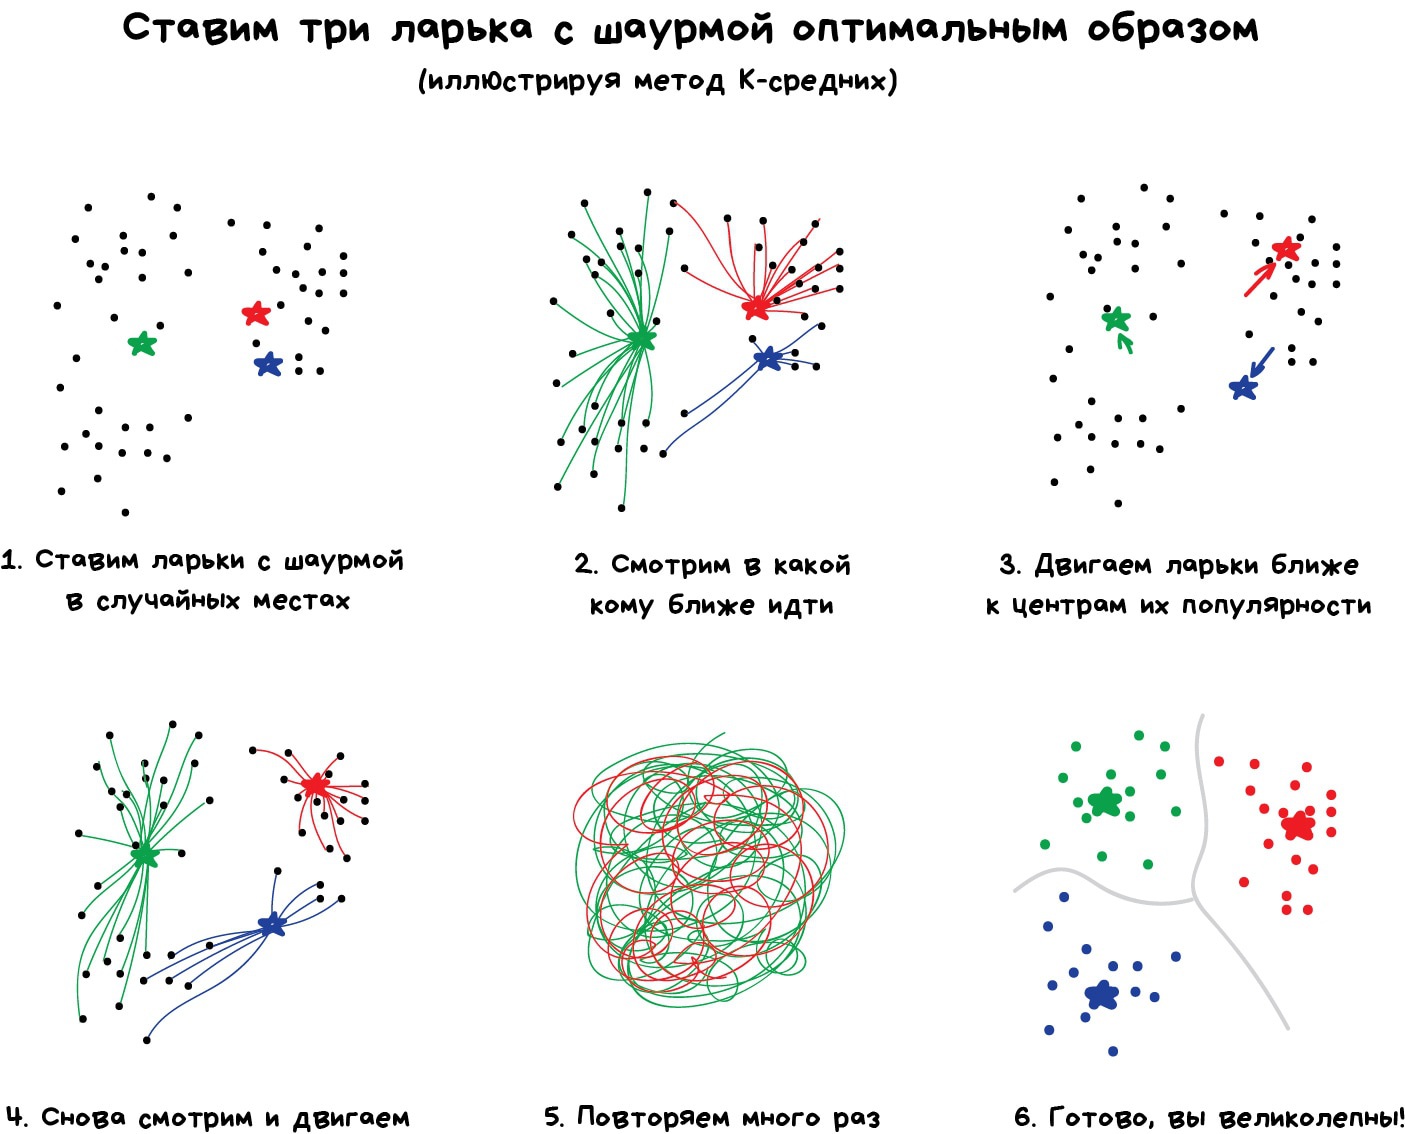
Buscar centroides es cómodo y sencillo, pero en problemas reales los grupos pueden tener formas que no se parecen en nada a un círculo. Imagina que eres geólogo y tienes que encontrar en un mapa rocas con estructuras parecidas: no solo habrá grupos dentro de otros grupos, sino que ni siquiera sabes cuántos van a salir.
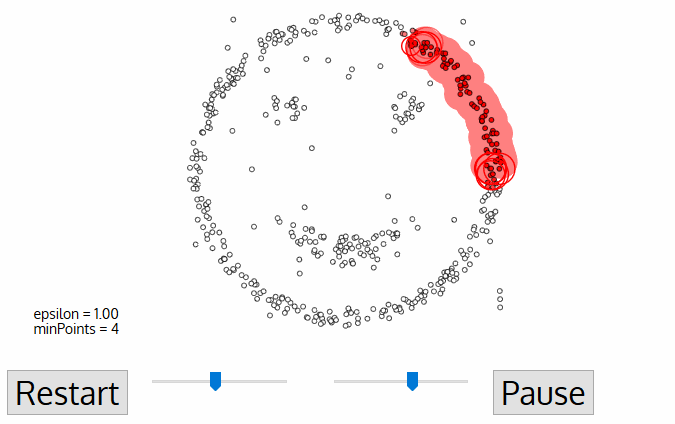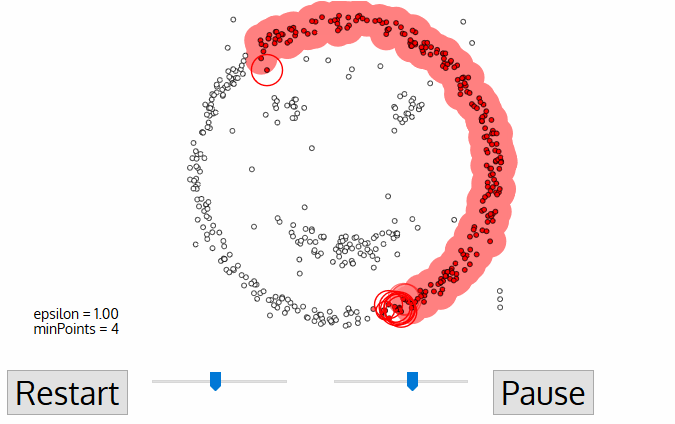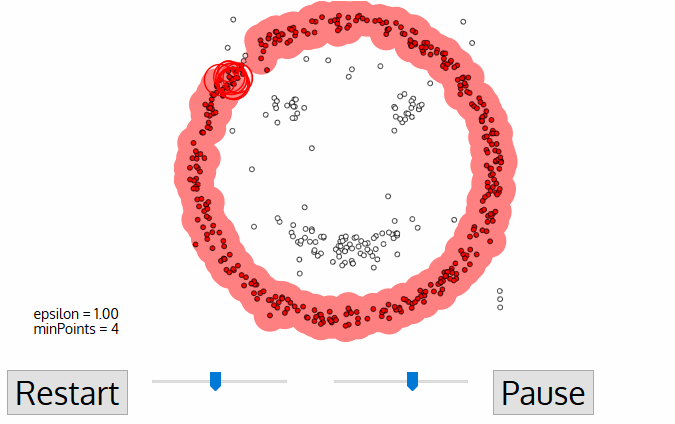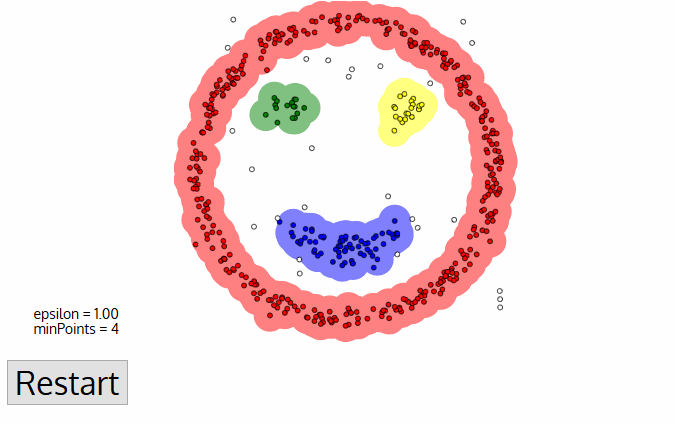
Para problemas ingeniosos, métodos ingeniosos. DBSCAN, por ejemplo. Detecta él solo dónde se acumulan los puntos y forma grupos a su alrededor. Se entiende enseguida si imaginas que los puntos son personas en una plaza. Buscamos tres personas cualesquiera que estén cerca y les pedimos que se tomen de la mano. Luego empiezan a tomar de la mano a los que tienen a su alcance. Seguimos así, en cadena, hasta que nadie pueda alcanzar a nadie más. Ese es el primer grupo. Repetimos hasta haber repartido a todos. Los que no tienen a nadie a quien tomar de la mano son valores atípicos, anomalías. En movimiento queda bastante bonito:
Si te interesa el agrupamiento, te recomiendo el artículo Cinco algoritmos de agrupamiento que todo científico de datos debe conocer.
Igual que la clasificación, el agrupamiento puede servir para detectar anomalías. ¿Un usuario se comporta de forma muy distinta a lo habitual nada más registrarse? Se bloquea y se abre un caso para que soporte compruebe si es un bot. Ni siquiera necesitamos saber qué es «comportarse normalmente»: volcamos en el modelo todas las acciones de los usuarios y que la máquina decida quién es normal aquí.
Comparado con la clasificación, este enfoque no funciona demasiado bien. Pero por probar no se pierde nada. A lo mejor sale.
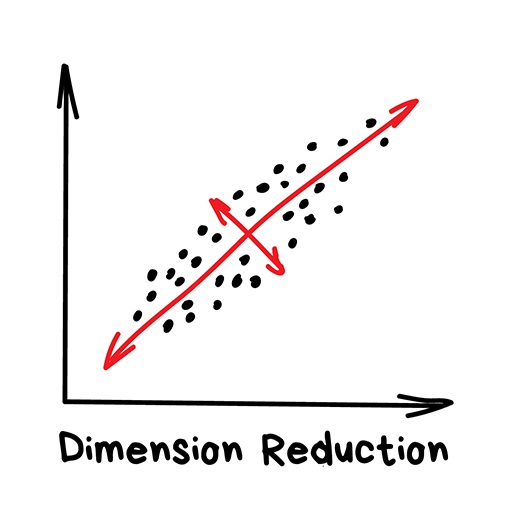
«Reúne características concretas en abstracciones de más alto nivel»
Hoy se usa para:
Algoritmos populares: análisis de componentes principales (PCA), descomposición en valores singulares (SVD), asignación latente de Dirichlet (LDA), análisis semántico latente (LSA, pLSA, GLSA), t-SNE (para visualización)
Al principio eran métodos de científicos de datos curtidos, de esos a los que les descargaban dos camiones de números y les decían que encontraran algo interesante ahí dentro. Cuando hacer unos gráficos en Excel ya no servía, se les ocurrió poner a las máquinas a buscar patrones por ellos. Así nacieron unos métodos a los que llamaron Dimension Reduction (reducción de dimensionalidad) o Feature Learning (aprendizaje de características).
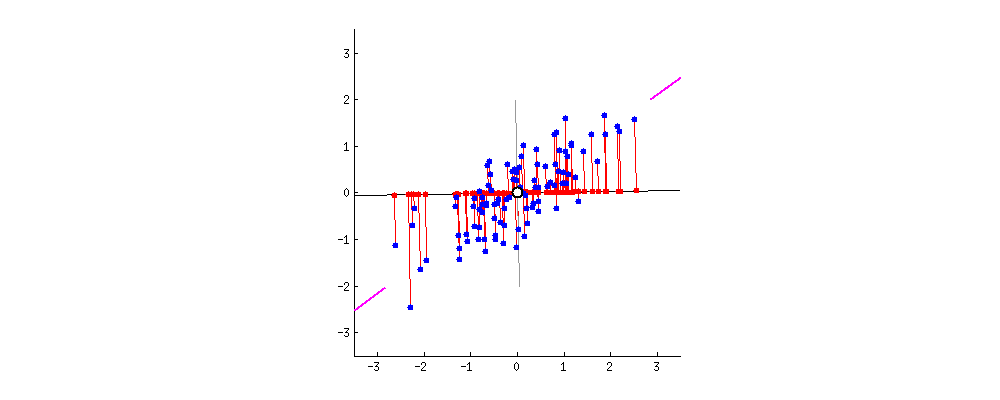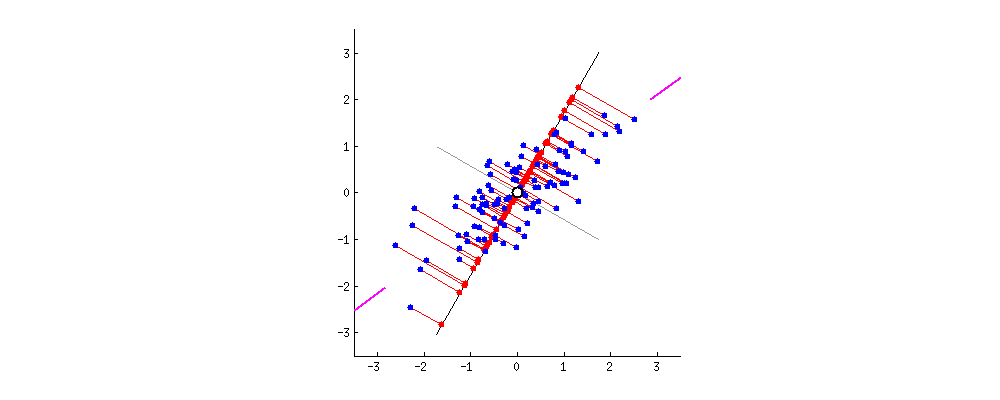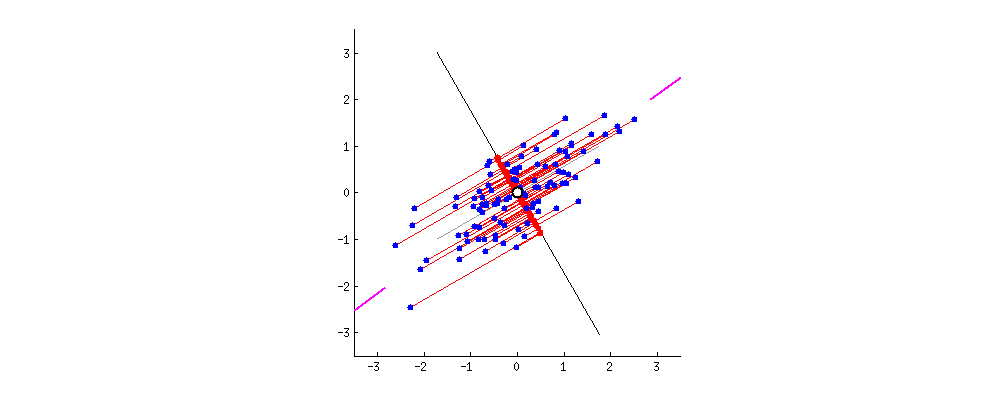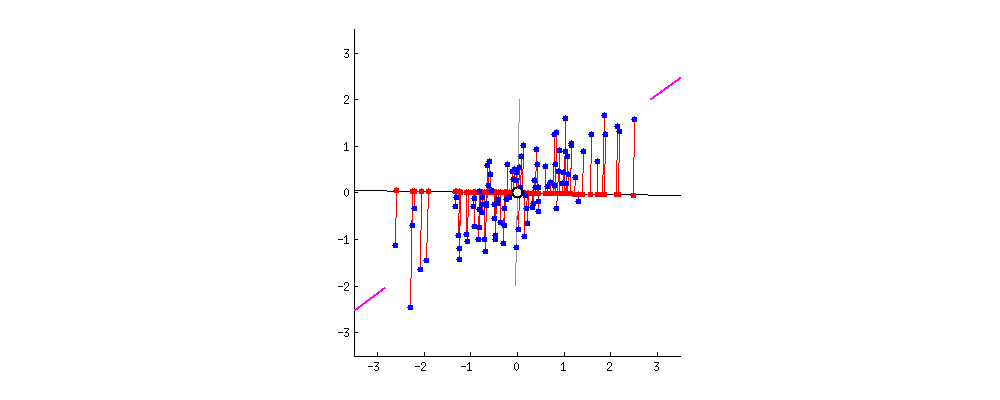
Lo útil de sus métodos para nosotros es que podemos reunir varias características en una sola y obtener una abstracción. Por ejemplo, los perros de orejas triangulares, hocicos largos y colas grandes se convierten en una abstracción muy práctica: «perros pastores». Sí, perdemos información sobre cada perro en particular, pero la nueva abstracción nos sirve mucho más que todos esos detalles de sobra. Además, con menos dimensiones el entrenamiento va mucho más rápido.
La herramienta resultó sorprendentemente buena para identificar los temas de los textos (modelado de temas o Topic Modelling). Pudimos pasar de las palabras concretas a los significados sin necesitar siquiera un profesor con una lista de categorías. Al algoritmo lo llamaron análisis semántico latente (LSA). La idea era que la frecuencia con que aparece una palabra en un texto depende del tema: en artículos científicos hay más términos técnicos; en noticias de política, más nombres de políticos. Sí, podríamos tomar todas las palabras de los artículos y agruparlas como hicimos más arriba con los negocios en el mapa, pero entonces perderíamos las relaciones útiles entre palabras. Por ejemplo, que pila en un documento y batería en otro se refieren a lo mismo.
La precisión de un sistema así es pésima. Ni lo intentes.
Necesitamos combinar de alguna manera las palabras y los documentos en una sola característica para no perder esas relaciones ocultas (latentes). De ahí el nombre del método. Resulta que la descomposición en valores singulares (SVD) resuelve esto sin problemas: a partir de palabras que aparecen juntas, nos descubre grupos temáticos útiles.
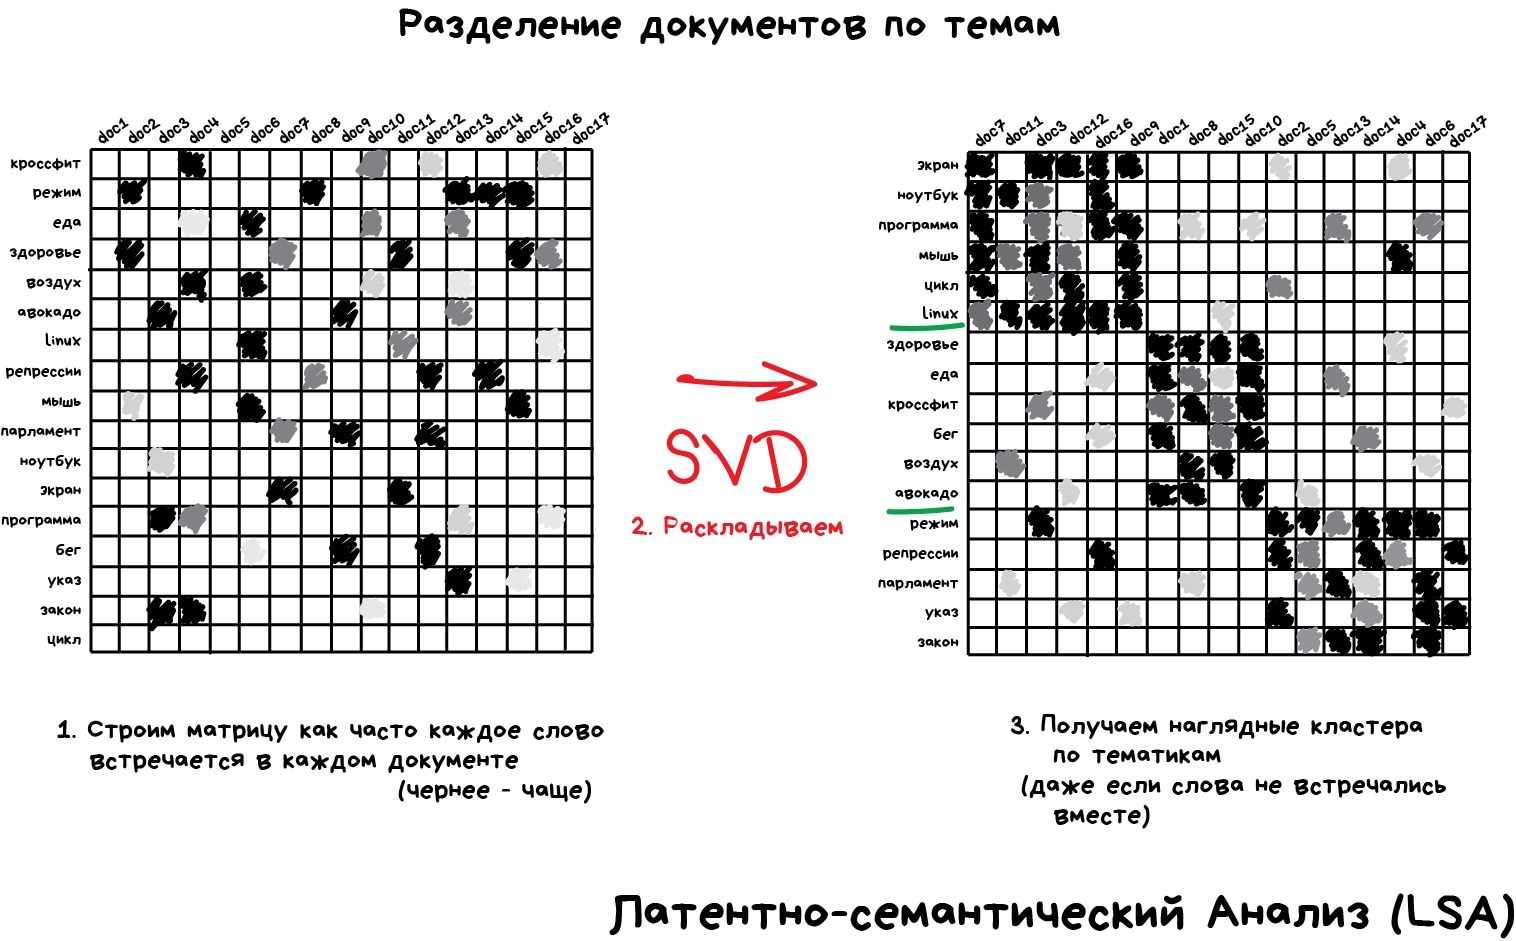
Para entenderlo, recomiendo el artículo Cómo reducir el número de dimensiones y sacarle provecho. Y hay un buen ejemplo práctico en El algoritmo LSA para buscar documentos parecidos.
Otra aplicación tremendamente popular de la reducción de dimensionalidad son los sistemas de recomendación y el filtrado colaborativo (ya escribí un artículo sobre los distintos tipos). Resulta que, si usas estos métodos para abstraer las puntuaciones que la gente les da a las películas, te sale un sistema bastante bueno para recomendar cine, música, juegos o lo que sea.
La abstracción resultante es difícil de entender para un cerebro humano. Pero cuando los investigadores empezaron a examinar de cerca las nuevas características, vieron que algunas se correlacionaban claramente con la edad del usuario (los niños jugaban más a Minecraft y veían más dibujos animados); otras, con ciertos géneros de cine, y otras incluso con el síndrome de buscarle un significado profundo a todo.
Una máquina que no sabía nada aparte de las puntuaciones de los usuarios llegó a semejantes honduras sin entenderlas siquiera. Nada mal. De aquí ya podemos pasar a hacer encuestas y escribir tesis sobre por qué a los tipos con barba les gustan los dibujos animados para degenerados.
Yandex tiene una buena charla sobre el tema: Cómo funcionan los sistemas de recomendación.
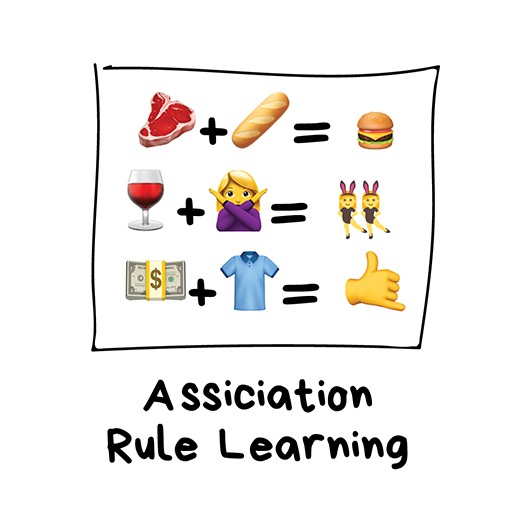
«Busca patrones en el flujo de pedidos»
Hoy se usa para:
Algoritmos populares: Apriori, Euclat, FP-growth
Aquí entran todos los métodos de análisis de cestas de compra, estrategias de marketing y otras secuencias.
Imagina que un cliente toma unas cervezas al fondo del supermercado y se dirige a la caja. ¿Conviene ponerle frutos secos de camino? ¿La gente suele comprar las dos cosas juntas? Cerveza y frutos secos, probablemente sí, pero ¿qué otros productos se compran juntos? Si tienes una cadena de hipermercados, la respuesta no siempre es evidente, pero un solo cambio bien pensado en la colocación de los productos puede darte muy buenos beneficios.
Lo mismo pasa con las tiendas en línea, donde la pregunta es más interesante todavía: ¿qué producto vendrá a buscar el cliente la próxima vez?
Por razones que se me escapan, la búsqueda de reglas es la categoría peor pensada, con diferencia, de todos los métodos de aprendizaje. Los métodos clásicos se limitan a recorrer a lo bruto todas las parejas de productos comprados usando árboles o conjuntos. Los algoritmos hacen el trabajo a medias: saben buscar patrones, pero no generalizarlos ni reproducirlos en ejemplos nuevos.
En la vida real, cada gran cadena se dedica a reinventar la rueda por su cuenta, y yo no he visto grandes avances en este campo. El techo tecnológico por aquí es montarse un sistema de recomendación como el del apartado anterior. Aunque igual es que este campo me queda lejos. Si sabes del tema, ¿nos cuentas en los comentarios?
«Suelta al robot en un laberinto y que encuentre la salida»
Hoy se usa para:
Algoritmos populares: Q-learning, SARSA, DQN, A3C, algoritmo genético
Por fin llegamos a algo que tiene pinta de inteligencia artificial de verdad. Por algún motivo, muchos autores ponen el aprendizaje por refuerzo a medio camino entre el supervisado y el no supervisado, pero yo no veo en qué se parecen. ¿En el nombre?
El aprendizaje por refuerzo se usa cuando el problema no es analizar datos, sino sobrevivir en un entorno real.
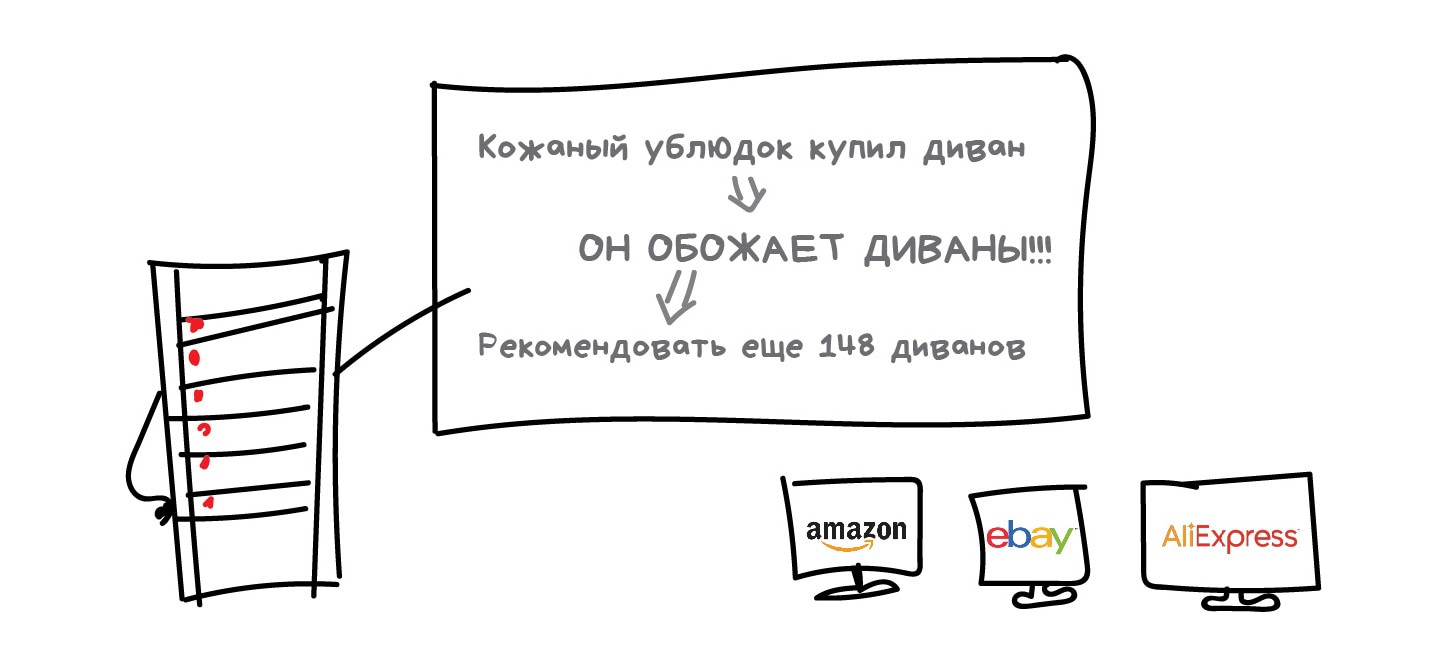
Ese entorno puede ser incluso un videojuego. Los robots que juegan a Mario ya estaban de moda hace cinco años. O puede ser el mundo real. Ahí está el piloto automático de Tesla, que aprende a no atropellar peatones, o el robot aspirador, cuya misión principal es conseguir que tu gato se cague de miedo con la máxima eficiencia posible.
Al robot le puede venir bien saber cosas del mundo que lo rodea, pero solo como referencia. Por muchos datos que reúna, nunca podrá prever todas las situaciones. Por eso su objetivo es minimizar los errores, no calcular todas las jugadas. El robot aprende a sobrevivir en su entorno sacándole el máximo partido: monedas recogidas en Mario, tiempo de viaje en el Tesla o número de sacos de carne liquidados, jejeje.
Sobrevivir en un entorno: esa es la idea del aprendizaje por refuerzo. Soltemos al pobre robot en la vida real, penalicémoslo cuando se equivoque y premiémoslo cuando haga algo bien. Con los humanos funciona bastante bien, ¿por qué no probar con los robots?
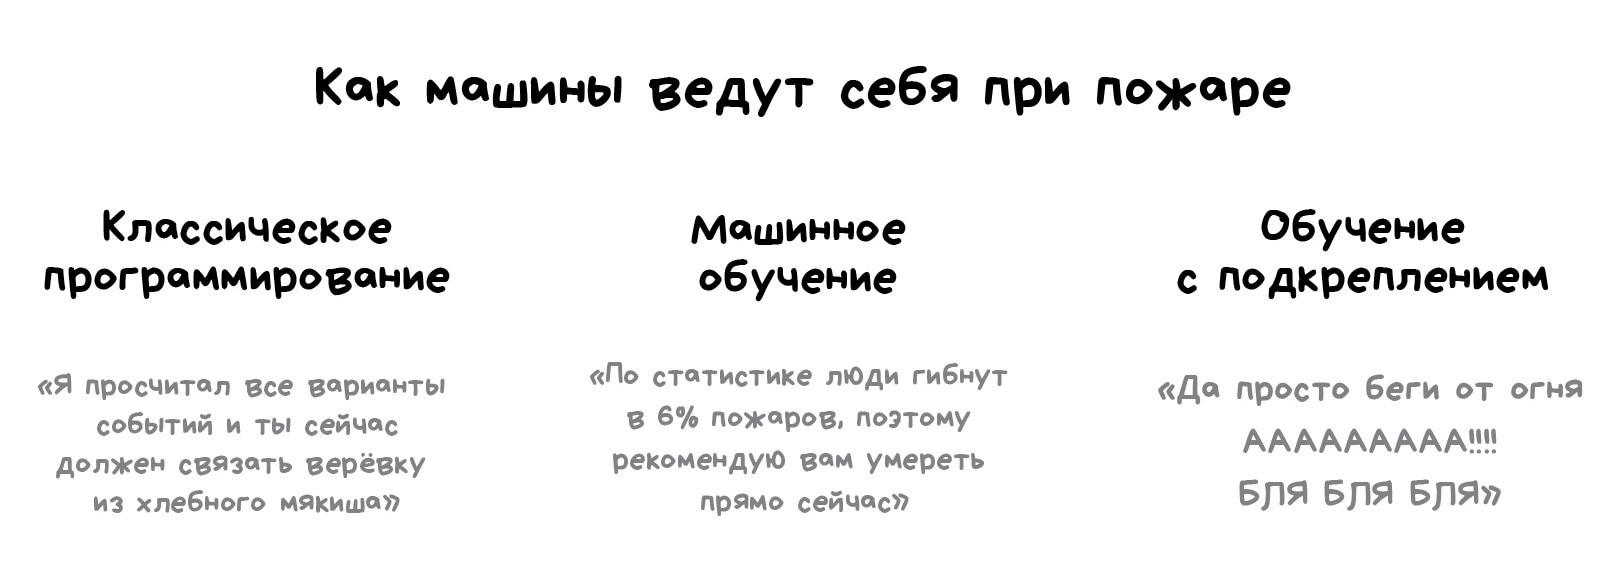
Así se entrenan los modelos inteligentes de robots aspiradores y los autos autónomos: les crean una ciudad virtual (muchas veces a partir de mapas de ciudades reales), la llenan de peatones al azar y los mandan a aprender a no matar a nadie. Cuando el robot ya se desenvuelve bien en ese GTA artificial, lo sacan a probar en calles de verdad.
La máquina no tiene que memorizar la ciudad en sí: es el enfoque sin modelo, o Model-Free. Claro que también existe el clásico enfoque con modelo, o Model-Based, pero con él nuestro auto tendría que memorizar un modelo del planeta entero, con todas las situaciones posibles en todos los cruces del mundo. Eso sencillamente no funciona. En el aprendizaje por refuerzo, la máquina no memoriza cada movimiento, sino que intenta generalizar las situaciones para sacar el máximo partido de cada una.
¿Recuerdas aquella noticia de hace un par de años, cuando una máquina le ganó a un humano al go? Y eso que poco antes se había demostrado que es físicamente imposible calcular todas las combinaciones: hay más que átomos en el universo. O sea, en ajedrez la máquina sí podía calcular todas las combinaciones futuras y ganar, pero en el go ese truco no servía. Así que se limitó a elegir la mejor salida para cada situación, y lo hizo con suficiente precisión para ganarle al cabrón de carne y hueso.
Esa idea es la base del algoritmo Q-learning y de sus derivados (SARSA y DQN). La Q viene de Quality, «calidad»: el robot aprende a elegir la acción de mayor calidad en cada situación y recuerda todas las situaciones como un simple proceso de Márkov.
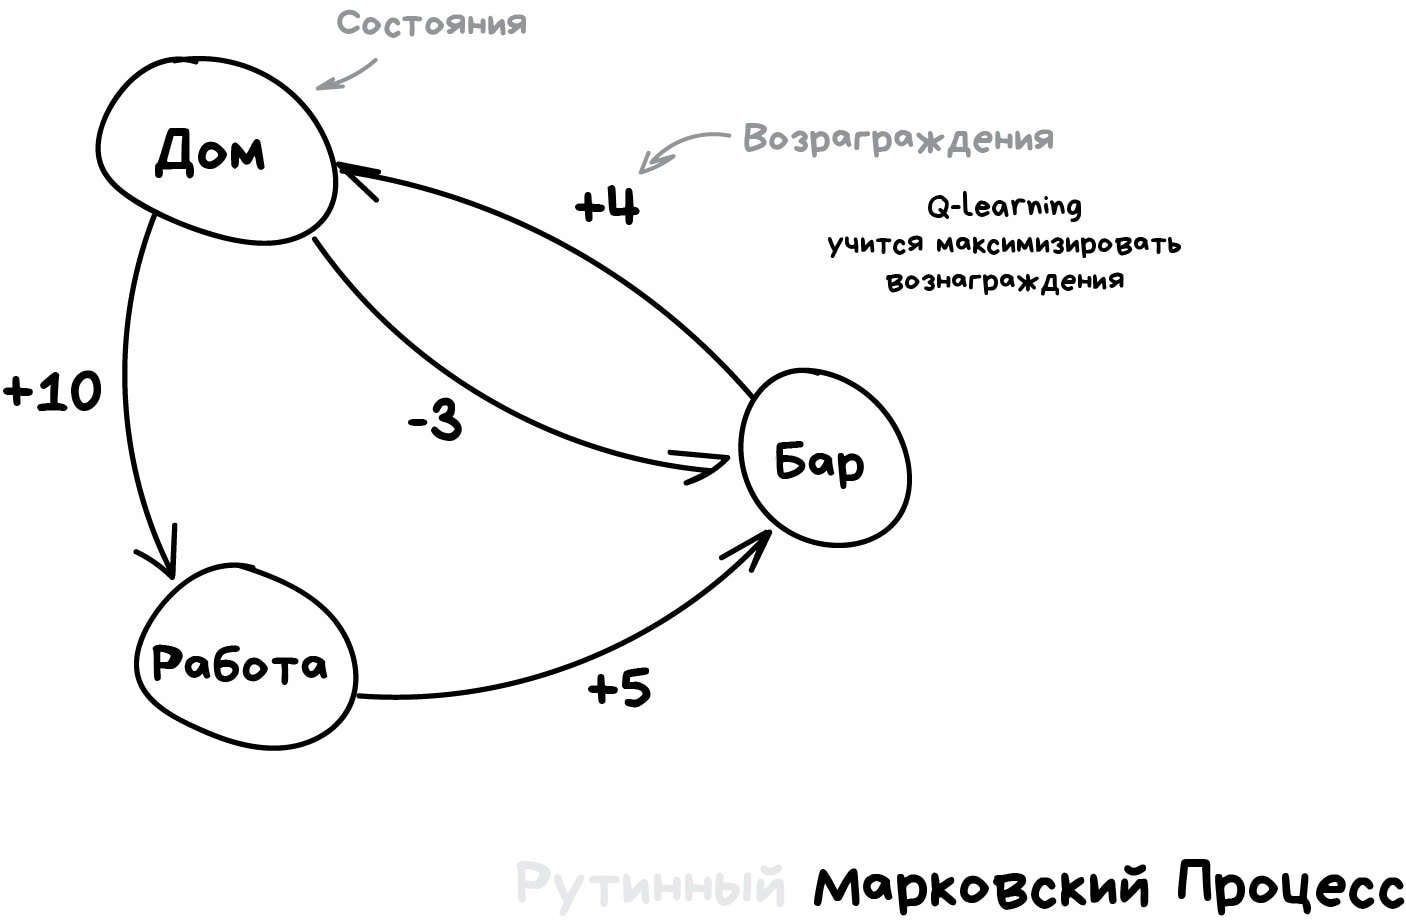
La máquina ejecuta millones de simulaciones en el entorno y recuerda las situaciones que se dieron y qué salidas le reportaron la mayor recompensa. Pero ¿cómo sabe si la situación en que está es una conocida o una completamente nueva? Un auto autónomo espera en un cruce y el semáforo se pone verde. ¿Puede avanzar? ¿Y si por la derecha viene una ambulancia a toda velocidad con las luces encendidas?
La respuesta: quién demonios sabe. No hay una fórmula mágica. Los investigadores trabajan en esto sin parar y cada cual se las arregla con sus propios parches. Unos programan las situaciones a mano, lo que les permite tratar excepciones como el dilema del tranvía. Otros van más a fondo y les dejan el trabajo a las redes neuronales: que lo averigüen ellas. Así, en vez de Q-learning, tenemos una Deep Q-Network (DQN).
A la gente de a pie, el aprendizaje por refuerzo le parece inteligencia de verdad. Porque ¡mira, la máquina toma sus propias decisiones en situaciones reales!. Ahora está de moda, avanza a toda velocidad y se está combinando con redes neuronales para ganar precisión (y no darse veinte veces contra la pata de la misma silla).
Así que, si te gusta ver el resultado de tu trabajo y quieres hacerte popular, lánzate al aprendizaje por refuerzo (qué término más horroroso en ruso, me da un escalofrío cada vez que lo digo) y abre un canal de YouTube. Hasta yo lo vería.
Recuerdo que en mis años de universidad estaban muy de moda los algoritmos genéticos (en el enlace hay una visualización muy buena). Sueltas un montón de robots en un entorno y los obligas a avanzar hacia la meta hasta que se mueran. Luego eliges a los mejores, los cruzas, añades unas mutaciones y los vuelves a soltar. En un par de miles de millones de años debería salir un ser inteligente. La teoría de la evolución en acción.
Pues bien, los algoritmos genéticos también entran en el aprendizaje por refuerzo y tienen una característica fundamental, comprobada tras años de práctica: no le hacen puta falta a nadie.
La humanidad todavía no ha logrado dar con un problema en el que sean de verdad más eficaces que los demás. Eso sí, para experimentos de estudiantes van de maravilla y te permiten conquistar a tu director de tesis con tus «logros» sin matarte a trabajar. En YouTube también tendrían éxito.
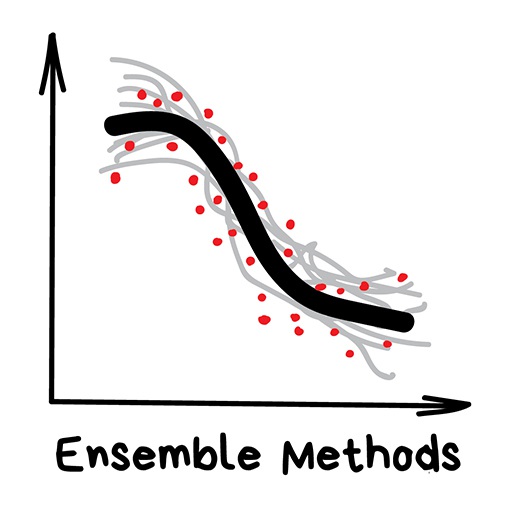
«Un montón de árboles tontos aprenden a corregirse los errores unos a otros»
Hoy se usan para:
Algoritmos populares: Random Forest, Gradient Boosting
Ahora sí, vamos con los métodos de los mayores. Los conjuntos y las redes neuronales son nuestros grandes combatientes de camino a la inevitable singularidad. Hoy dan los resultados más precisos y todas las grandes empresas los usan en producción. La diferencia es que de las redes neuronales se habla hasta por los codos, mientras que palabras como «boosting» y «bagging» probablemente solo asusten a los hípsteres de TechCrunch.
Con lo eficaces que son, la idea es de una sencillez casi insultante. Resulta que, si tomas unos cuantos métodos de aprendizaje no muy eficaces y les enseñas a corregirse los errores entre sí, el conjunto funciona mucho mejor que cualquiera de los métodos por separado.
De hecho, mejor todavía si los algoritmos son todo lo inestables que se pueda y sus respuestas cambian muchísimo al variar los datos de entrada. Por eso suelen usarse la regresión y los árboles de decisión: basta una sola anomalía considerable en los datos para que se les desbarate todo el modelo. En cambio, Bayes y k-NN no se usan nunca: serán tontos, pero son muy estables.
Un conjunto lo puedes armar como se te antoje. Si quieres, pica unos cuantos clasificadores al azar en un bol y báñalos en regresión. Eso sí, de la precisión ya no responde nadie. Así que hay tres maneras probadas de armar conjuntos.
Stacking Entrenamos varios algoritmos distintos y le pasamos sus resultados a uno último, que toma la decisión final. Como las chicas que les piden opinión a todas sus amigas antes de decidir si salen o no con un chico.
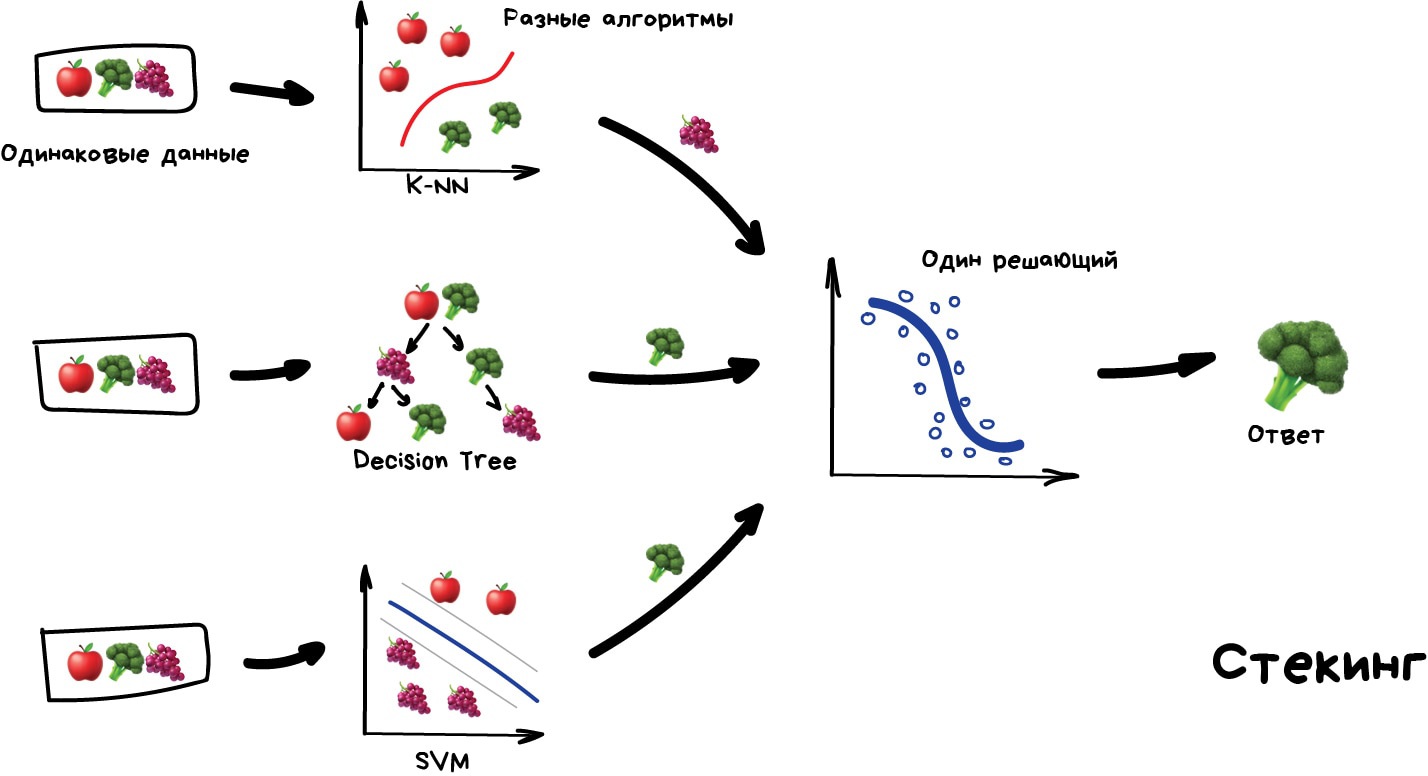
La palabra clave es «distintos»: repetir el mismo algoritmo entrenado con los mismos datos no tiene sentido. Cuáles uses es cosa tuya, aunque para tomar la decisión final lo más habitual es usar una regresión.
Por lo que he visto, en la práctica se usa poco el stacking, porque los otros dos métodos suelen ser más precisos.
Bagging También llamado Bootstrap AGGregatING. Entrenamos el mismo algoritmo muchas veces con muestras aleatorias de los datos originales. Al final promediamos las respuestas.
Dentro de una muestra aleatoria puede haber datos repetidos. Es decir, del conjunto 1-2-3 podemos sacar las muestras 2-2-3, 1-2-2, 3-1-2, y así hasta aburrirnos. Con ellas entrenamos varias veces el mismo algoritmo y al final decidimos la respuesta por simple votación.
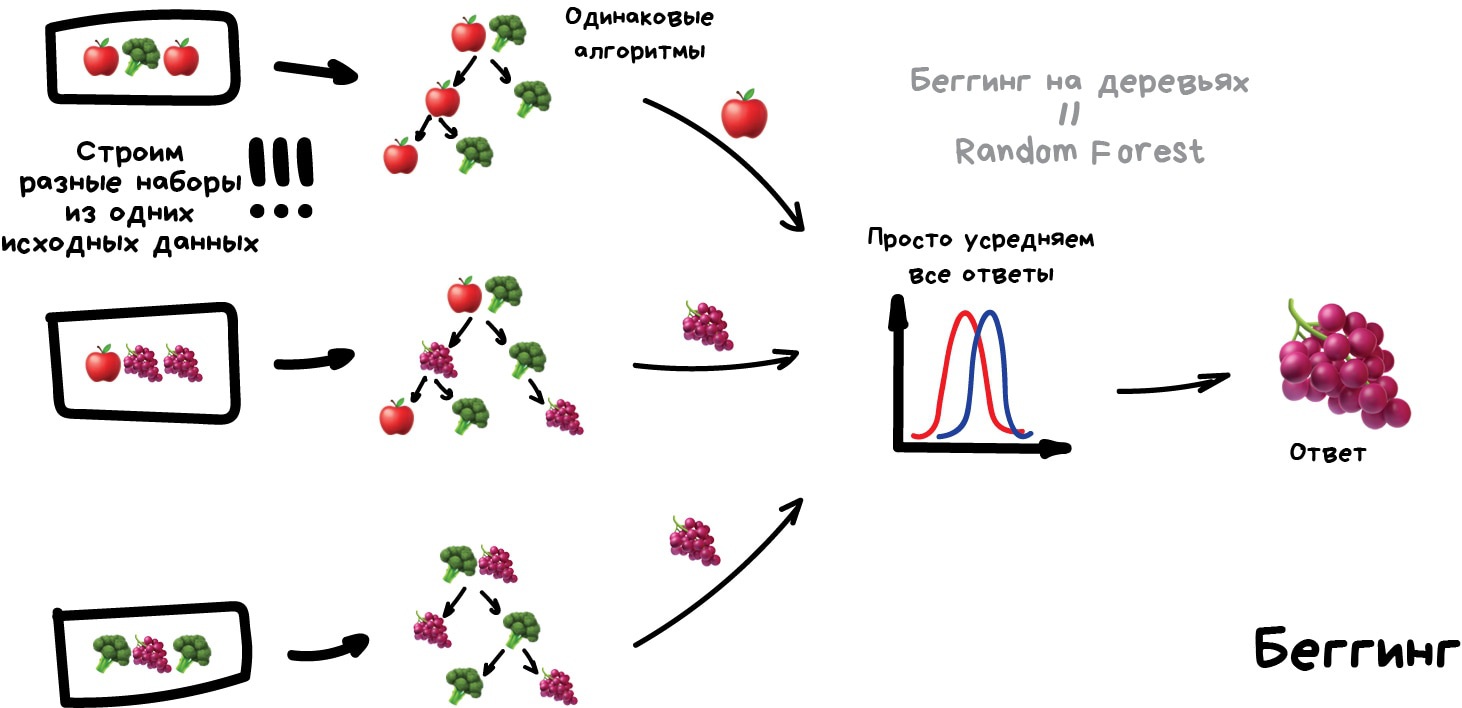
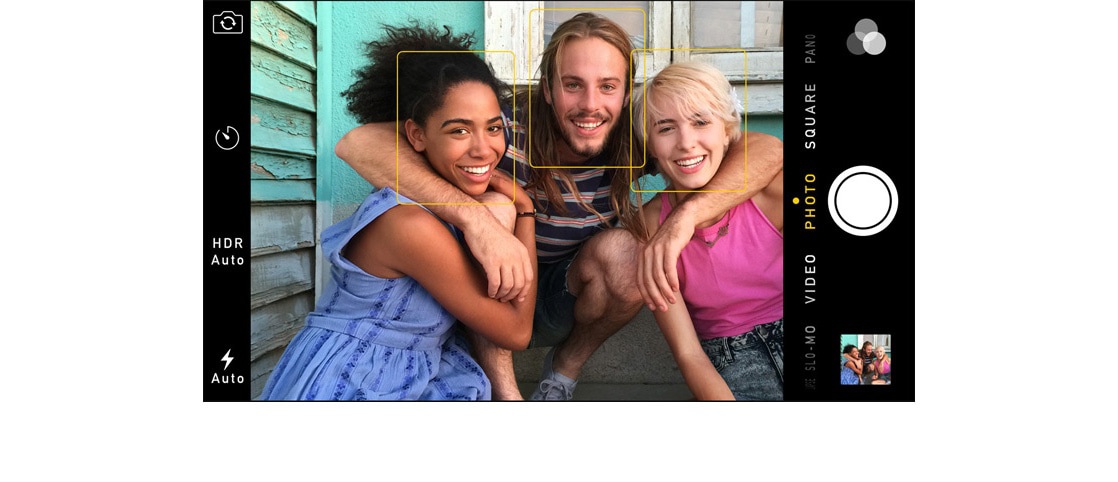
El ejemplo más popular de bagging es el bosque aleatorio o Random Forest: es bagging con árboles, justo lo que aparece en el dibujo. Cuando abres la cámara del teléfono y ves que ha enmarcado con rectángulos amarillos las caras que salen en la imagen, lo más probable es que sea cosa de esos árboles. Una red neuronal sería demasiado lenta para trabajar en tiempo real. El bagging, en cambio, es ideal, porque puede calcular los árboles en paralelo usando todos los shaders de la tarjeta gráfica.
Esa tremenda facilidad para trabajar en paralelo le da al bagging una ventaja incluso frente al método siguiente, que es más preciso pero solo funciona en un hilo. Aunque se podría dividir en segmentos y lanzar varios... Pero qué te voy a explicar, que ya eres grande.
Boosting Entrenamos los algoritmos uno tras otro. Cada uno presta especial atención a los casos en los que se equivocó el anterior.
Como en el bagging, tomamos muestras de los datos originales, pero esta vez no del todo al azar. En cada muestra nueva incluimos parte de los datos con los que falló el algoritmo anterior. Es como si diéramos clases de refuerzo al nuevo algoritmo con los errores de su predecesor.
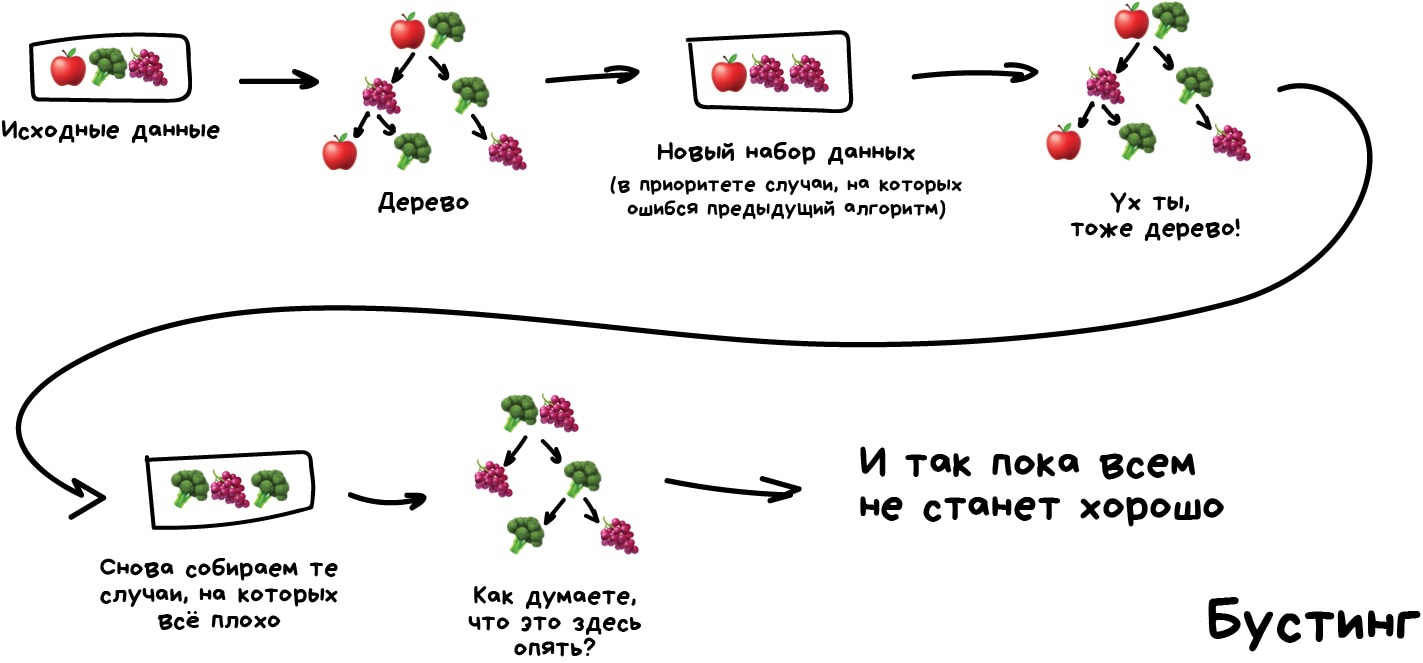
Ventajas: una precisión de clasificación descomunal, hasta ilegal en algunos países, que sería la envidia de todas las abuelas del barrio. La desventaja ya la dije: no se puede paralelizar. Aun así, es más rápido que las redes neuronales, que al lado del ágil boosting parecen camiones Kamaz cargados de arena.
Si quieres un ejemplo real de boosting, abre Yandex y haz una búsqueda. ¿Oyes cómo retumban los árboles de MatrixNet mientras te ordena los resultados? Pues eso es. Hoy Yandex funciona enteramente con boosting. De Google no sé.
Hoy hay tres métodos de boosting muy populares. El artículo CatBoost vs. LightGBM vs. XGBoost explica bien las diferencias.
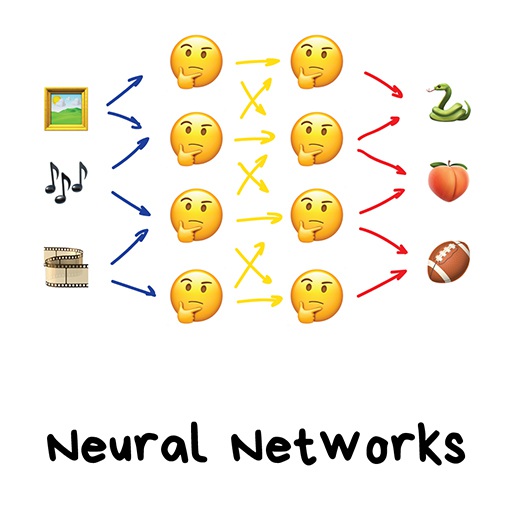
«Tenemos una red de mil capas, decenas de tarjetas gráficas y todavía no se nos ha ocurrido para qué podría servir. ¡Que dibuje gatitos!»
Hoy se usan para:
Arquitecturas populares: perceptrón, redes convolucionales (CNN), redes recurrentes (RNN), autocodificadores
Si nunca te han intentado explicar una red neuronal con el ejemplo de cómo supuestamente funciona el cerebro, cuéntame: ¿dónde te escondiste? Yo voy a evitar esas analogías y a explicarlo como a mí me gusta.
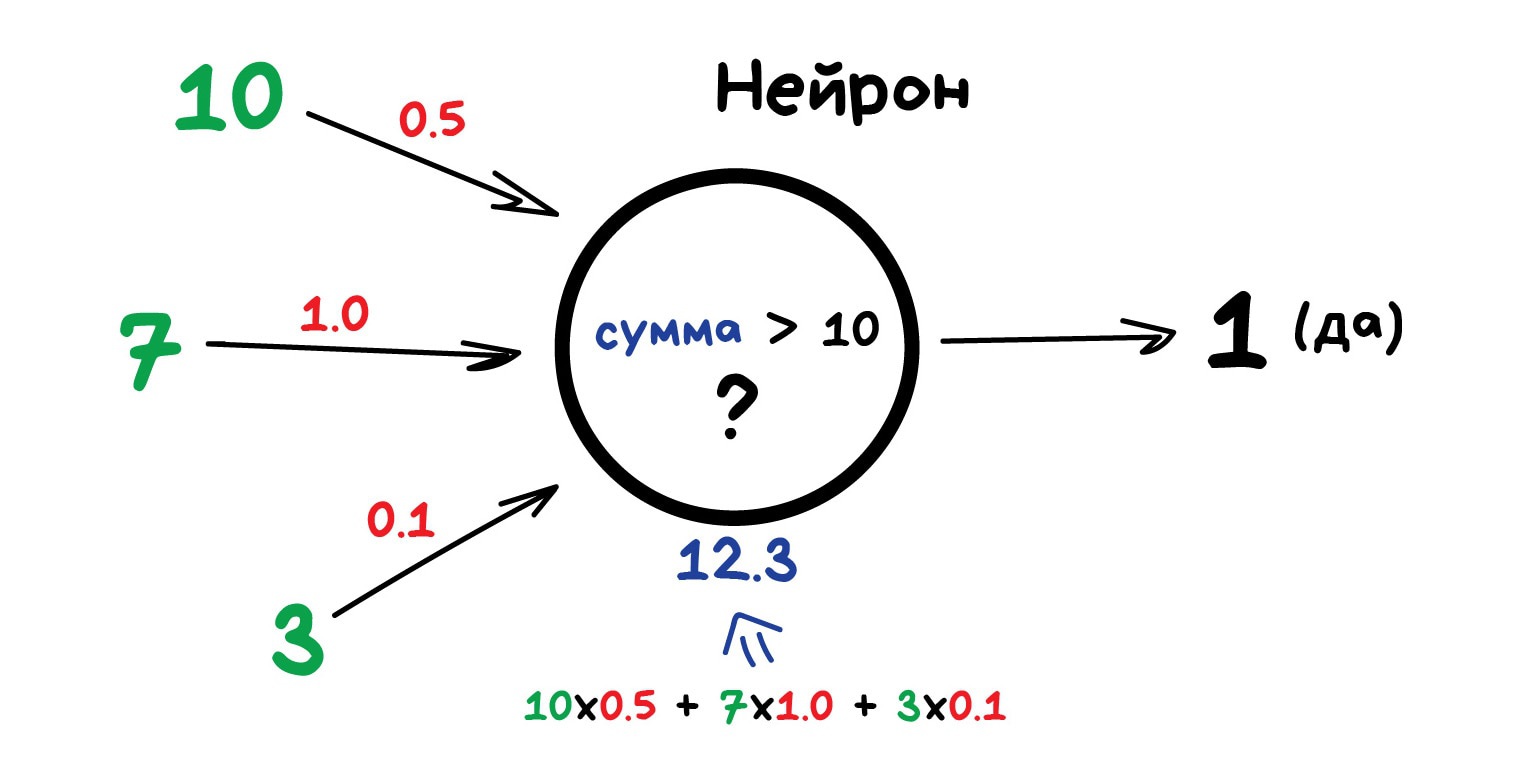
Una red neuronal es un conjunto de neuronas y de conexiones entre ellas. Lo más fácil es imaginar cada neurona como una función con un montón de entradas y una salida. Su trabajo consiste en tomar los números que le llegan por las entradas, aplicarles una función y mandar el resultado a la salida. Un ejemplo sencillo de neurona útil: suma todos los números de las entradas y, si la suma es mayor que N, devuelve un uno; si no, un cero.
Las conexiones son los canales por los que las neuronas se mandan numeritos. Cada conexión tiene un peso, su único parámetro. Puedes imaginártelo como la fuerza de la conexión. Si el número 10 pasa por una conexión con un peso de 0,5, se convierte en 5. La neurona no se para a mirar qué le ha llegado: lo suma todo. Para eso están los pesos, para controlar a qué entradas debe reaccionar la neurona y a cuáles no.
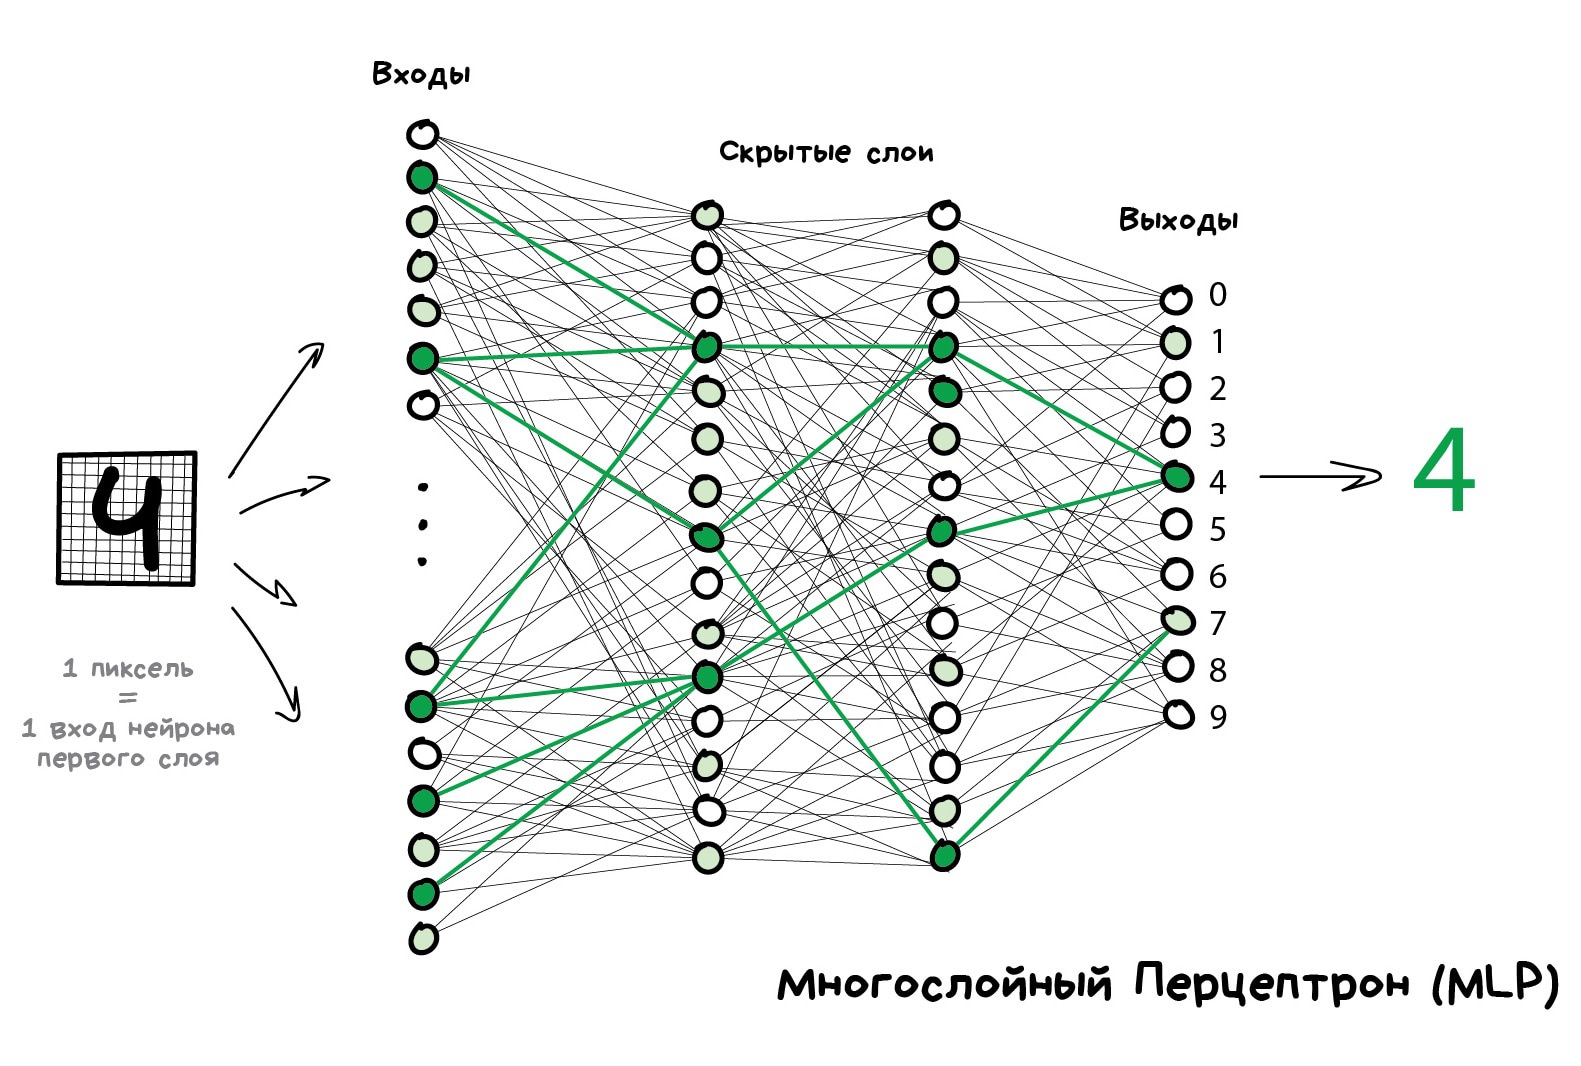
Para que la red no se convirtiera en una anarquía, se decidió conectar las neuronas por capas y no como cayeran. Las neuronas de una capa no están conectadas entre sí, pero sí con las de la capa siguiente y la anterior. En una red así, los datos circulan en una sola dirección: de las entradas de la primera capa a las salidas de la última.
Si le metes suficientes capas a la red y pones bien los pesos, pasa lo siguiente: le das como entrada, por ejemplo, la imagen de un 4 escrito a mano. Los píxeles negros activan las neuronas a las que están conectados, estas activan las capas siguientes y así sucesivamente hasta que se enciende justo la salida que corresponde al cuatro. Objetivo cumplido.
A la hora de programar, claro, nadie se pone a escribir neuronas y conexiones una por una. Todo se representa con matrices y se calcula mediante multiplicaciones de matrices, porque hace falta velocidad. Tengo dos videos favoritos que explican de forma muy visual todo este proceso con el ejemplo del reconocimiento de números escritos a mano. Míralos si quieres entenderlo bien.
Una red así, con varias capas y todas las neuronas de una capa conectadas a las de la siguiente, se llama perceptrón multicapa (MLP) y se considera la arquitectura más sencilla para principiantes. Yo nunca me la he encontrado en un problema real.
Una vez construida la red, nos toca ajustar los pesos para que las neuronas reaccionen a las señales que nos interesan. Y aquí conviene recordar que tenemos datos: ejemplos de «entradas» y de las «salidas» correctas. Vamos a mostrarle a la red el dibujo del mismo 4 y a decirle: «Ajusta tus pesos de manera que, cuando te llegue esta entrada, siempre se encienda el cuatro en la salida».
Al principio, los pesos se asignan al azar. Le mostramos un número a la red, nos devuelve una respuesta cualquiera (los pesos todavía no están ajustados) y comparamos ese resultado con el que queríamos. Luego recorremos la red al revés, de las salidas a las entradas, y le decimos a cada neurona: «A ver, tú, aquí te activaste por algún motivo y por tu culpa salió todo mal. La próxima vez reacciona un poco menos a esta conexión y un poco más a aquella, ¿sí?».
Al cabo de unos cien mil ciclos de «probar, comprobar, castigar», hay esperanza de que los pesos se hayan ajustado como queríamos. El nombre técnico es backpropagation o «retropropagación del error». Lo curioso es que se tardó veinte años en descubrir este método. Antes, las redes neuronales se entrenaban como se podía.
Mi segundo video favorito explica todo el proceso con más detalle, pero igual de sencillo, paso a paso.
Una red neuronal bien entrenada podía hacerse pasar por cualquiera de los algoritmos de este artículo y muchas veces hasta funcionaba con mayor precisión. Esa versatilidad las hizo tremendamente populares. Por fin tenemos la arquitectura del cerebro humano, decían. Solo hay que juntar muchas capas y entrenarlas con los datos que sean, esperaban. Luego llegó el primer invierno de la IA, después el deshielo y luego una segunda ola de decepción.
Resultó que entrenar una red con muchas capas requería una potencia de cálculo impensable en aquella época. Hoy, cualquier trasto para videojuegos con unas GeForce supera en potencia a todo un centro de datos de entonces. En aquel momento ni siquiera había esperanzas de llegar a eso y todo el mundo acabó muy decepcionado con las redes neuronales.
Hasta que hace unos diez años estalló el boom del aprendizaje profundo.
En la Wikipedia en inglés hay una cronología del aprendizaje automático en la que se ven muy bien los picos de entusiasmo y las olas de desesperación.
En 2012, una red neuronal convolucional arrasó en la competición ImageNet y el mundo se acordó de repente de los métodos de aprendizaje profundo que ya se habían descrito en los noventa. ¡Ahora sí tenemos tarjetas gráficas!
Lo que distinguía al aprendizaje profundo de las redes neuronales clásicas eran los nuevos métodos de entrenamiento, que podían con redes de mayor tamaño. Hoy solo los teóricos se ponen a distinguir qué aprendizaje cuenta como profundo y cuál no tanto. Los que nos dedicamos a la práctica usamos bibliotecas «profundas» tan populares como Keras, TensorFlow o PyTorch hasta para montar una minirred de cinco capas. Sencillamente porque son más cómodas que todo lo que había antes. Y a todo esto lo llamamos redes neuronales, sin más.
Voy a contarte cómo funcionan las dos principales de hoy en día.
Las redes convolucionales están en su momento de mayor popularidad. Se usan para buscar objetos en fotos y videos, reconocer caras, transferir estilos, generar y completar imágenes, crear efectos de cámara lenta y mejorar la calidad de las fotos. Hoy las CNN se usan dondequiera que haya imágenes o videos. Hasta tu iPhone tiene unas cuantas redes de estas mirando tus fotos sin ropa para reconocer los objetos que aparecen en ellas. Si es que hay algo que reconocer, jejeje.
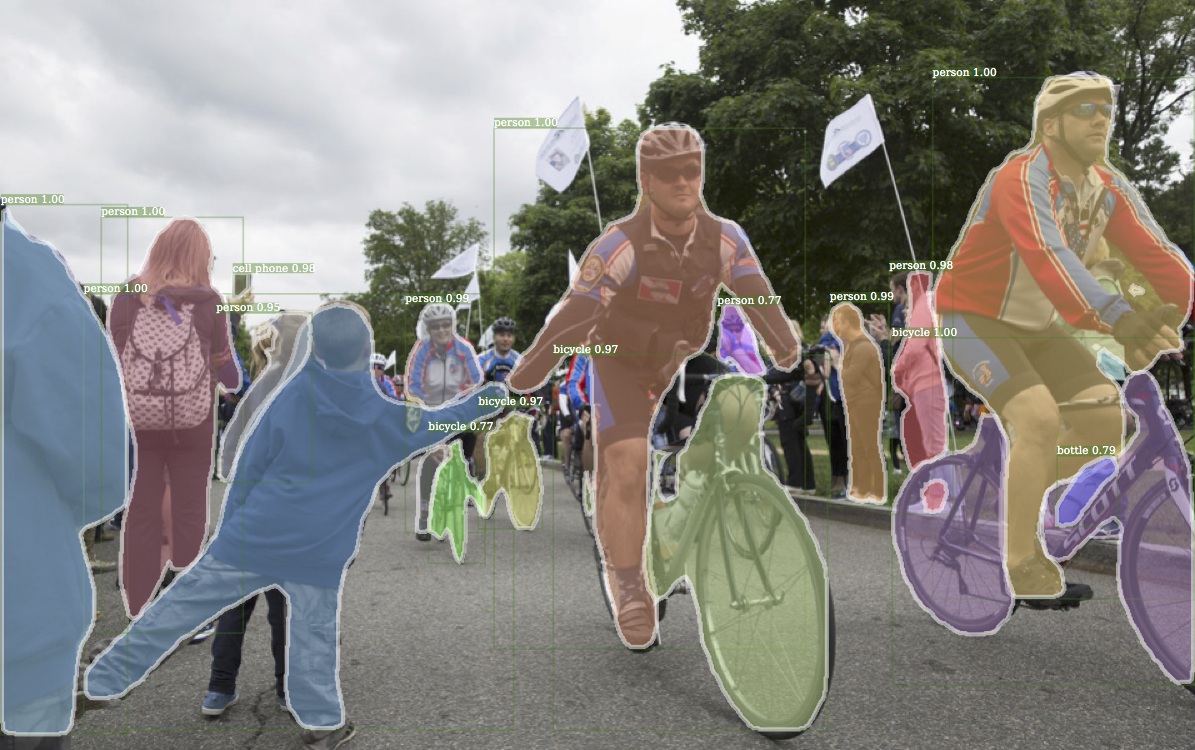
La imagen de arriba es obra de la biblioteca Detectron, cuyo código acaba de publicar Facebook.
El problema con las imágenes siempre fue que no estaba claro cómo extraer sus características. Un texto puedes dividirlo en oraciones y buscar las propiedades de las palabras en diccionarios. Las imágenes, en cambio, había que etiquetarlas a mano, explicándole a la máquina dónde estaban las orejitas del gato en la foto y dónde la cola. Este enfoque hasta tenía nombre, «diseño manual de características», y antes todo el mundo lo hacía así.
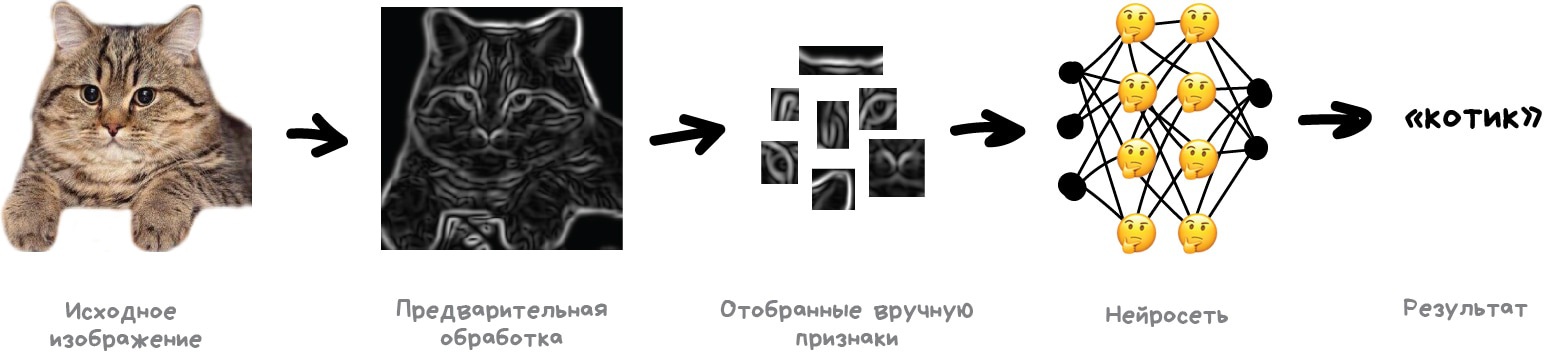
Hacerlo a mano tiene unos cuantos problemas.
Primero, si el gatito de la foto agacha las orejas o se da la vuelta, se acabó: la red neuronal no ve nada.
Segundo, intenta nombrar ahora mismo al menos diez rasgos que distingan a los gatos de otros animales. Yo no pude. Y sin embargo, si de noche pasa corriendo una mancha negra a mi lado, hasta de reojo sé decir si es un gato o una rata. Porque uno no se fija solo en la forma de las orejas y el número de patas: se fija en un montón de características en las que ni siquiera piensa. Así que no las entiende ni puede explicárselas a la máquina.
Entonces la máquina tiene que aprender a encontrar esas características por su cuenta, combinando líneas sencillas. Hagamos esto: primero dividimos la imagen en bloques de 8x8 píxeles y elegimos qué línea predomina en cada bloque: una horizontal [-], una vertical [|] o una de las diagonales [/]. Pueden destacar dos o tres; también pasa, no siempre lo tenemos tan claro.
A la salida tendremos varios arreglos de palitos que, en el fondo, son las características más sencillas que indican dónde hay un contorno en la imagen. Siguen siendo imágenes, solo que hechas de palitos. Así que podemos volver a tomar un bloque de 8x8 y ver cómo se combinan esos palitos entre sí. Y otra vez. Y otra.
Esta operación se llama convolución, de ahí el nombre del método. Podemos representar una convolución como una capa de una red neuronal, porque una neurona puede ser una función cualquiera.
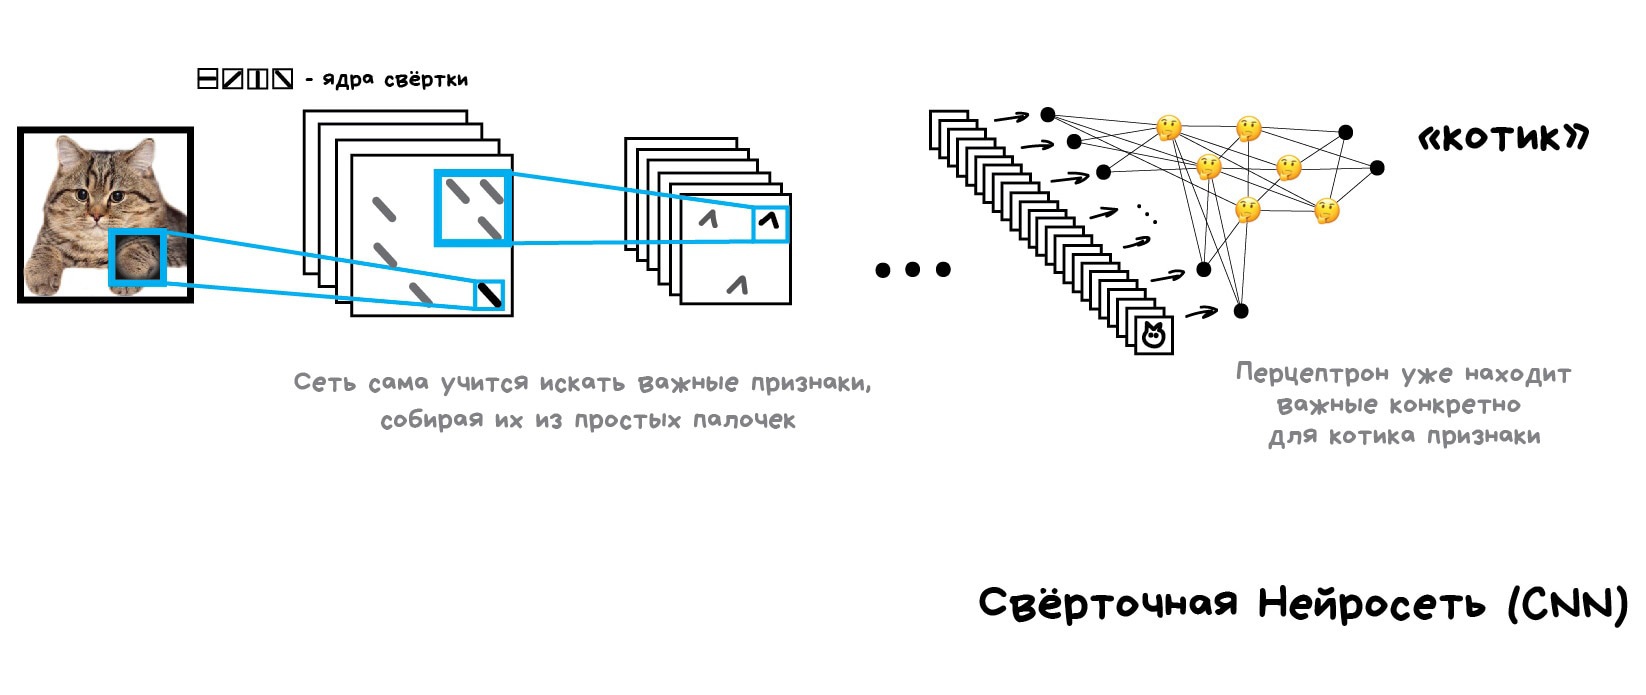
Cuando hacemos pasar un montón de fotos de gatos por nuestra red, ella sola les asigna más peso a las combinaciones de palitos que ha visto más veces. Da igual que sea la línea recta del lomo o una figura geométrica compleja como el hocico: algo se va a activar con fuerza.
En la salida ponemos un simple perceptrón, que mira qué combinaciones se han activado y dice de quién son más características: de un gato o de un perro.
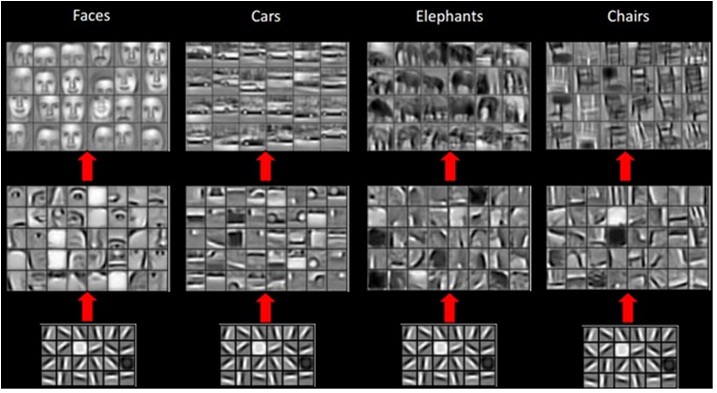
Lo bonito de la idea es que nos ha salido una red neuronal que encuentra por sí sola los rasgos distintivos de los objetos. Ya no tenemos que elegirlos a mano. Podemos darle todas las imágenes que queramos de cualquier objeto: basta con buscar un millón de fotos en Google. La red construye sus propios mapas de características a partir de palitos y aprende a identificar lo que sea.
Hasta tengo un chiste malo al respecto:
Dale un pez a una red neuronal y sabrá reconocer peces el resto de su vida. Dale una caña de pescar y también sabrá reconocer cañas de pescar el resto de su vida...
La segunda arquitectura más popular hoy en día. Gracias a las redes recurrentes tenemos cosas tan útiles como la traducción automática de textos (aquí está mi artículo sobre el tema) y la síntesis de voz por computadora. Se usan para resolver todo tipo de problemas con secuencias, ya sean de voz, texto o música.
¿Recuerdas los sintetizadores de voz de antes, como Microsoft Sam en Windows XP? Pronunciaba las palabras letra por letra, intentando pegarlas como podía, y sonaba de lo más gracioso. Ahora escucha a Alexa de Amazon o a Alisa de Yandex: ya no solo pronuncian las palabras sin equivocarse, ¡hasta saben dónde poner el énfasis en la frase!
Eso es porque a los asistentes de voz modernos se les enseña a hablar con frases, no con letras sueltas. Pero tampoco podemos hacer que la red produzca una frase entera de golpe: tendría que memorizar todas las frases del idioma y sería gigantesca. Lo que nos salva es que el texto, el habla y la música son secuencias. Cada palabra o sonido es una unidad por sí sola, pero depende de las anteriores. Si se pierde esa relación, lo que sale es dubstep.
Enseñarle a una red a pronunciar palabras o letras sueltas es bastante fácil. Tomamos un montón de archivos de audio etiquetados por palabras y entrenamos la red para que, al recibir una palabra, nos devuelva una secuencia de señales que se parezca a su pronunciación. La comparamos con la grabación original del locutor e intentamos acercarnos lo más posible a ese ideal. Para eso sirve hasta un perceptrón.
Pero con la secuencia volvemos a tener problemas: el perceptrón no recuerda lo que ha generado antes. Para él, cada vez es la primera. A alguien se le ocurrió añadir memoria a cada neurona. Así nacieron las redes recurrentes, en las que cada neurona recordaba todas sus respuestas anteriores y las usaba como entrada adicional la próxima vez. O sea, la neurona podía dejarle dicho a su yo del futuro: «Oye, el próximo sonido tiene que ser un poco más agudo, aquí había una vocal» (un ejemplo muy simplificado).
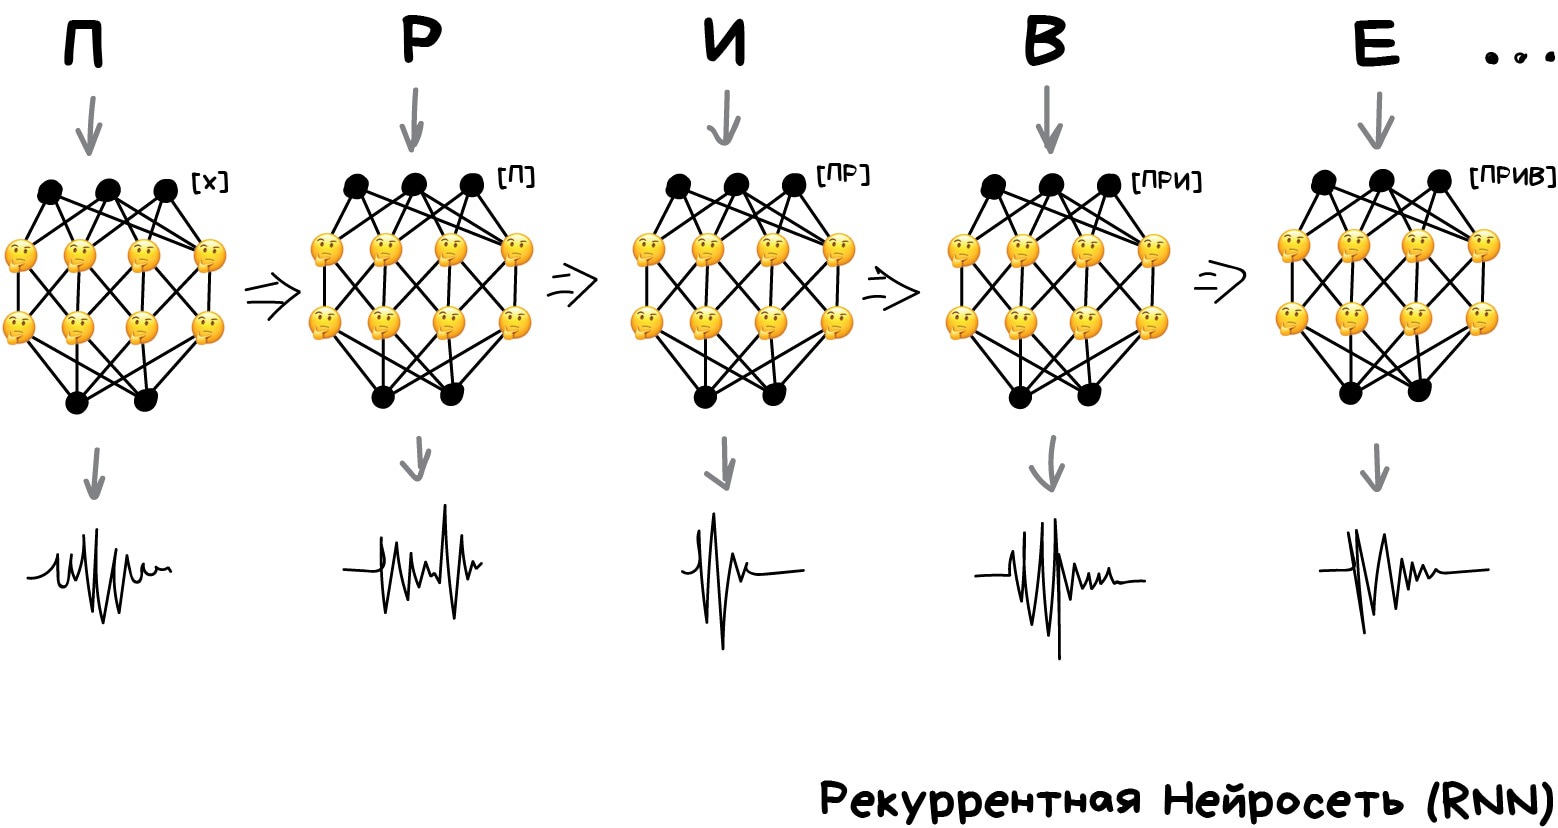
Solo había un problema: si cada neurona recordaba todos sus resultados anteriores, la red acababa teniendo tal barbaridad de entradas que entrenar todas esas conexiones se volvía imposible.
Si una red neuronal no sabe olvidar, no hay quien le enseñe nada (a los humanos nos pasa lo mismo).
Al principio resolvieron el problema por las malas: le recortaron la memoria a cada neurona. Pero luego se les ocurrió usar como «memoria» unas celdas especiales, parecidas a la memoria de una computadora o a los registros de un procesador. En cada celda se podía escribir un número, leerlo o borrarlo. Las llamaron celdas de memoria a corto y largo plazo (LSTM).
Cuando una neurona quería dejarse un recordatorio para más tarde, lo anotaba en una celda. Cuando ya no necesitaba nada de ese historial (porque había terminado la frase, por ejemplo), se borraban las celdas y solo quedaban las conexiones «a largo plazo», como en un perceptrón clásico. Dicho de otro modo, la red aprendía no solo a ajustar sus conexiones, sino también a dejarse recordatorios.
Sencillo, ¡pero funciona!
Para entrenar estas redes se empezaron a sacar textos leídos en voz alta de todas partes. Hasta BuzzFeed pudo descargar videos de los discursos de Obama y enseñarle a una red a hablar con su voz bastante bien. El ejemplo deja ver que imitar una voz es un problema bastante sencillo para las máquinas de hoy. Con el video es más complicado. Por ahora.

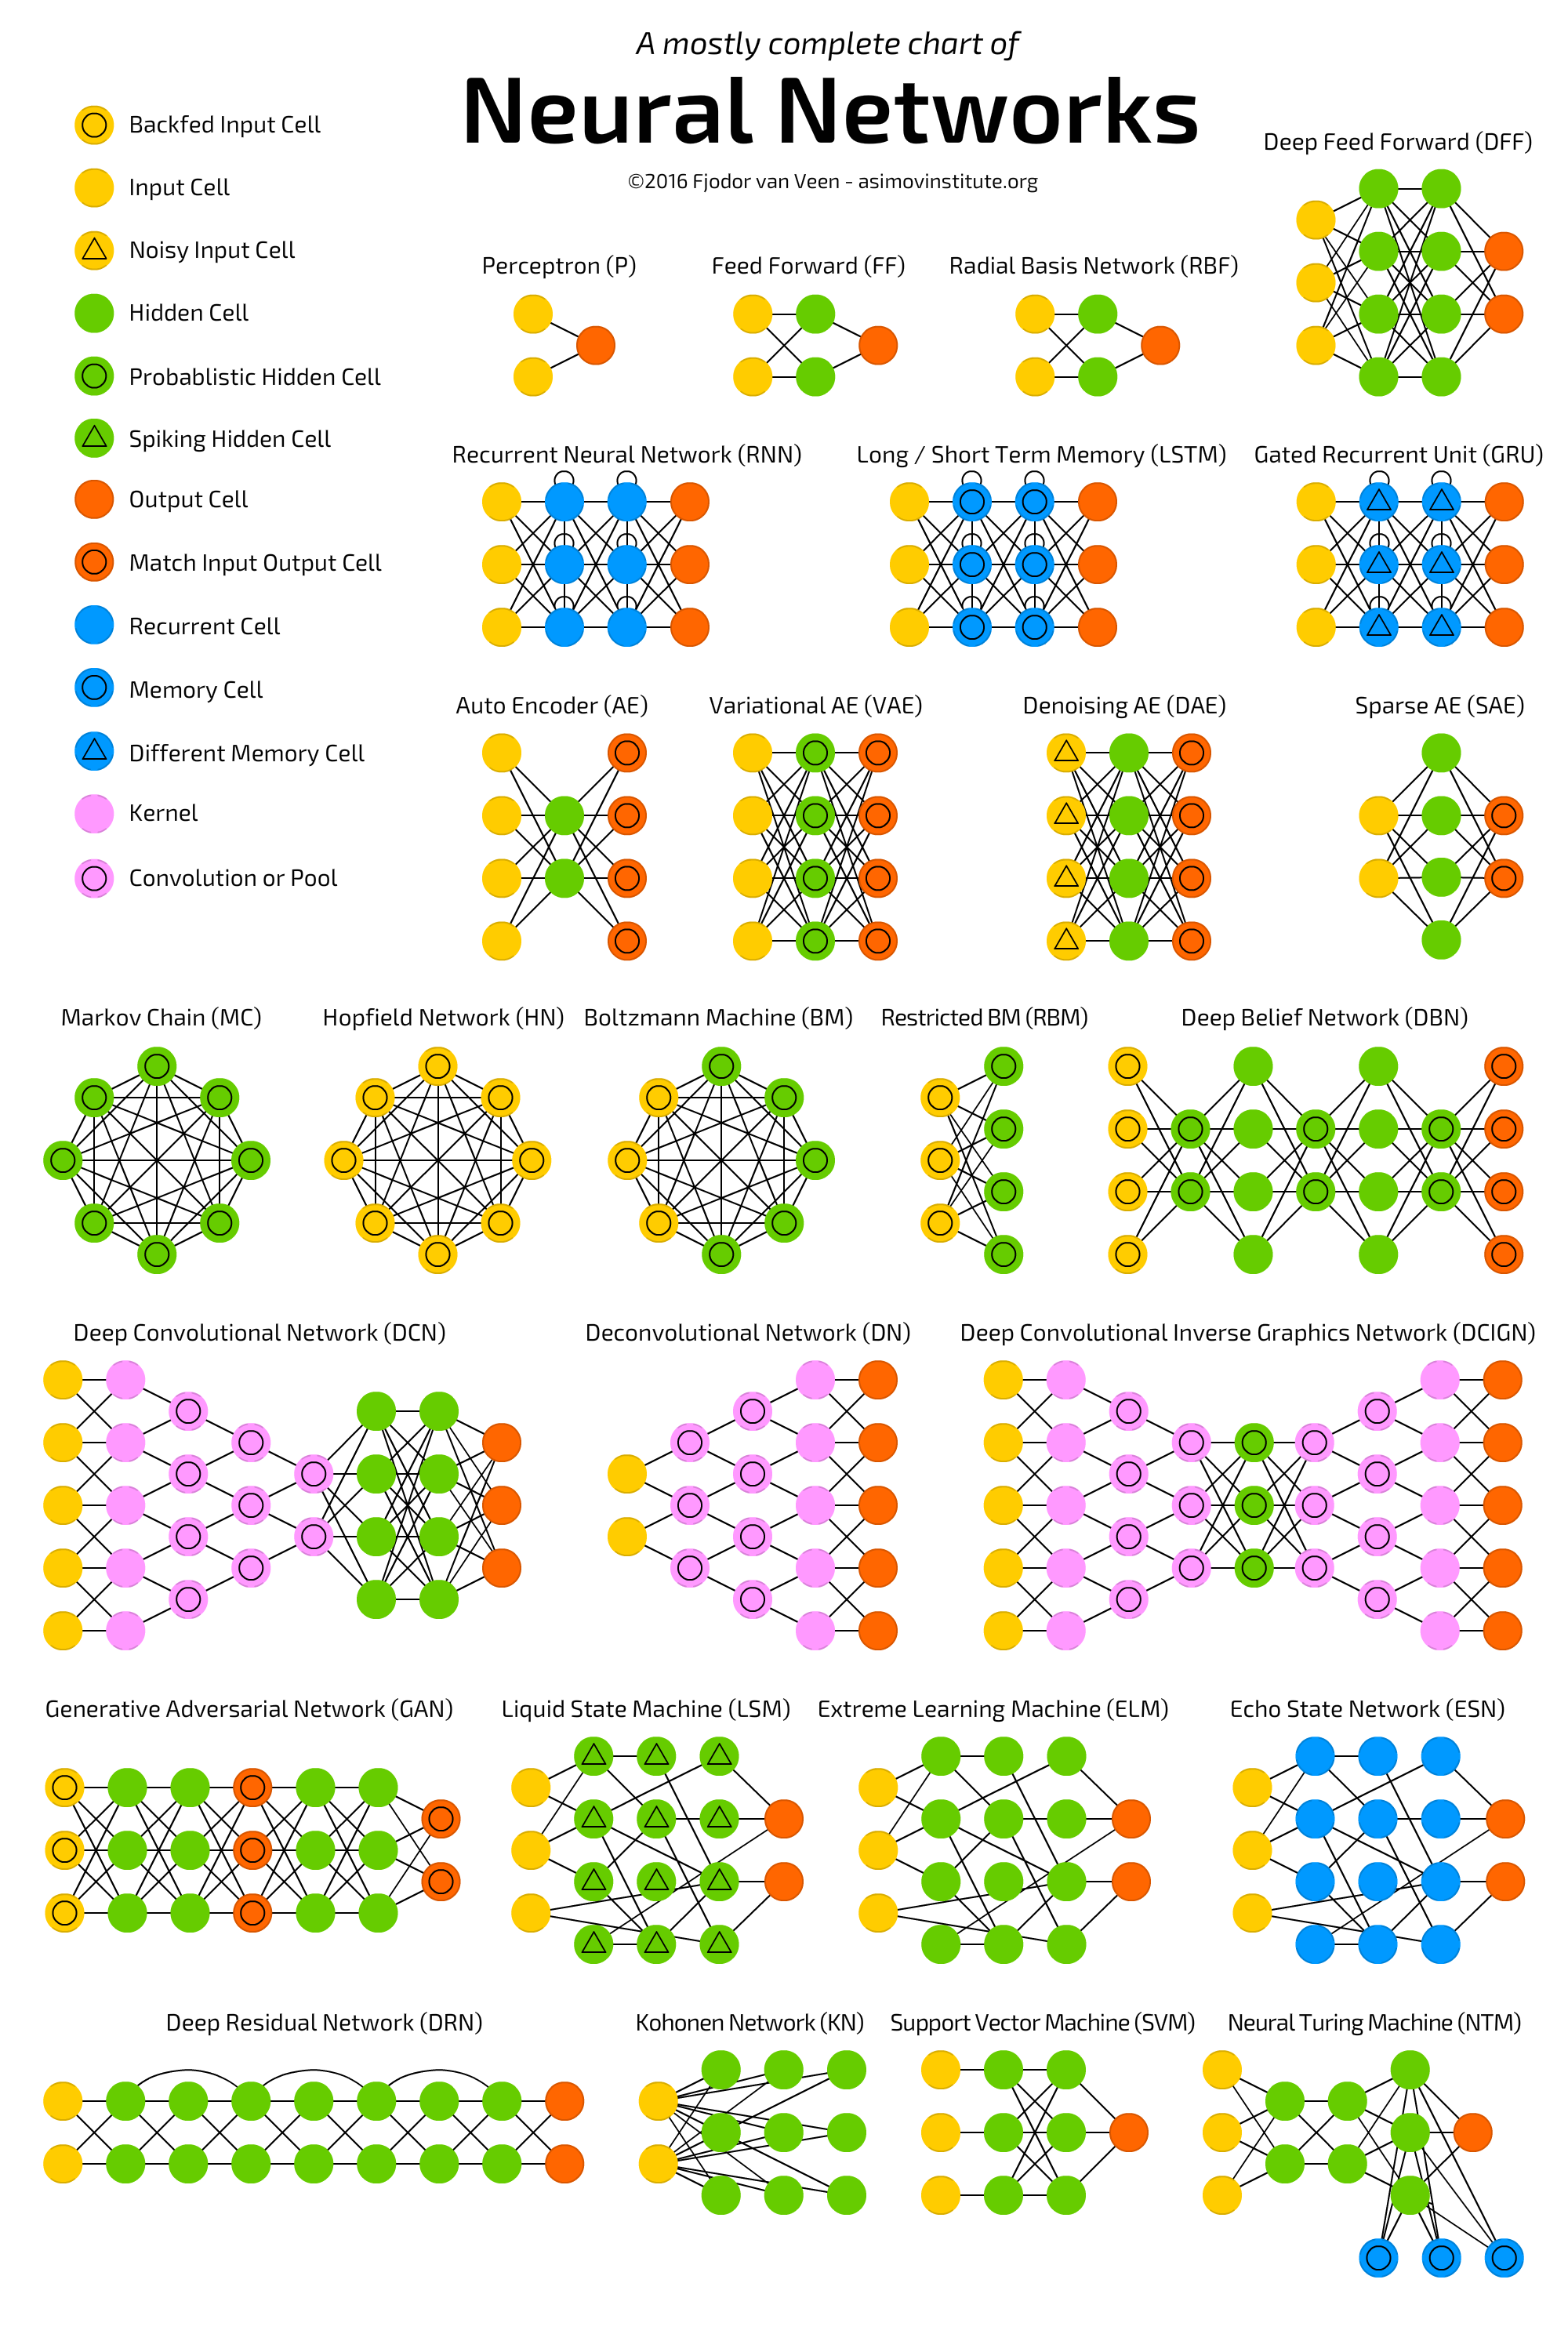
De arquitecturas de redes neuronales podríamos hablar hasta el infinito. Si te queda curiosidad, mira el esquema y lee el artículo Neural Network Zoo, donde están reunidos todos los tipos de redes neuronales. También hay una versión en ruso.
Este artículo también está en inglés
El aprendizaje automático es como el sexo en los últimos años de secundaria. Todo el mundo habla de él a escondidas, unos pocos saben de qué va y el único que lo practica es el profe. Hay dos tipos de artículos sobre aprendizaje automático: o son tratados en tres tomos llenos de fórmulas y teoremas, de los que nunca he conseguido leer ni la mitad, o son cuentos de hadas sobre la inteligencia artificial, las profesiones del futuro y los científicos de datos con poderes mágicos.
Así que decidí escribir yo el artículo que echaba en falta. Una introducción a fondo para quienes por fin quieren entender el aprendizaje automático: en lenguaje sencillo, sin fórmulas ni teoremas, pero con ejemplos de problemas reales y de cómo se resuelven.
Vamos allá.
📔 Descargar en PDF, EPUB o MOBI
para leer sin conexión ❤️ Darle las gracias al autor