 Vastrik
La semana pasada volví a Francia. Cuando estás en Francia, tu principal objetivo es PONERTE LAS BOTAS. Porque para PONERTE LAS BOTAS no hay mejor sitio en el mundo que Francia.
Pero hay un problema: si en vez de meterte en una trampa para turistas vas a un restaurante auténtico de cualquier ciudad francesa, en el mejor de los casos (si el dueño tiene buena letra y se ha levantado de buen humor) la carta será más o menos así:

Por si nunca has estado en Francia, aclaro: aunque pidas «la carta», no te dan el típico librito bonito con fotos. Literalmente te plantan en la mesa una pizarra negra como esta con los platos del día escritos con tiza blanca (en francés). ¡Sil vu plé, mesié! ¿Du van pur le dam?
Sí, solemos tener suerte y casi siempre vamos con amigos que hablan francés. Pero a veces tienes ganas de PONERTE LAS BOTAS y no tienes a tus amigos a mano.
Así fue como, hace ya tiempo, se me ocurrió una idea para una startup.
ChatGPT (y sus alternativas) tienen algo curioso: se les da sorprendentemente bien reconocer texto escrito a mano. Incluso si son los garabatos de un médico o un informe policial en serbio (no me preguntes cómo lo sé). Le dan mil vueltas a cualquier aplicación de OCR de las de antes.
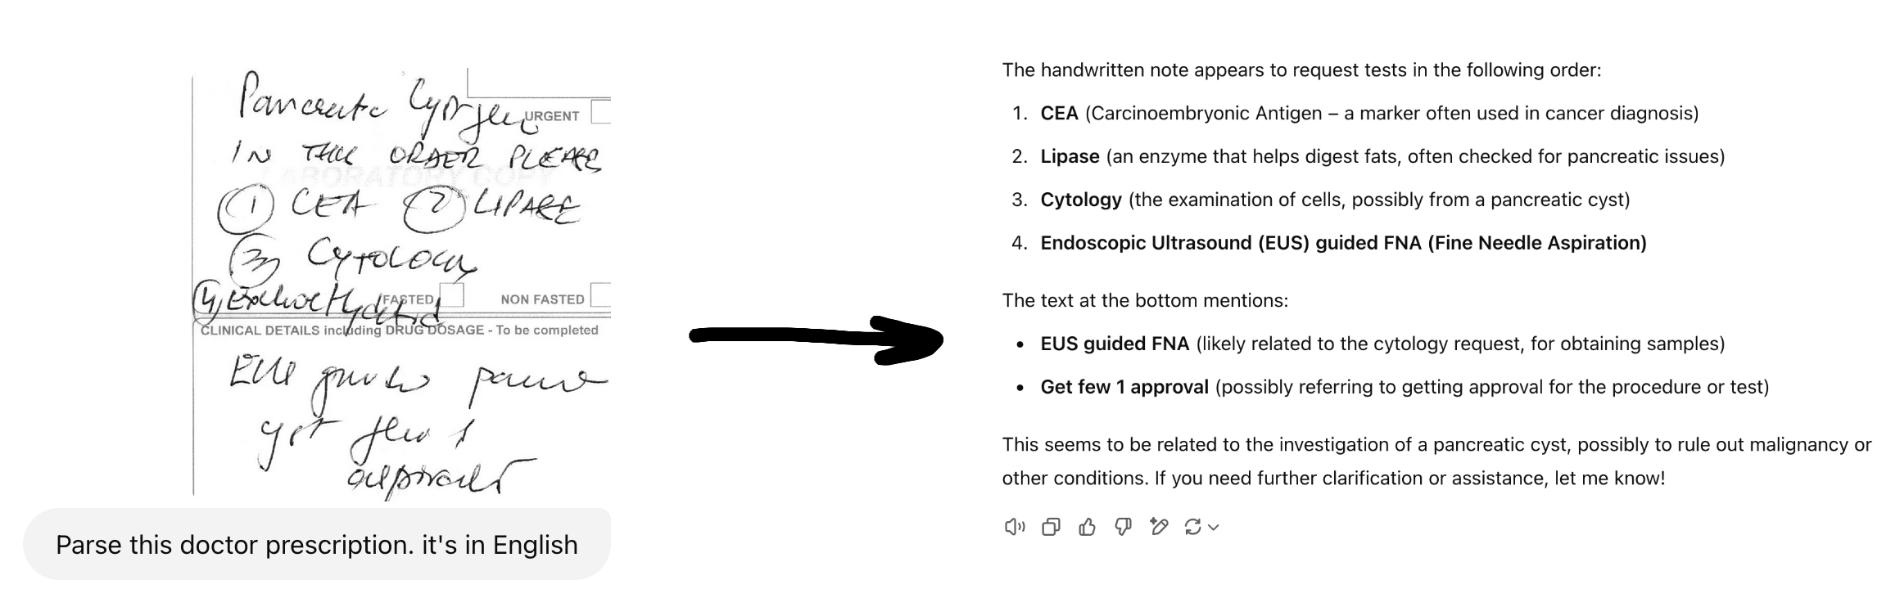
Pues bien, en mi último viaje por Francia tuve una de esas ideas tan estúpidas como geniales:
Tengo que hacer una app con la que le sacas una foto a la carta de un restaurante y te devuelve la lista de platos, con descripciones en un idioma que entiendas y fotos para que veas qué pinta tienen de verdad. Y puntuaciones... Y...
¿Estoy seguro de que ya hay al menos un par de cientos de miles de apps así en la App Store? Claro que sí. ¿Me importa? No))00)
Y aquí entramos de lleno en el tema de este post: ¡el vibe coding!
No sé quién se inventó el término «vibe coding», pero se hizo popular a raíz de un tuit de Andrej Karpathy:
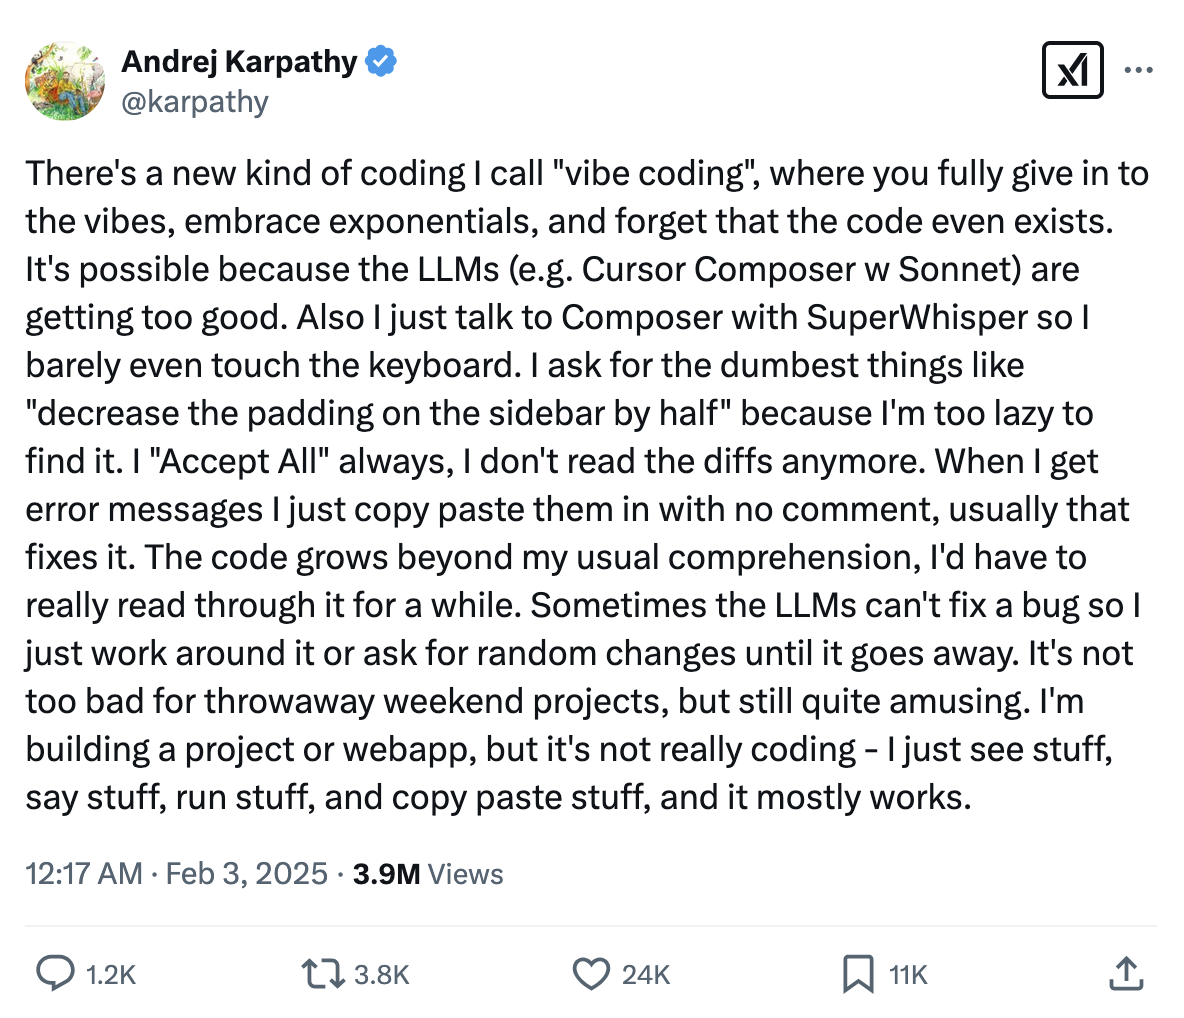
La idea del vibe coding es que, desde que hay herramientas basadas en grandes modelos de lenguaje (LLM) que generan código y hasta proyectos enteros, como Claude Sonnet o Cursor (del que hablé en mi resumen del año), los que disfrutamos programando algo por las noches tenemos una nueva forma de hacerlo: charlando con un LLM por chat o incluso por voz.
Abres Cursor o cualquier otro IDE con IA, creas un proyecto en blanco y empiezas a contarle directamente por chat qué quieres conseguir.
Yo, por ejemplo, empecé con este prompt:
Créame una app en React desde cero. La idea es tener una app que pueda sacar una foto de la carta de un restaurante, traducirla y mostrar una lista de platos con fotos de cada plato sacadas de internet. Tiene que ser una PWA con un botón para abrir la cámara o elegir una foto de la galería. Luego envía la foto a ChatGPT para que analice el texto y cree una lista de platos (con categorías y precios), y usa alguna API de imágenes para buscar fotos en internet por el nombre del plato. El usuario puede ver la lista y pulsar en un plato para abrir más fotos y una descripción del plato
Le envío mi prompt a Le Chat Sonnet...
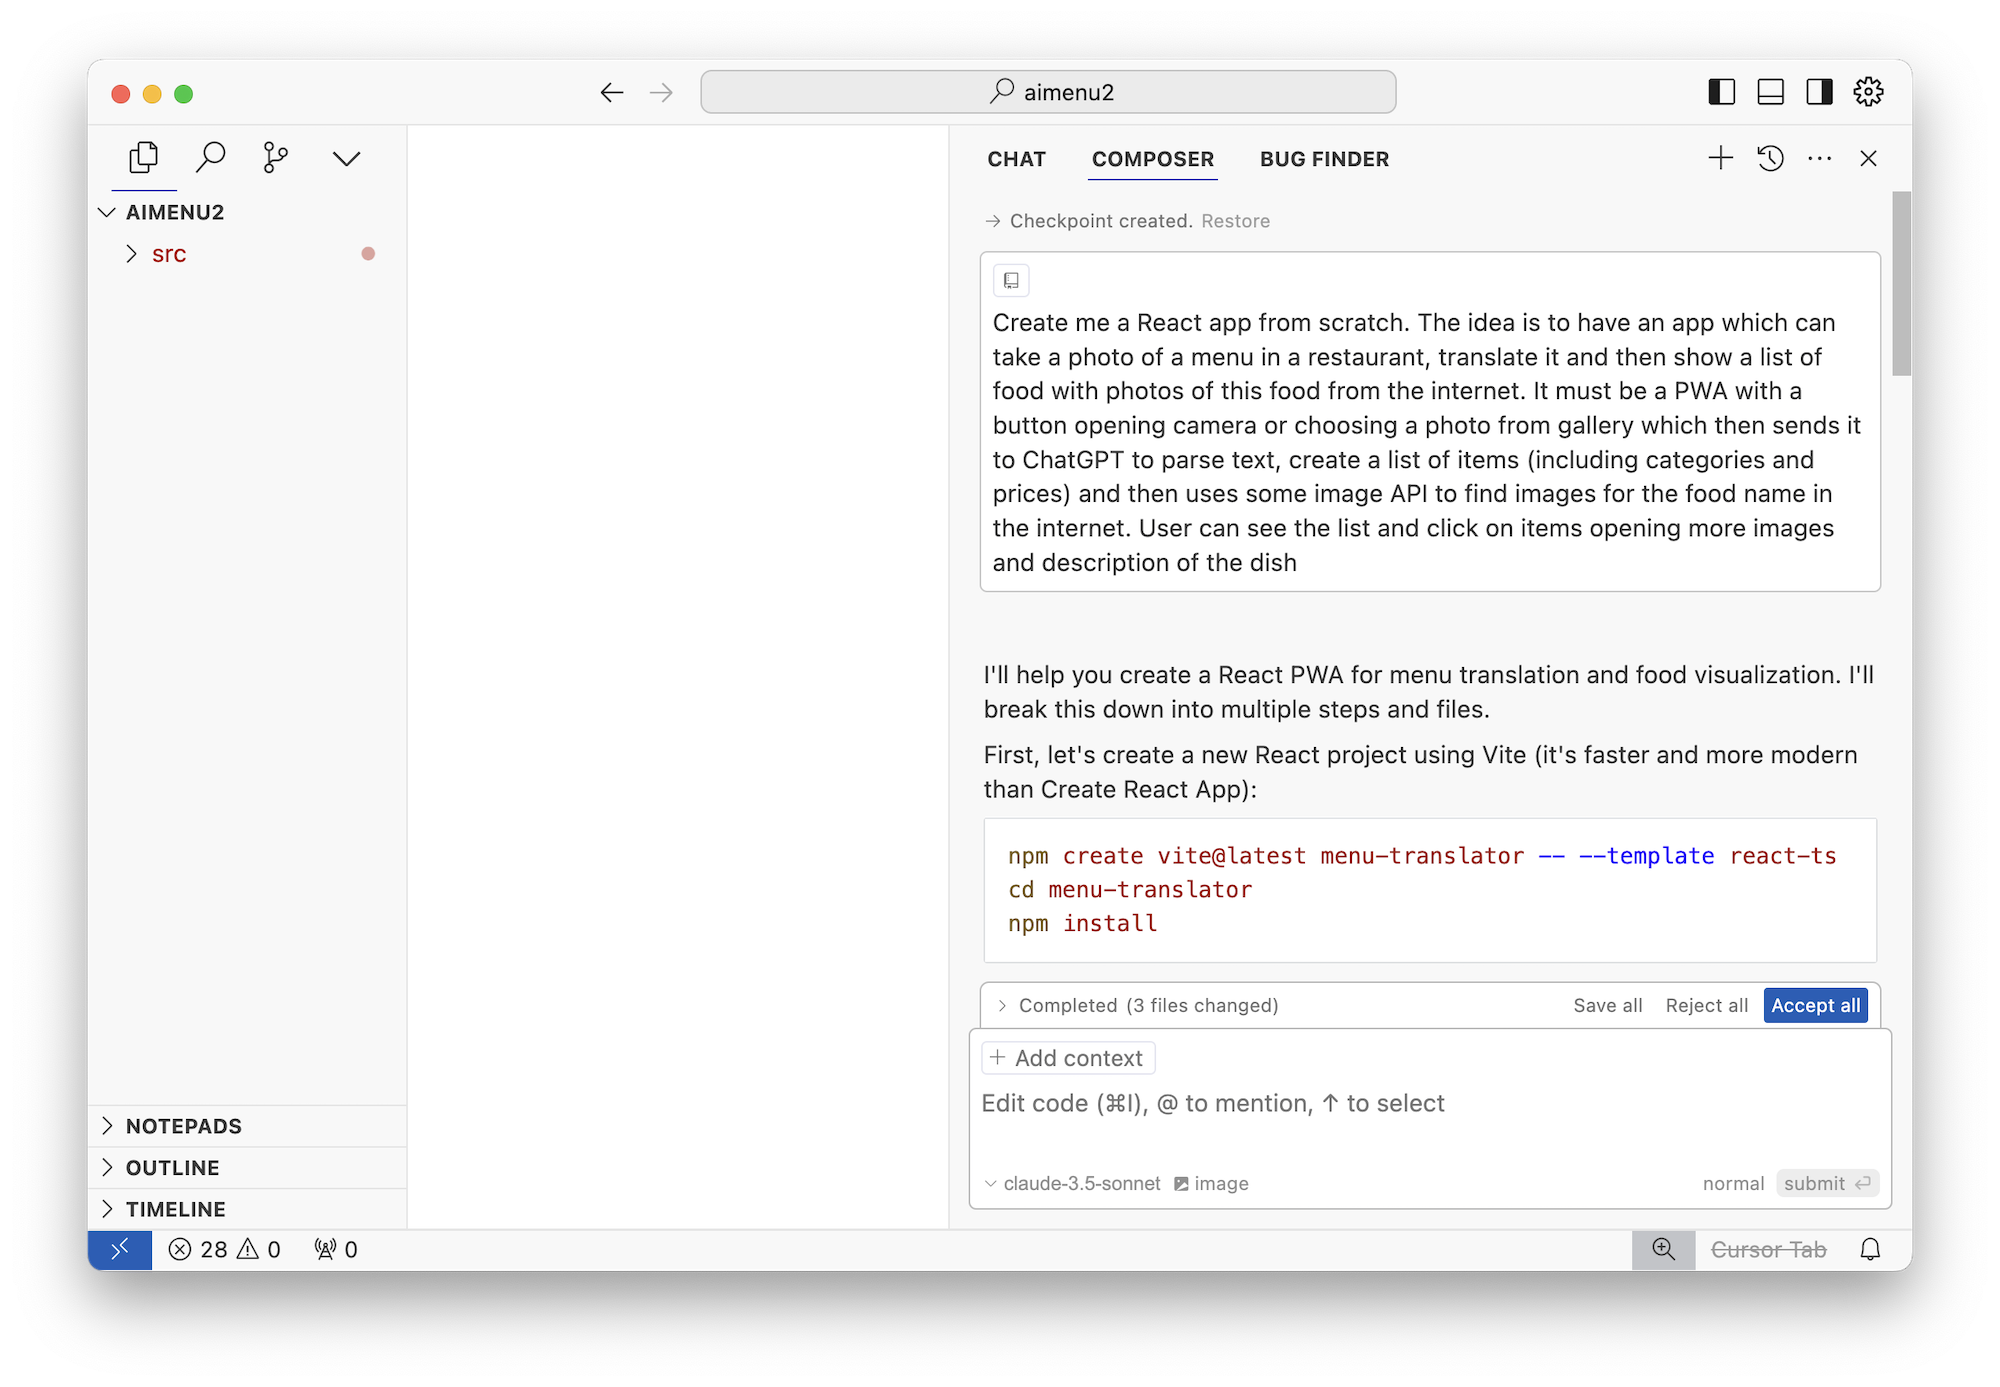
Y la magia de la IA generativa me genera, por arte de magia...
una mierda.
La estructura del proyecto es horrible. Está todo metido en un solo componente, llama a la API de OpenAI por REST en vez de usar la biblioteca estándar, no hay pantallas separadas ni indicadores de progreso y van y vienen cientos de peticiones sin caché. En fin, como si lo hubiera escrito un júnior. Nadie en su sano juicio podría usar esto.
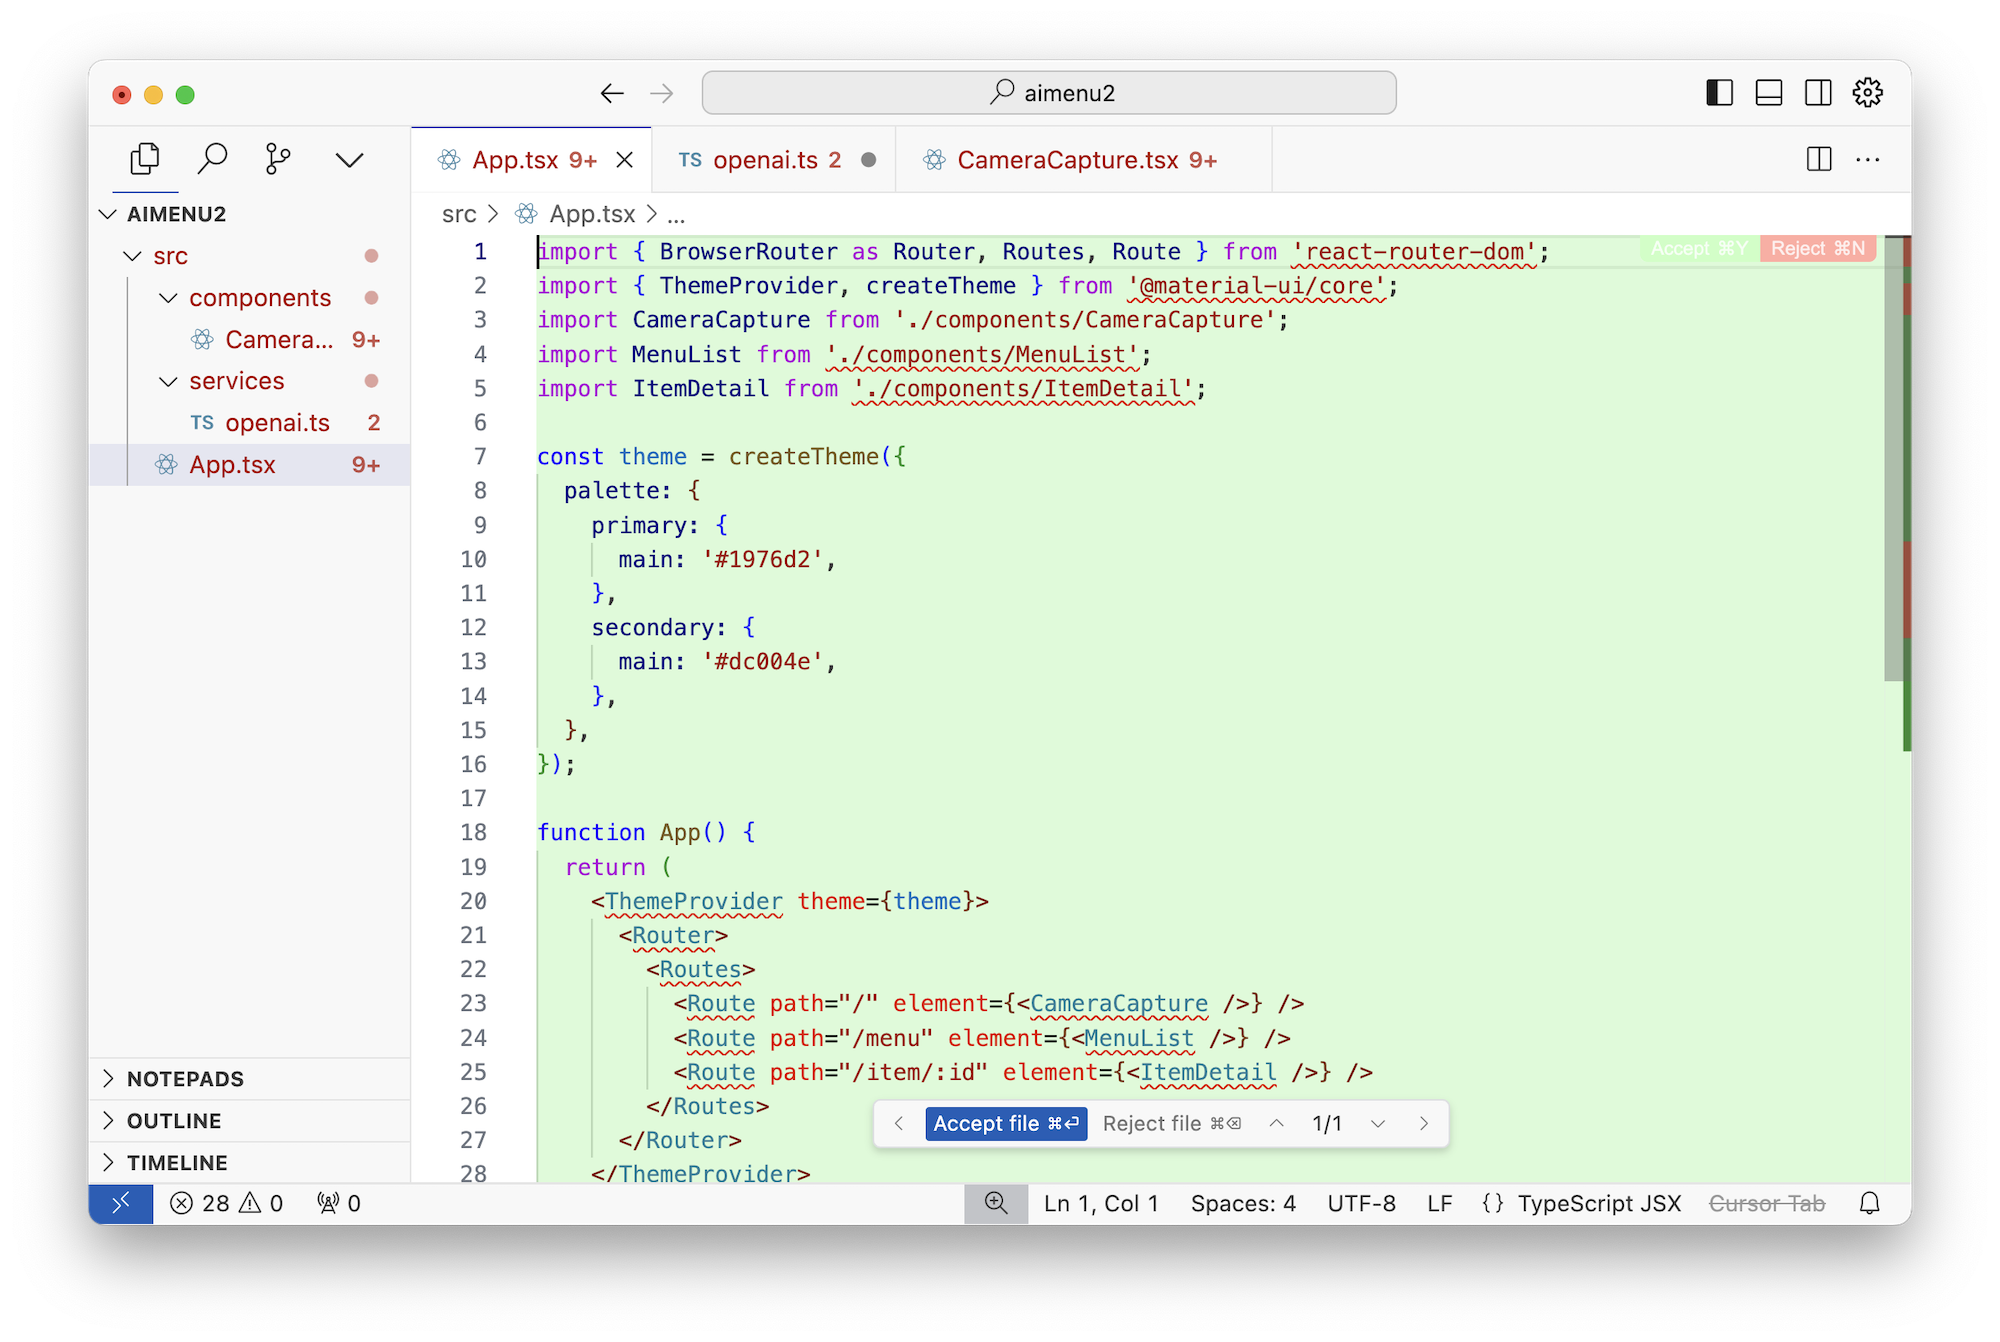
Eso sí, me gusta que haya elegido React + Vite + MUI. Yo soy de backend, pero los de frontend de mi barrio me contaron que, para hacer prototipos, esa es la elección de todo un caballero.
¡Y además ARRANCA!
Si haces npm create/install como te pide, con npm run dev de verdad arranca un proyecto que (casi) funciona. Solo tienes que cambiar a mano un par de claves de API en la configuración y poner versiones actuales de los modelos de OpenAI.
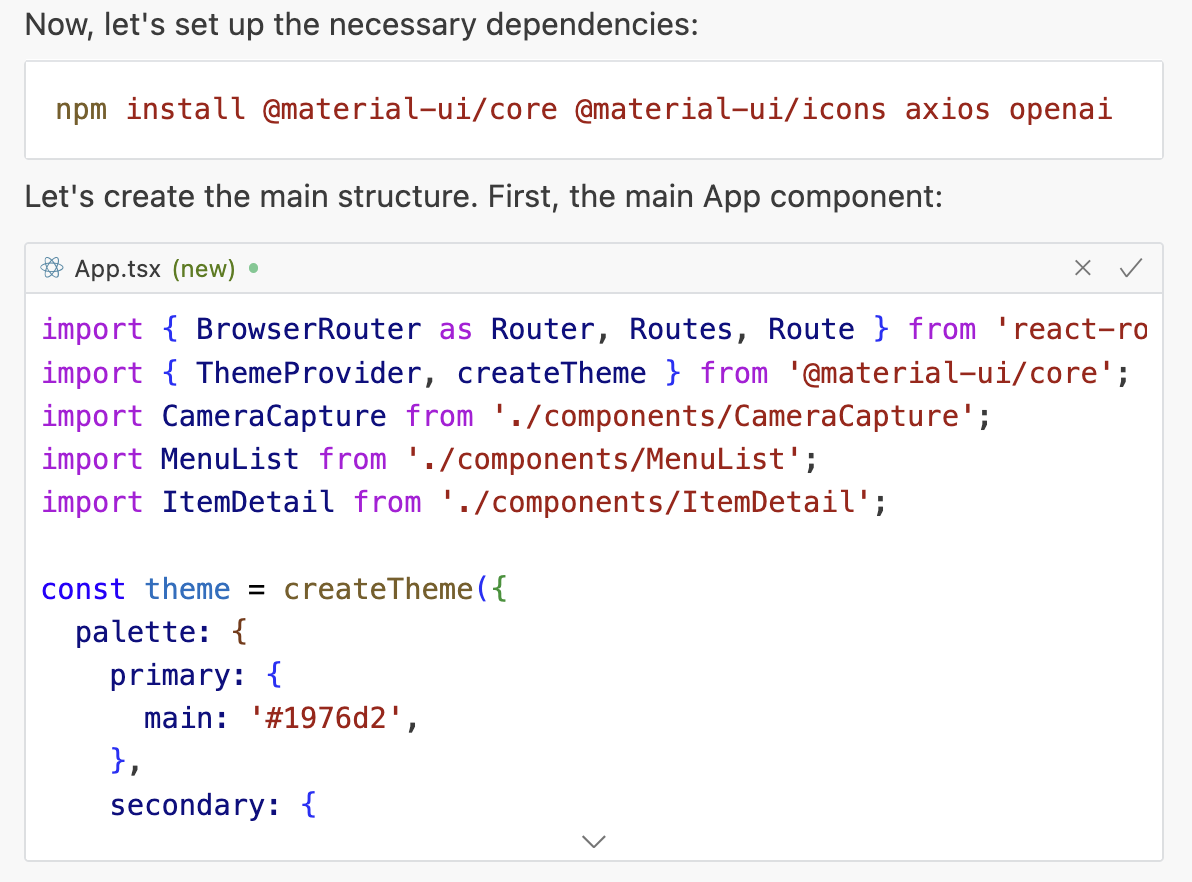
En general, funciona.
Pero ahora entiendes que a un LLM no hay que hablarle de sénior a sénior, sino de sénior a júnior. Empiezas a concretar un poco más lo que le pides.
Cada pantalla, cada botón, la distribución de los elementos, el tamaño de los botones y los iconos de cada pantalla, la posición del menú, los botones para volver atrás y hasta la elección del framework: tienes que mencionarlo y describirlo todo.
Es como escribir un ticket en Jira para un desarrollador MUY tonto. Solo que el resultado sale al instante y no después de un par de meses de reuniones para elegir un framework de CSS.
No puedes pedirle algo complicado a un LLM de entrada. Si lo haces, se cansa y se rompe a medio camino (igualito que un programador de verdad). Tienes que pensar y describir ese famoso producto mínimo viable, el MVP: quieres que la primera iteración sea lo más sencilla y básica posible, pero que arranque, funcione y resuelva el problema principal.
En fin, ahora es como si fueras el product manager del LLM. ¡Bienvenido! Espero que los de producto de verdad aún no se hayan dado cuenta de que ya no necesitan programadores...
Bueno.
Total, que borro el proyecto, creo otro y le escribo el siguiente prompt a Claude 3.5 Sonnet:
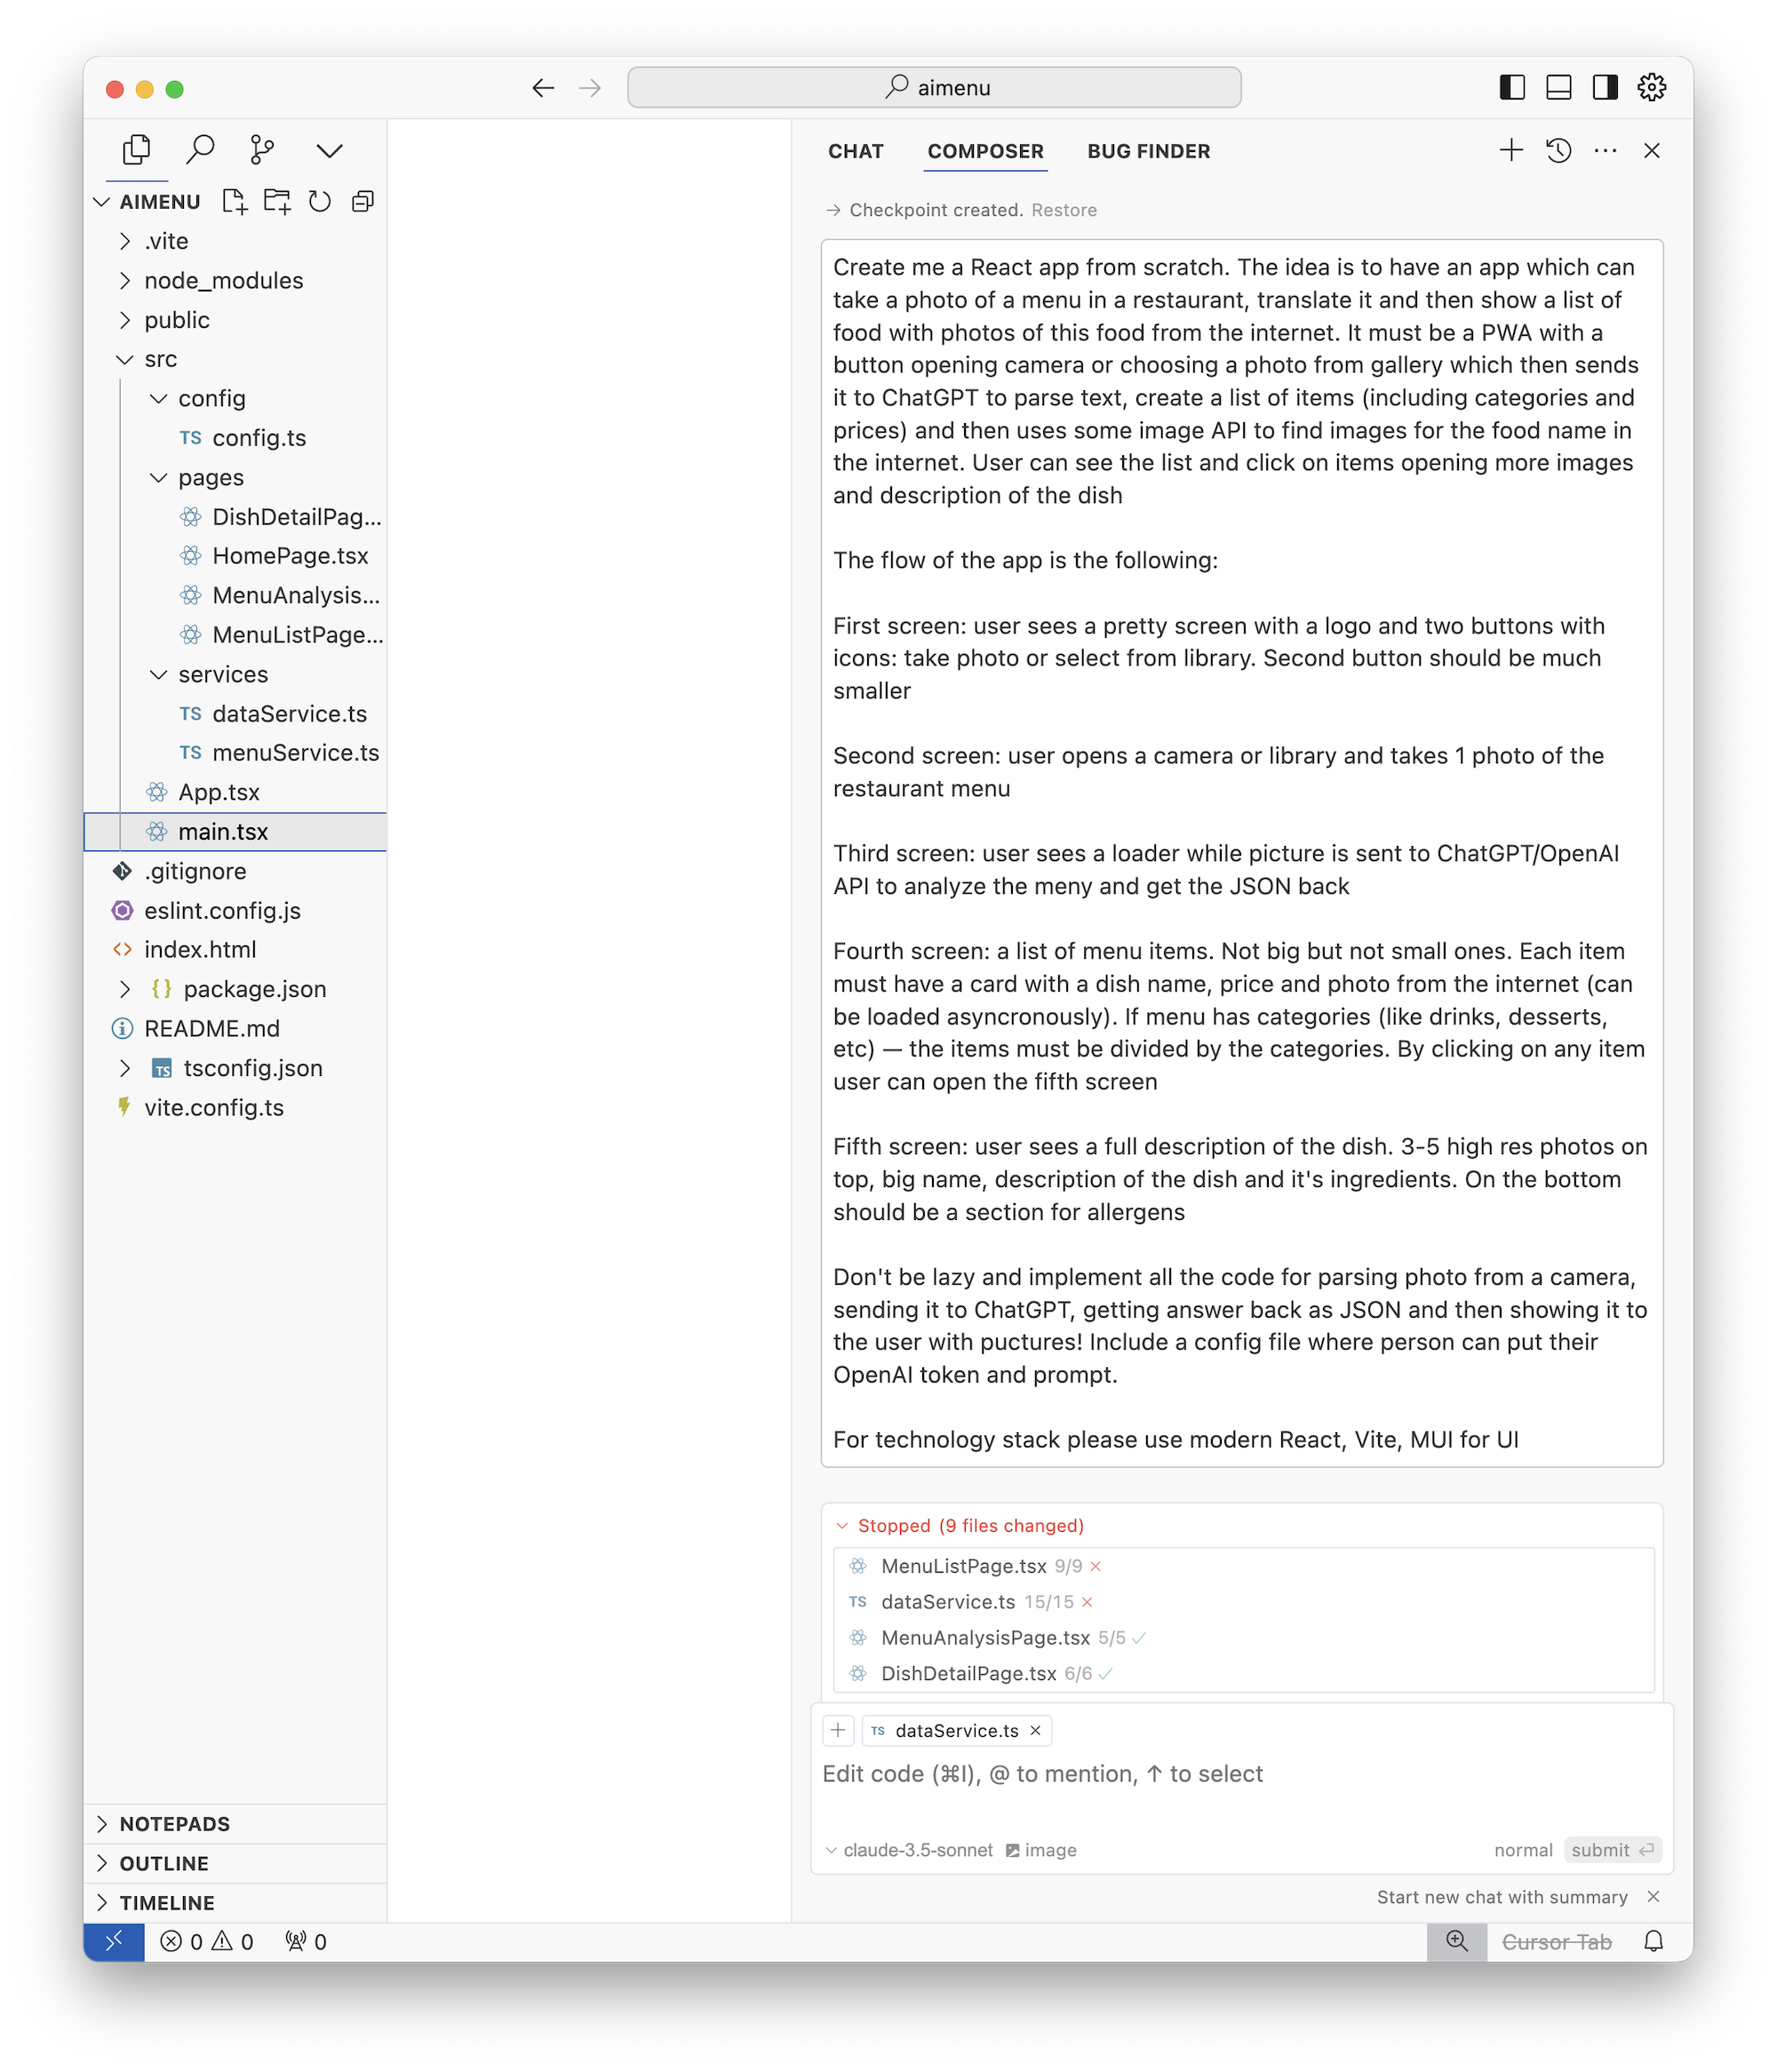
¡Que empiece el vibe coding!

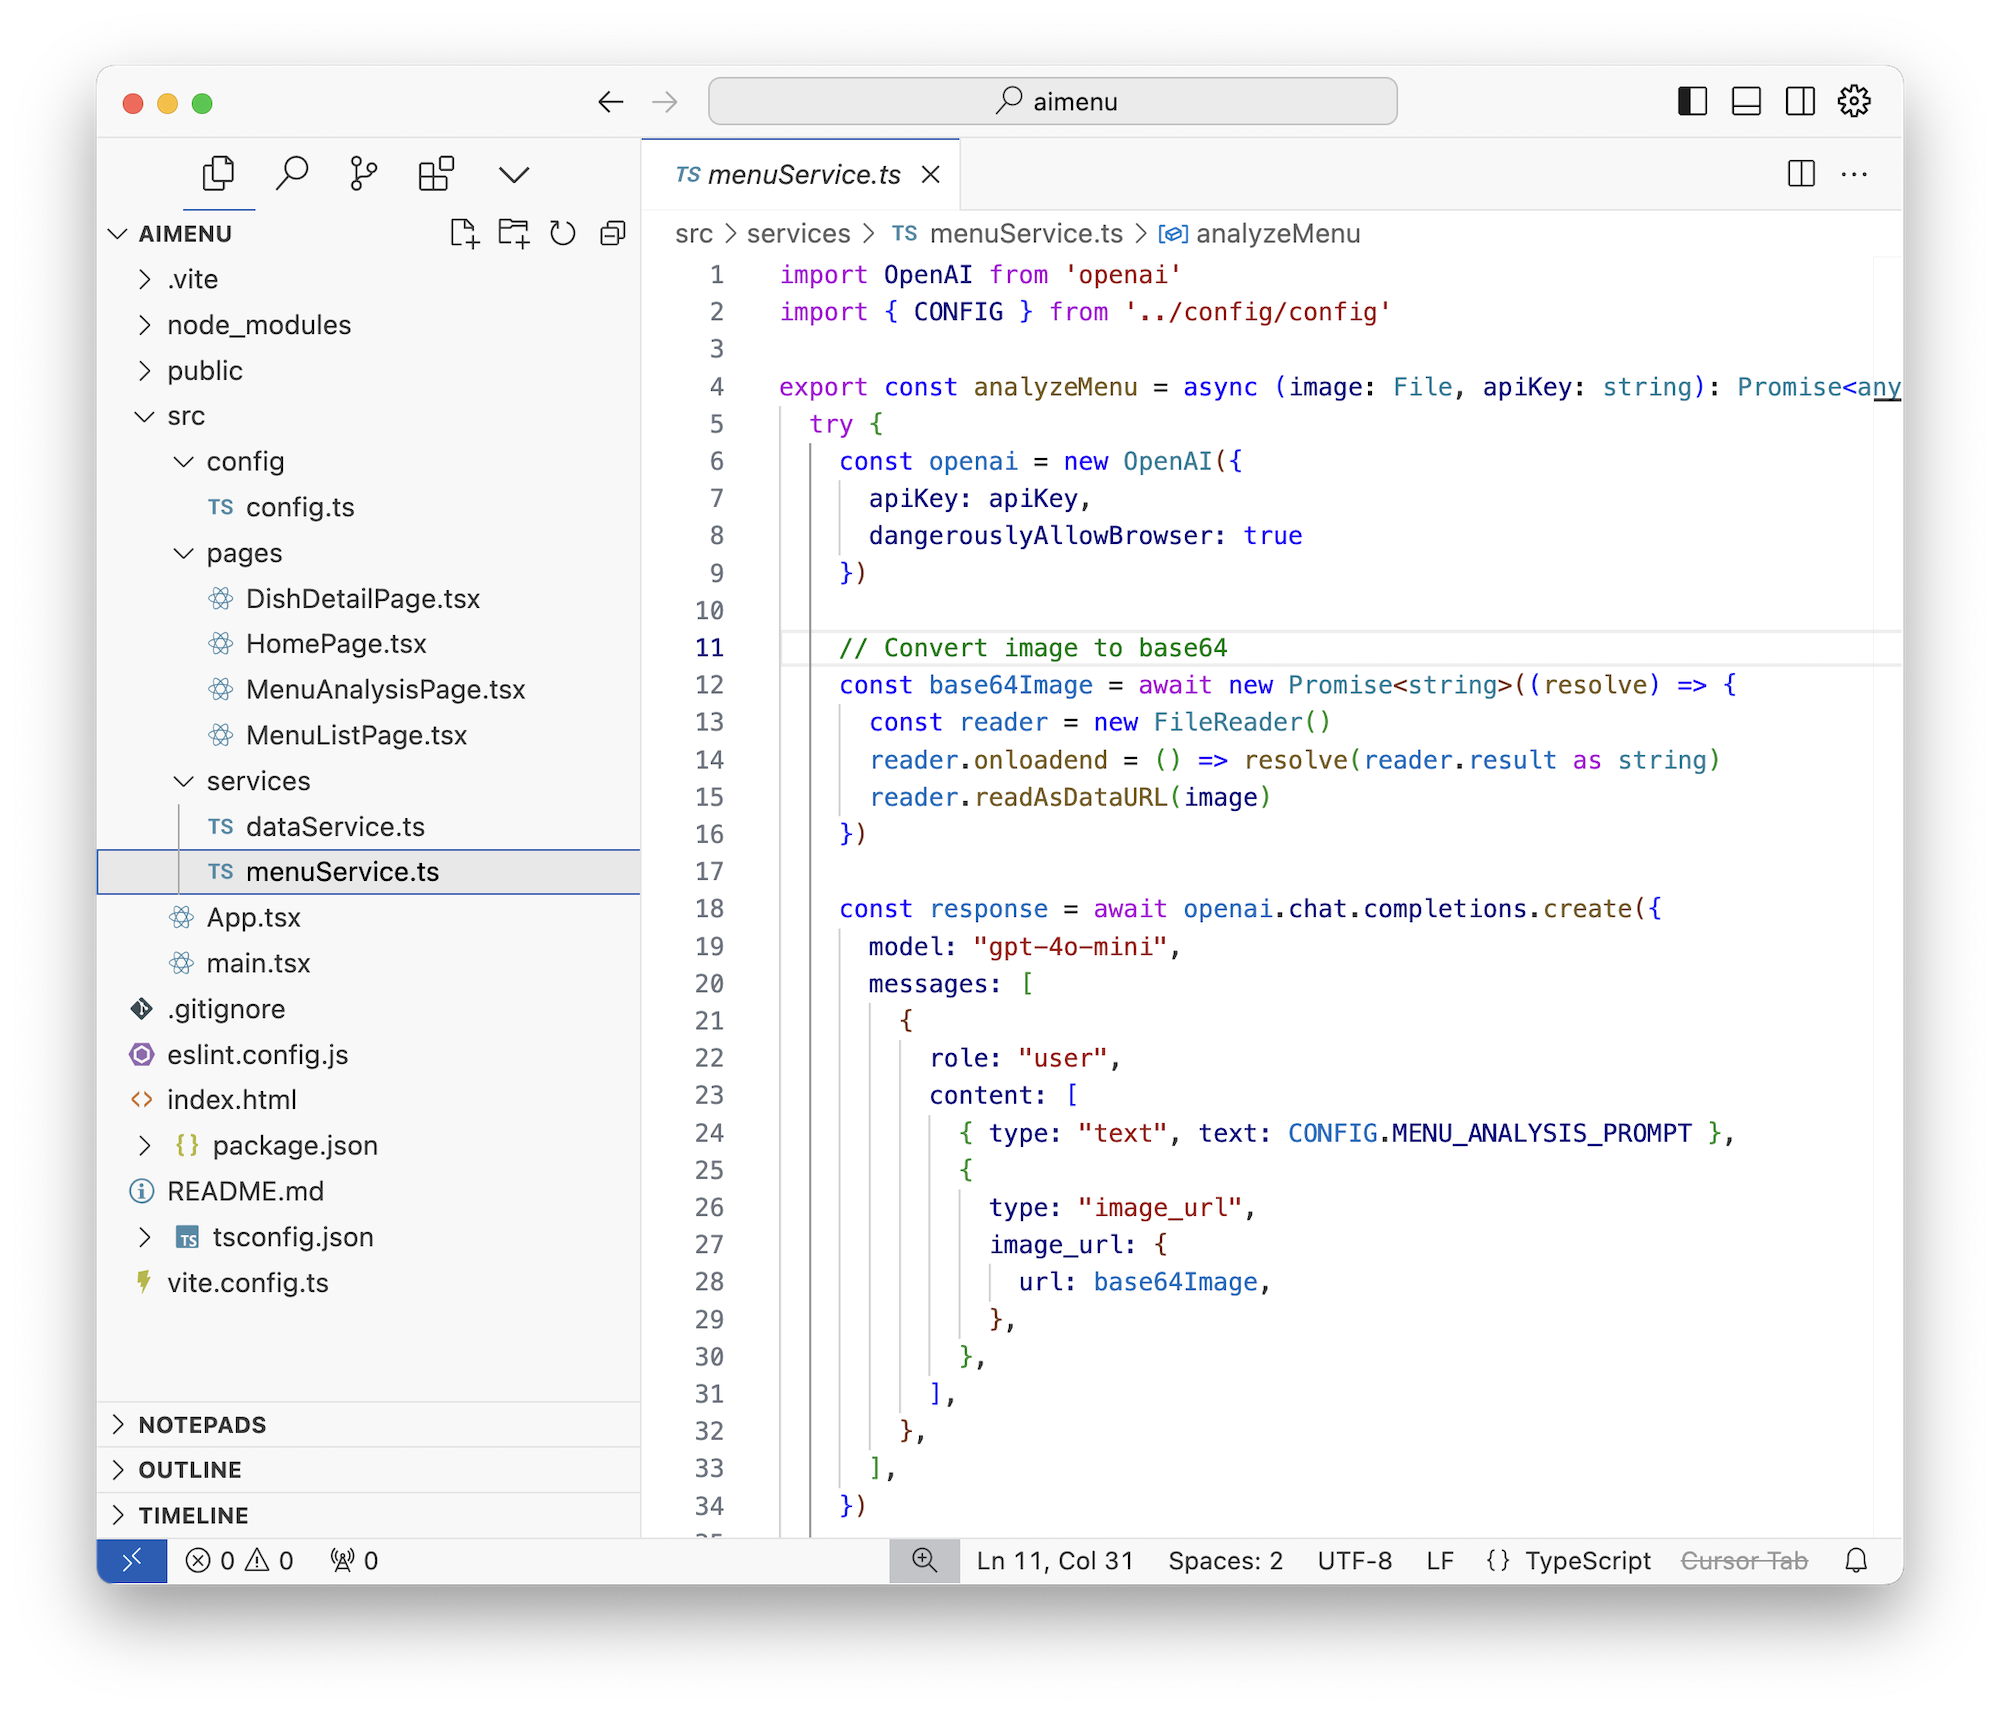
Bien, esta vez me ha generado una estructura de aplicación que a primera vista parece decente. Cuatro pantallas, indicadores de carga, rutas por URL; hasta ha creado un modelo aparte que hace de servicio y se encarga de la lógica de negocio de la carta. Parece que el curso «Conviértete en desarrollador web en 13 días» le sirvió de algo. ¡Un punto de vibra!
📝 Nota: mientras escribía este post, volví a probar mis prompts para hacer las capturas de pantalla. Cada vez me daban un resultado distinto, a veces hasta salía un proyecto que no funcionaba. Así que, si no consigues reproducirlo, cambia lo que le pides y sigue peleando hasta que lo consigas.
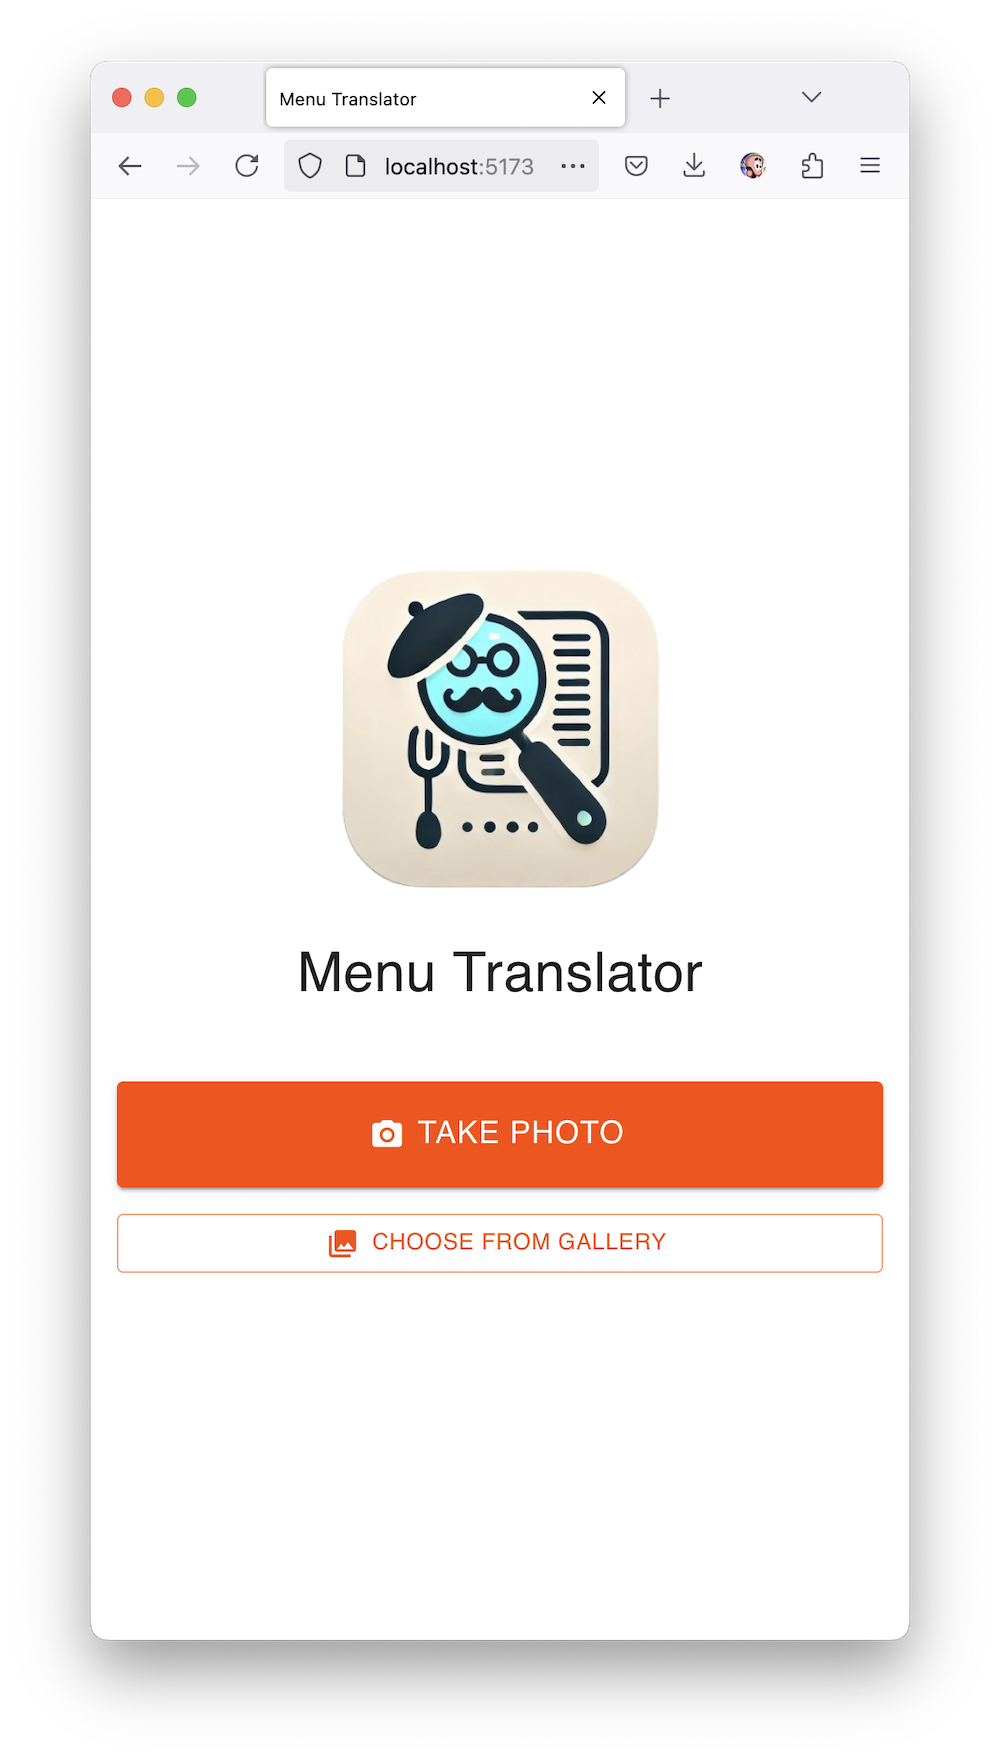
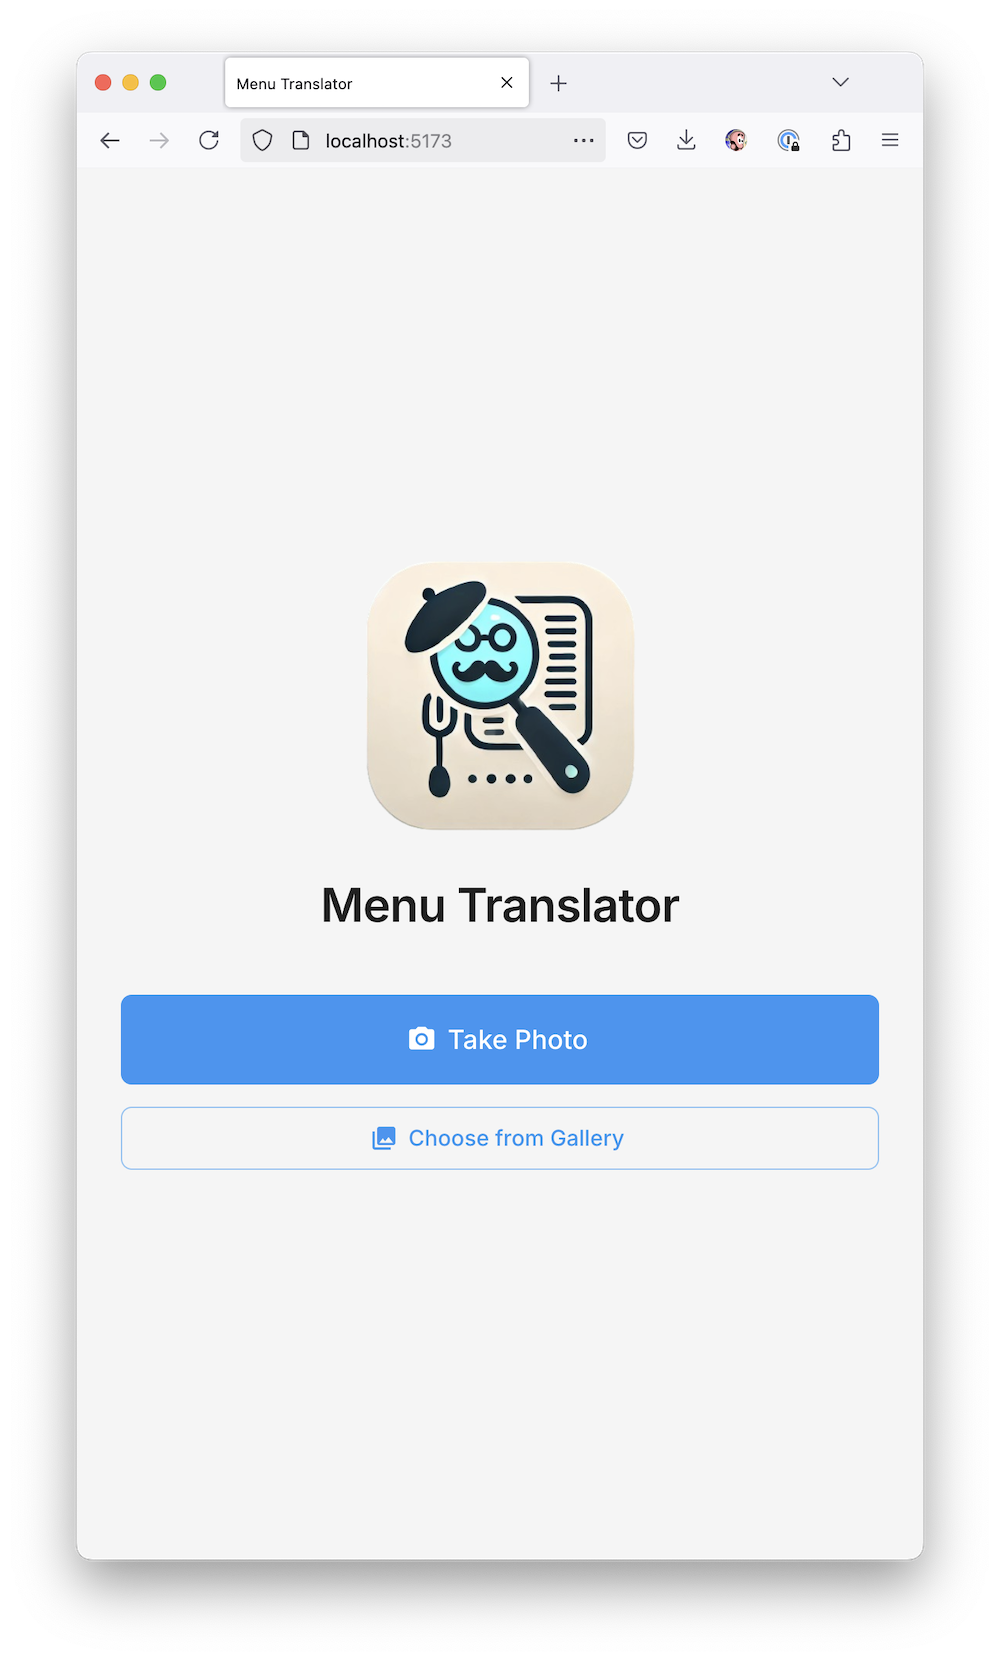
En la primera pantalla puedes elegir una foto de la carta en la galería o abrir la cámara; en la segunda se analiza la foto con un bonito indicador de carga de Material UI, y en la tercera aparece la carta con las fotos de los platos.
El icono de la app también lo generé, con DALL-E. Le pedí que le diera un toque francés. Salió una mierda barata, pero va con la vibra. El bigote sí le quedó bonito.
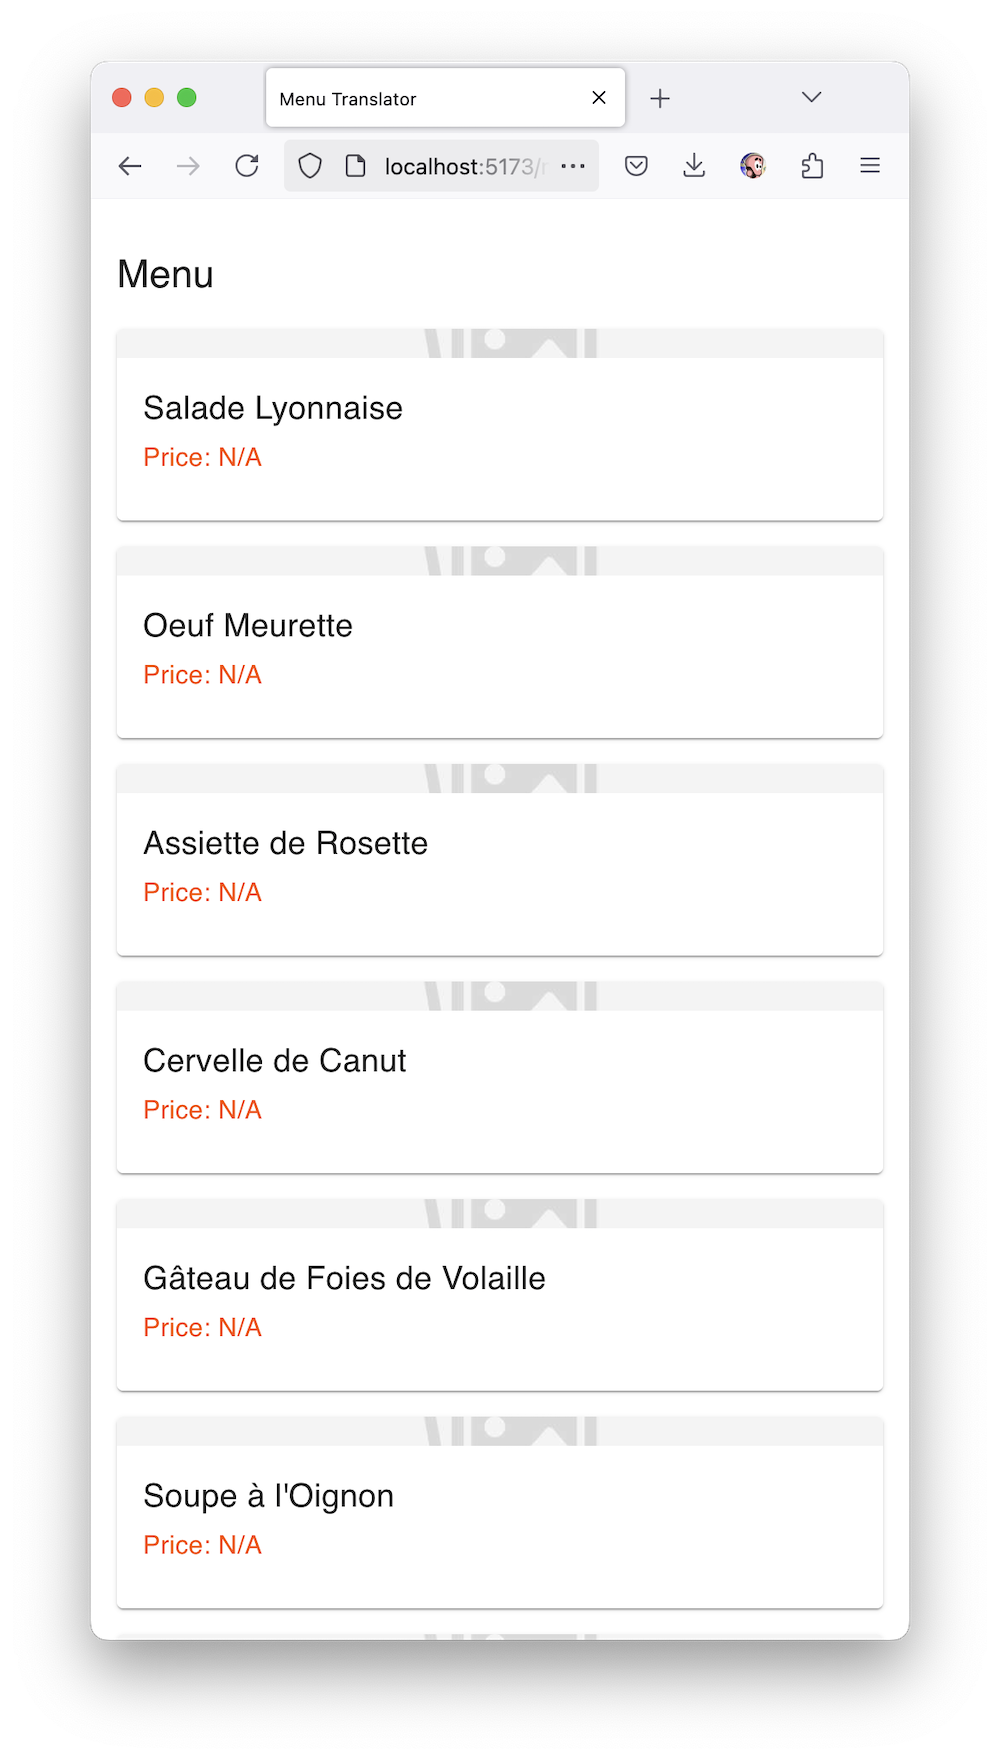
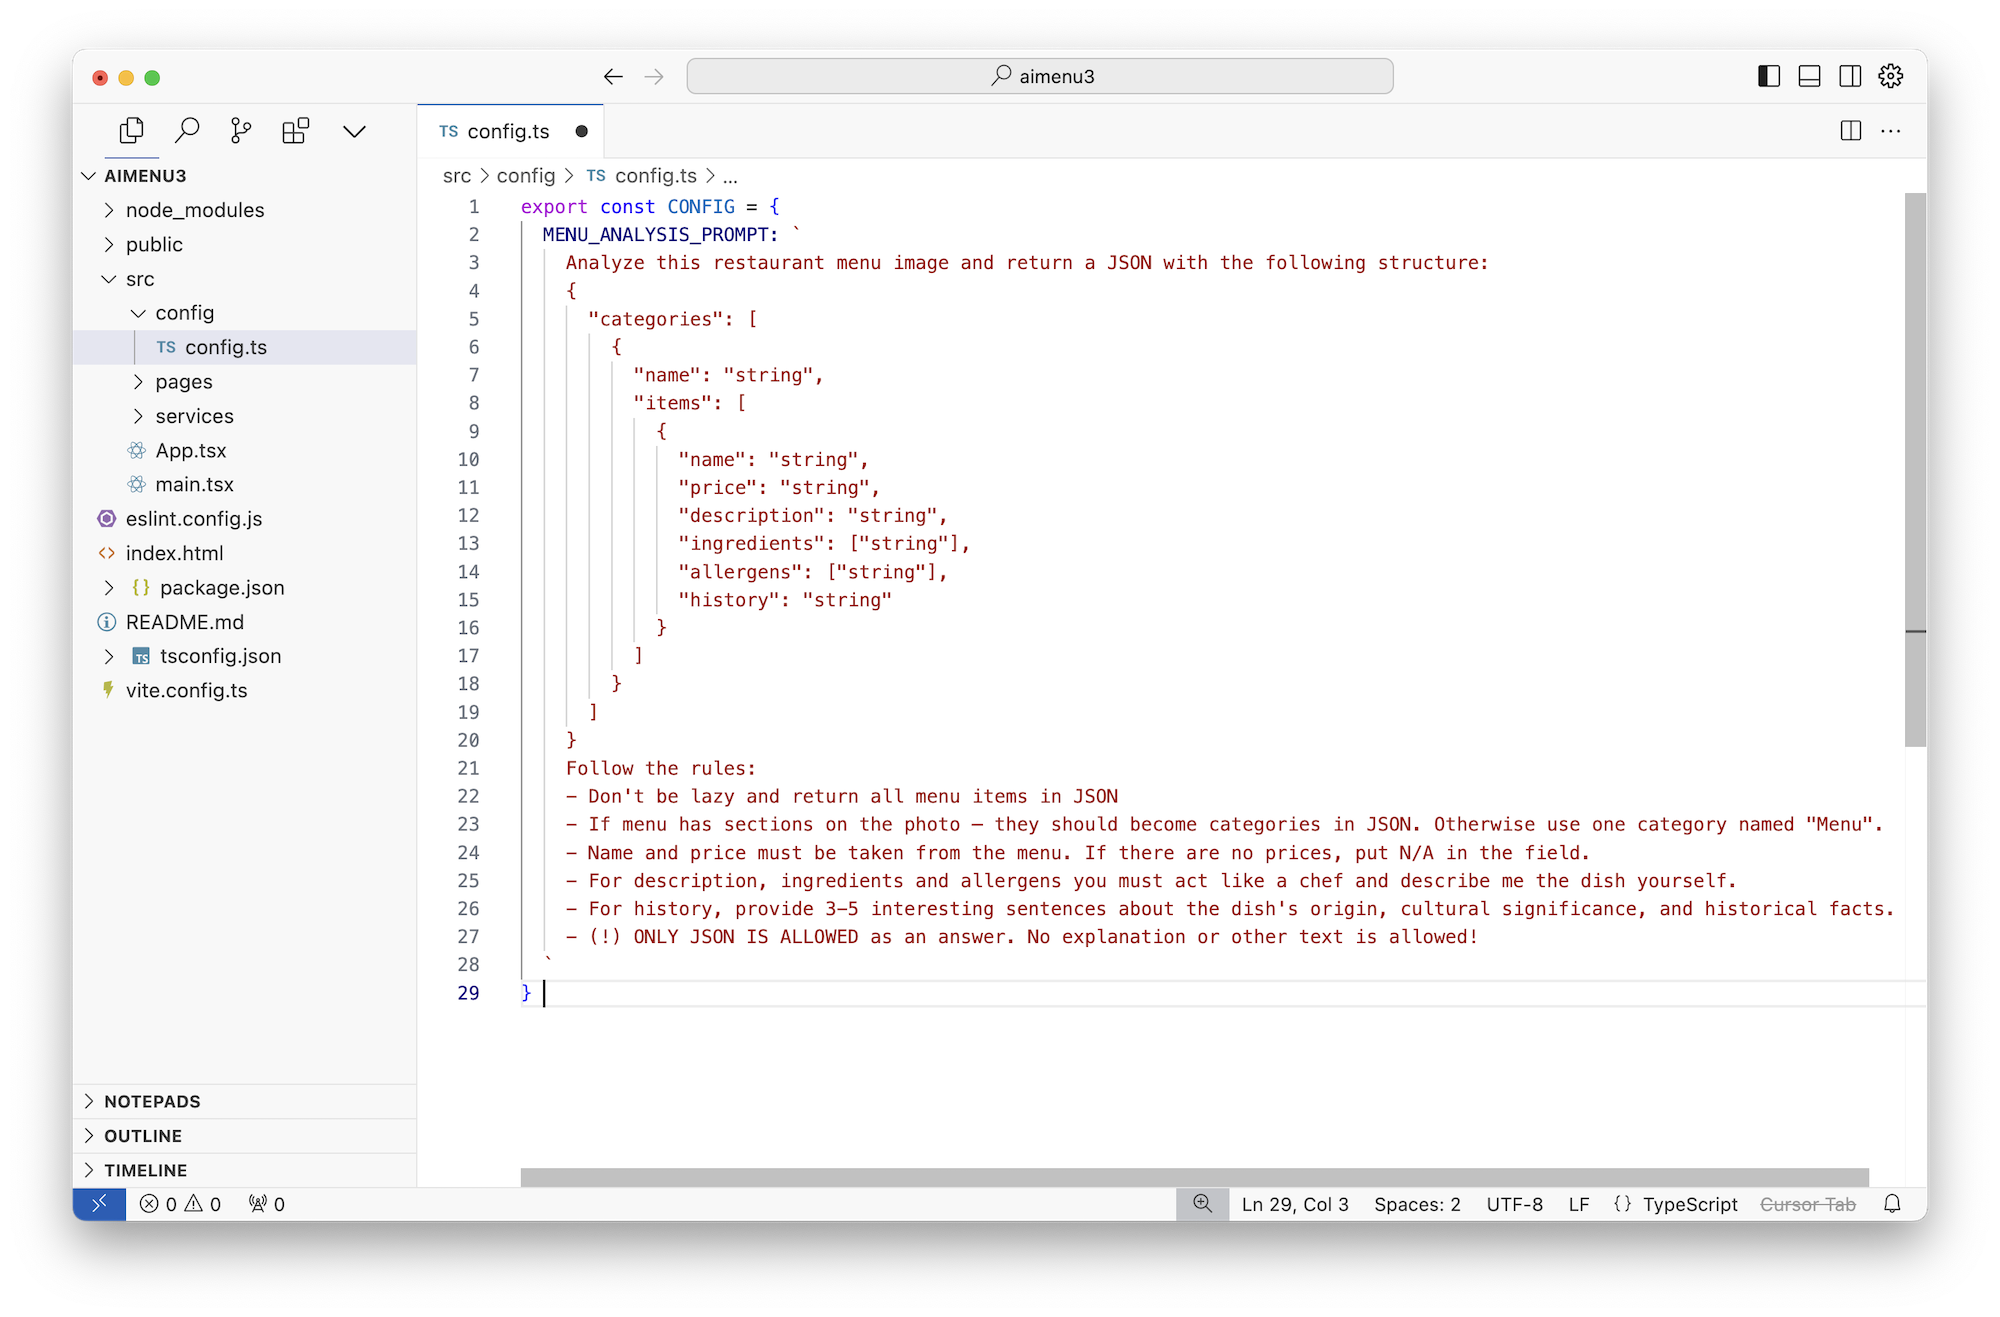
Lo primero que salta a la vista es lo mal escrito que está el prompt. La app ni siquiera puede interpretar el resultado, porque ChatGPT, en vez de devolver JSON, responde con texto en Markdown. Pero era de esperar: a los LLM todavía se les da mal escribir prompts para otros LLM.
Así que vamos a corregir el prompt a mano, echando mano de lo poco que hemos aprendido de ingeniería de prompts en otros artículos. Más o menos así:
Lo segundo que no me gustó: se le ocurrió usar Unsplash para buscar imágenes. Unsplash está bien, pero no nos sirve de mucho: lo que hay son sobre todo fotos de stock y nosotros queremos fotos reales, como las que salen en Google. Pero he oído que Google cobra una barbaridad por su API. ¿Y si probamos con Bing?
Se lo escribimos tal cual:
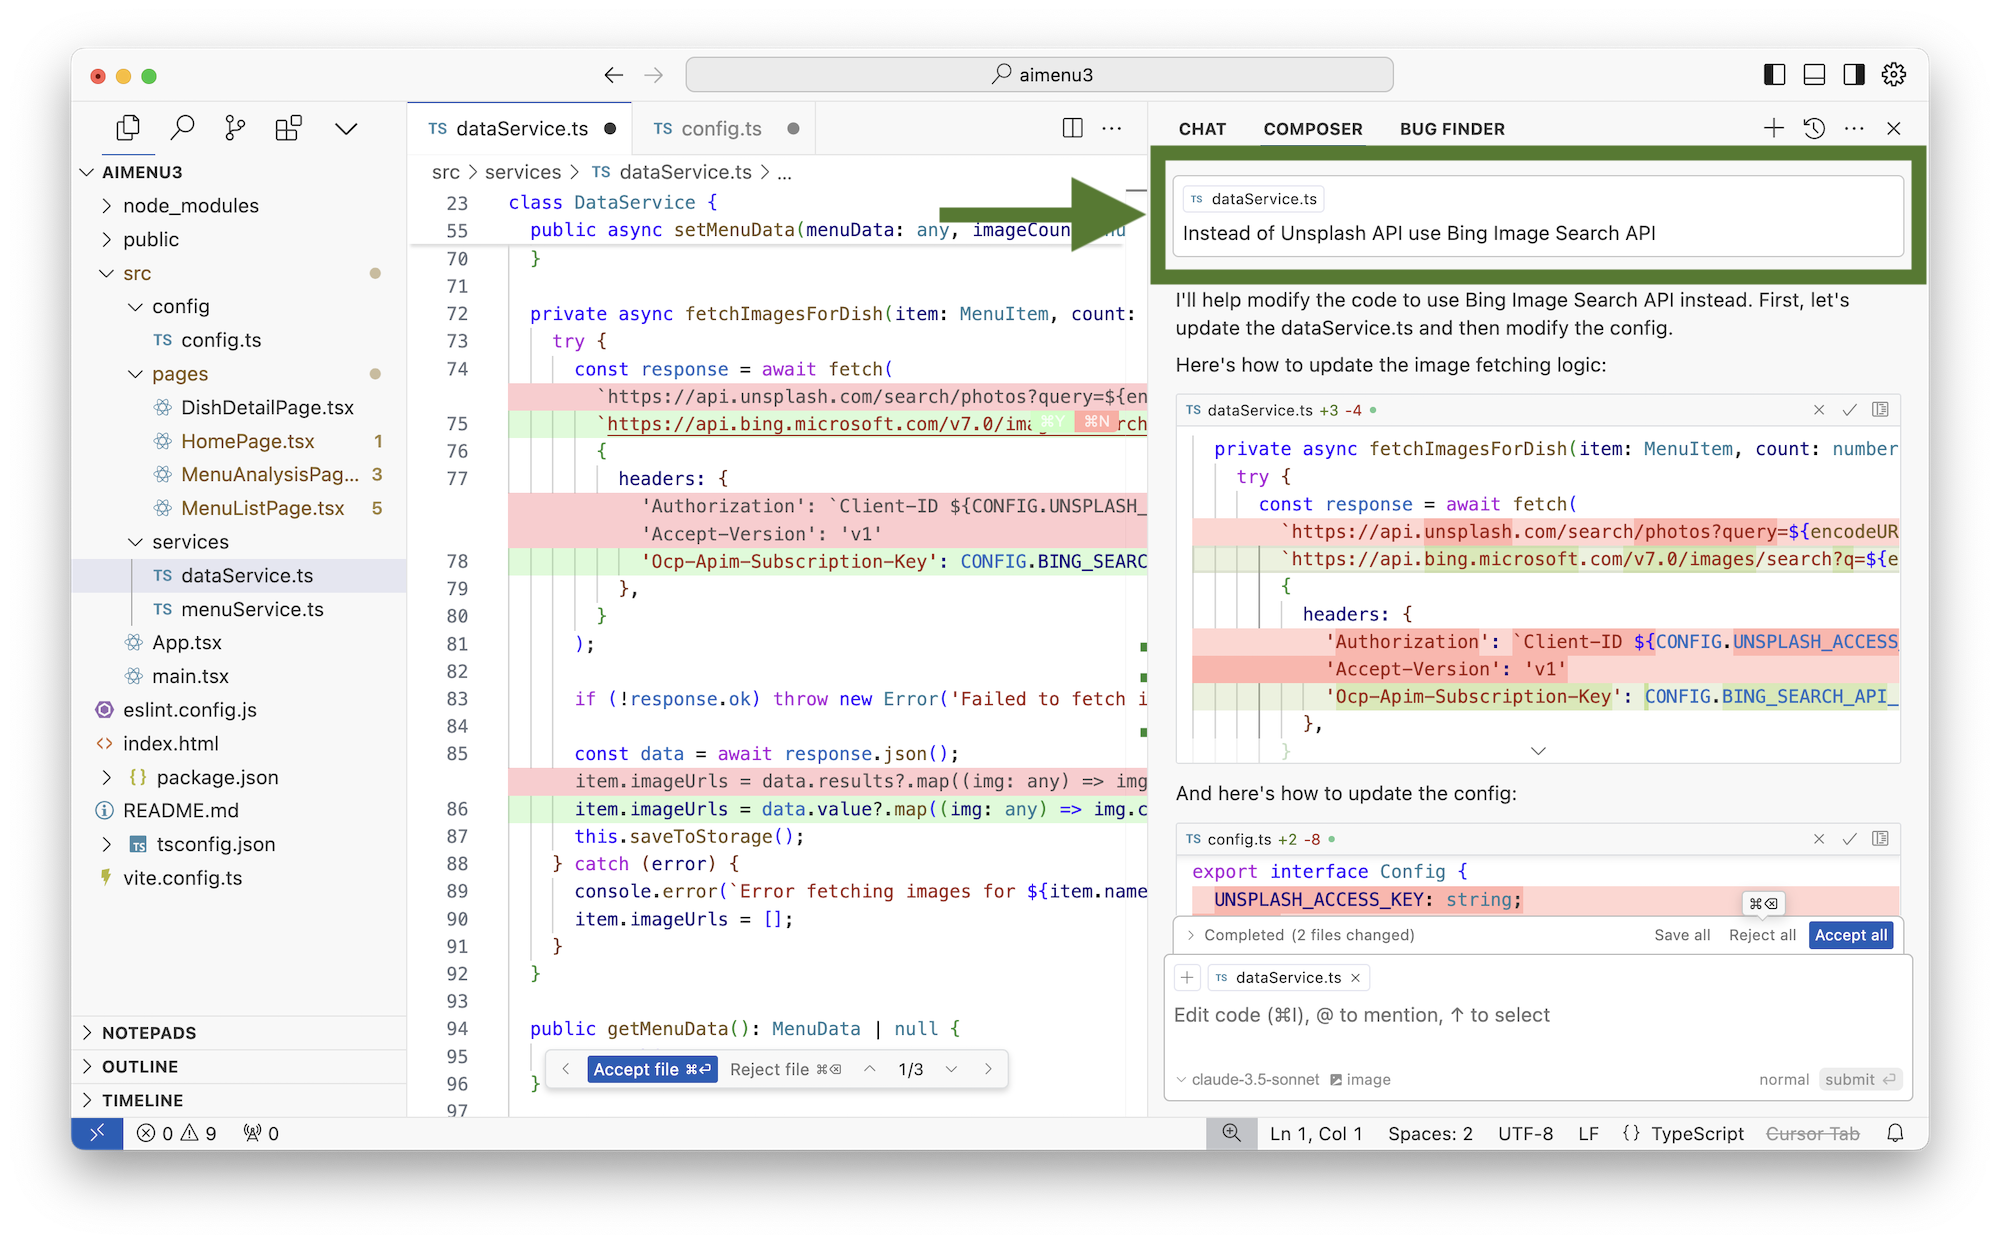
El código funciona, pero tenemos que conseguir una clave de la API de Bing Search. Para eso tuve que registrarme en Microsoft Azure, pasar por 8 círculos de verificación, meter los datos de todas mis tarjetas de crédito, subir una foto de mi perro, otra de mis calzoncillos sucios e hipotecar mi casa.
Ni con esas conseguí nada. Azure se caía sin más, soltaba errores al azar en la consola y ni siquiera me dejó crear una clave de prueba para la API de búsqueda de imágenes. No entendí nada. Por desgracia, con esto los LLM todavía no nos pueden ayudar. Un punto menos de vibra.
Olvidémoslo. Los de Microsoft han hecho una mierda, como siempre. La interfaz de Azure es repugnante.
Tiramos Bing a la basura y le pedimos a Cursor que lo reescriba todo para la API de Google. Google al menos no se cayó ni dio errores y me soltó una clave de prueba para 10 000 peticiones. Ya tenemos fotos.
Para ver cómo anda la vibra, vamos con un problema más sencillo.
Sí, quiero una app totalmente local-first y sin servidor propio. Pero para reconocer fotos con ChatGPT necesitamos una clave de OpenAI de algún sitio. No la vamos a dejar a la vista en el código.
Así que pensé que, para un prototipo gratuito, tampoco pasa nada por pedirle al usuario que introduzca su clave de ChatGPT. Que cada cual pague por lo que use de ChatGPT. Ya haremos luego una versión de pago con nuestra propia clave.
Le pido a Cursor que modifique la pantalla de análisis de la carta para que pida la clave de OpenAI y la guarde en el almacenamiento local para futuras peticiones.
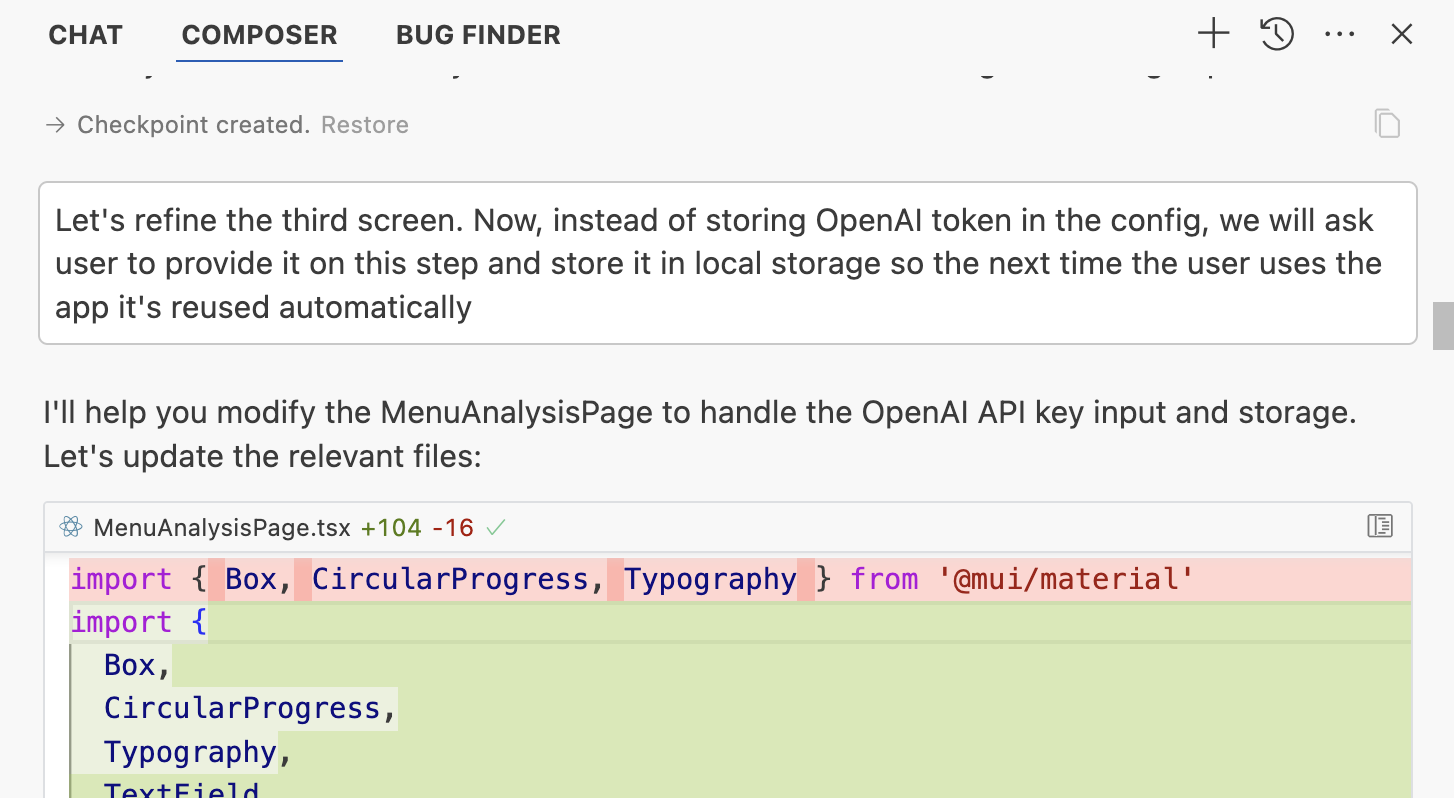
Aplicar, guardar, aplicar... ¡Sí, funciona! ¡Un punto de vibra!
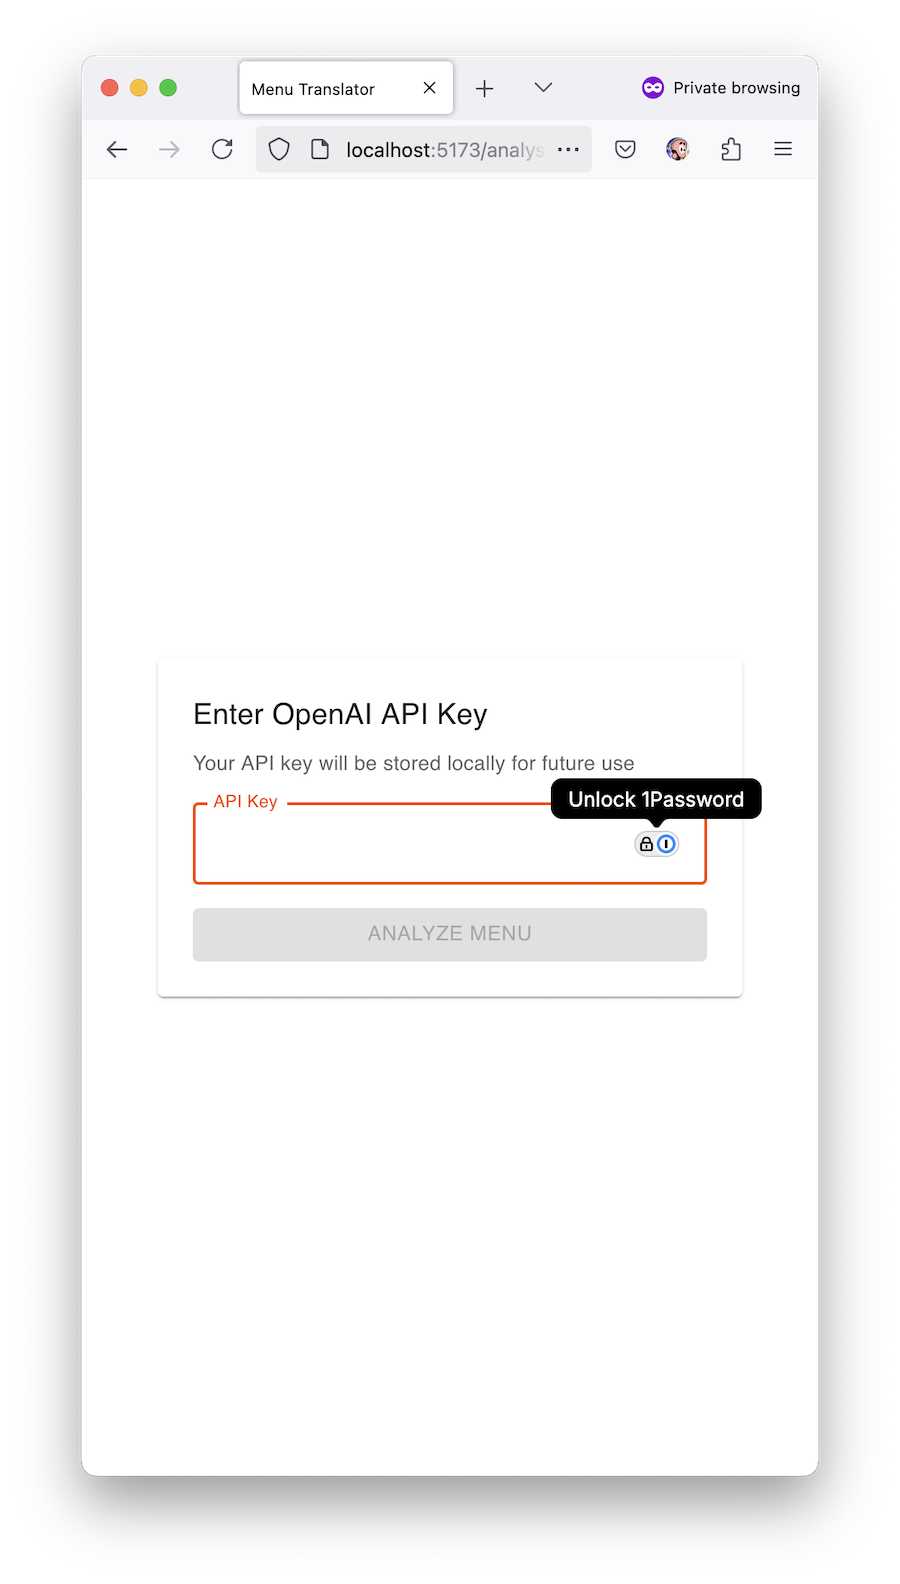
Pero todavía falta algo...
Después de subir la imagen, la pantalla se queda un buen rato en «Analizando imagen...». Mientras tanto, por detrás, ocurre un montón de magia: la imagen se convierte a base64, se envía a través de la API de OpenAI y vuelve un JSON larguísimo como respuesta.
El proceso tarda entre 20 y 30 segundos, y eso para el usuario es tristísimo. Puede aburrirse, caer en una depresión, irse a ver PornHub o afiliarse al Partido Verde. Y eso sí que resta vibra.
La solución de UX más sencilla: ¡mostrarle la foto que acaba de subir para que se quede mirándola y no se aburra!
Vamos a pedírselo:
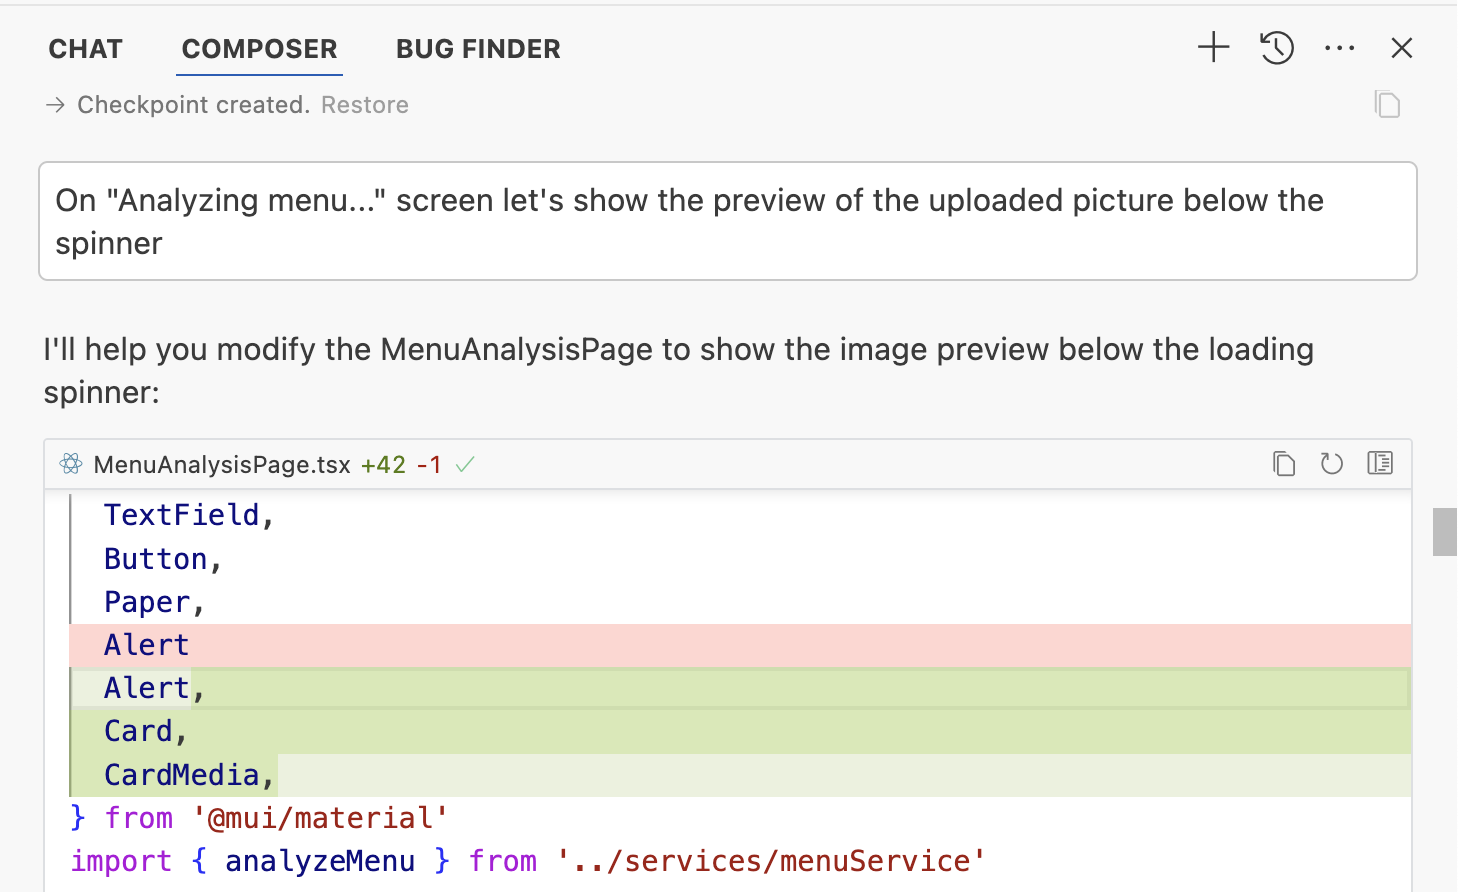
Ahora la pantalla de carga tiene algo más de gracia. Puedes mirar la foto recién sacada e intentar descifrar tú mismo los nombres mientras los LLM siguen ahí, sudando la gota gorda...
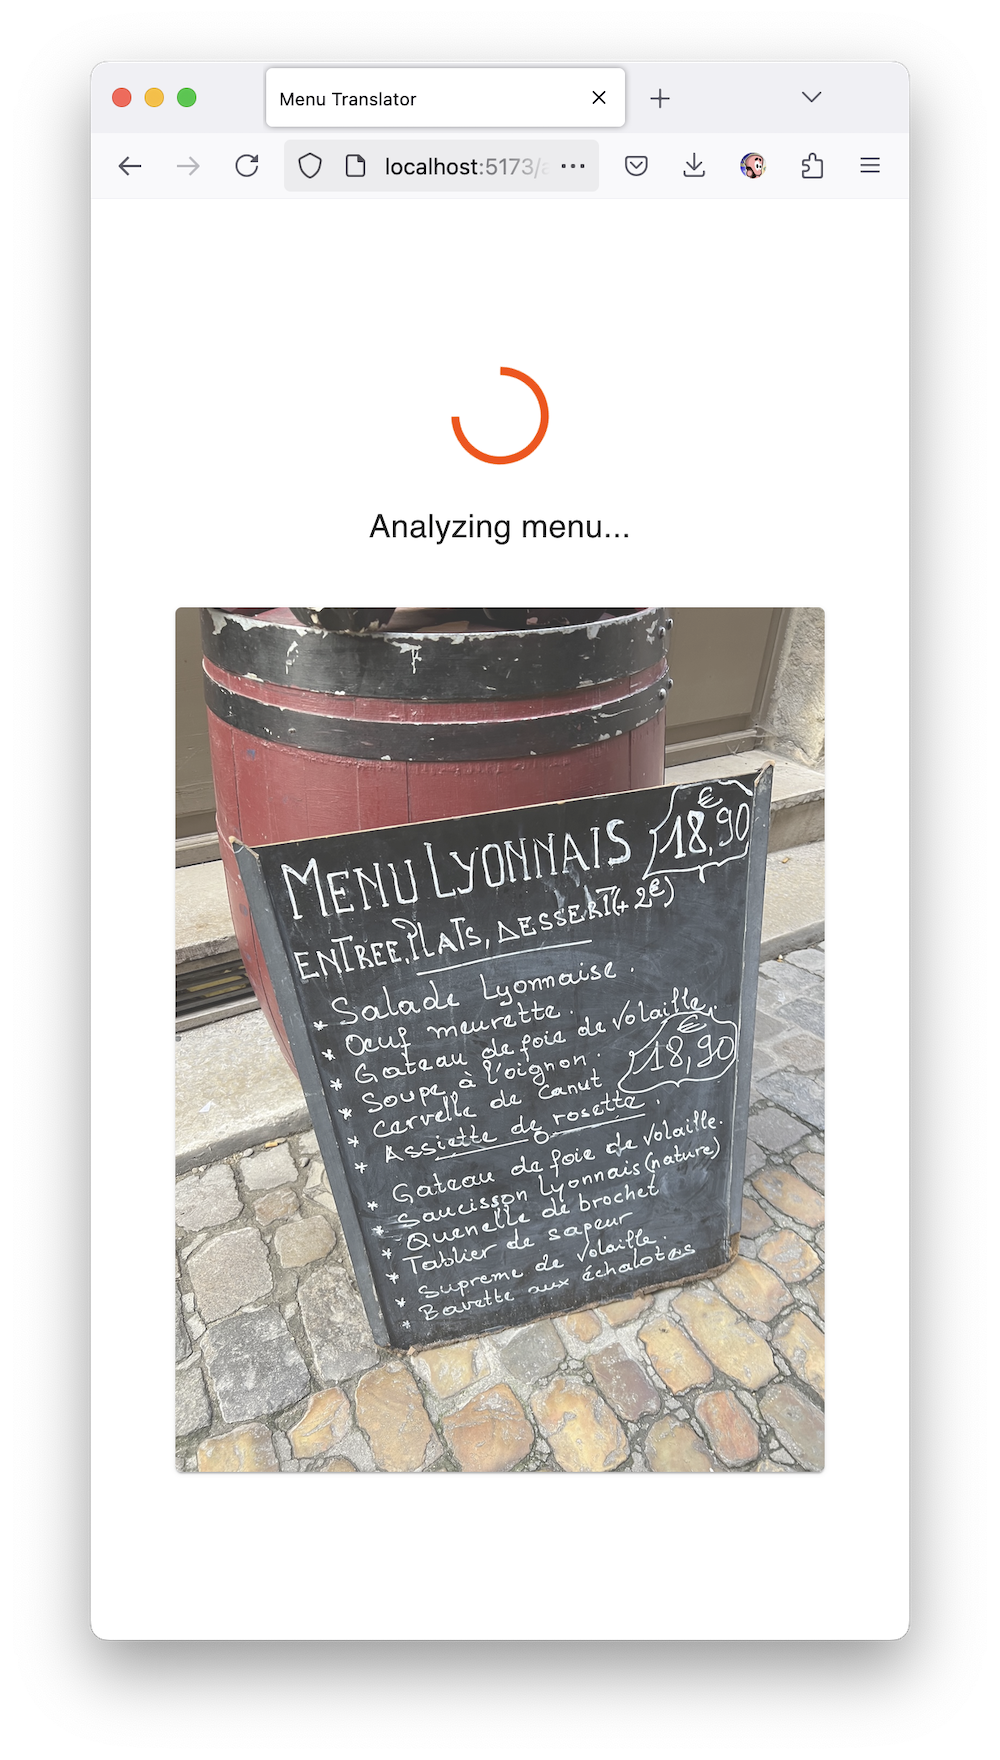
Dicho sea de paso: acabo de caer en que Francia es el único país de la UE que tiene su propia IA generativa. ¡Seguro que es porque ellos también la usan para leer sus cartas!
Bueno, contra todo pronóstico funciona, pero hay algo en nuestra nueva «startup» que no me acaba de convencer.
Probablemente porque es una mierda que hace daño a la vista. Parece que la hicieron unos informáticos.
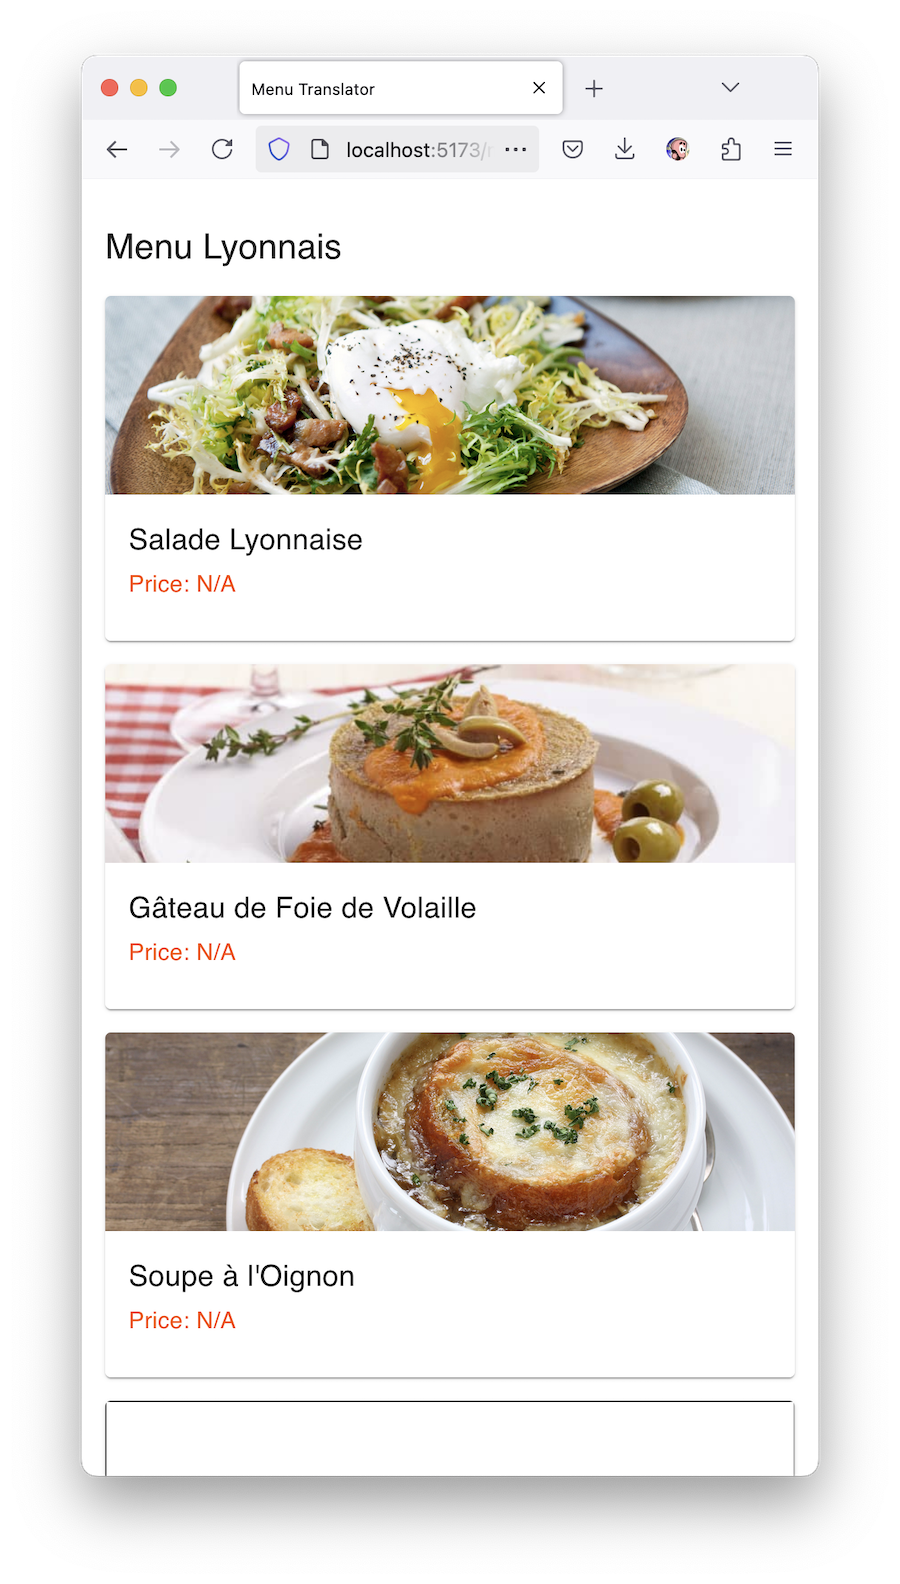
Sé por experiencia que MUI, tal como viene, tiene una pinta, digamos, austera. ¡Solo está esperando que le des un puñetazo en la cara un tema un poco más alegre!
Pero no tengo ni idea de qué temas están de moda, y si buscas «temas para Material UI» en Google te salen un montón de plantillas de pago a 66 dólares. Y darle dinero a los capitalistas resta vibra.
Así que recurrimos una vez más a la magia del LLM y le pedimos, sin más: «oye, la app tiene una pinta de mierda, ponle un tema de MUI bonito, moderno, que esté de moda». No te rías, funciona.
¡Vibra al mááááximo!
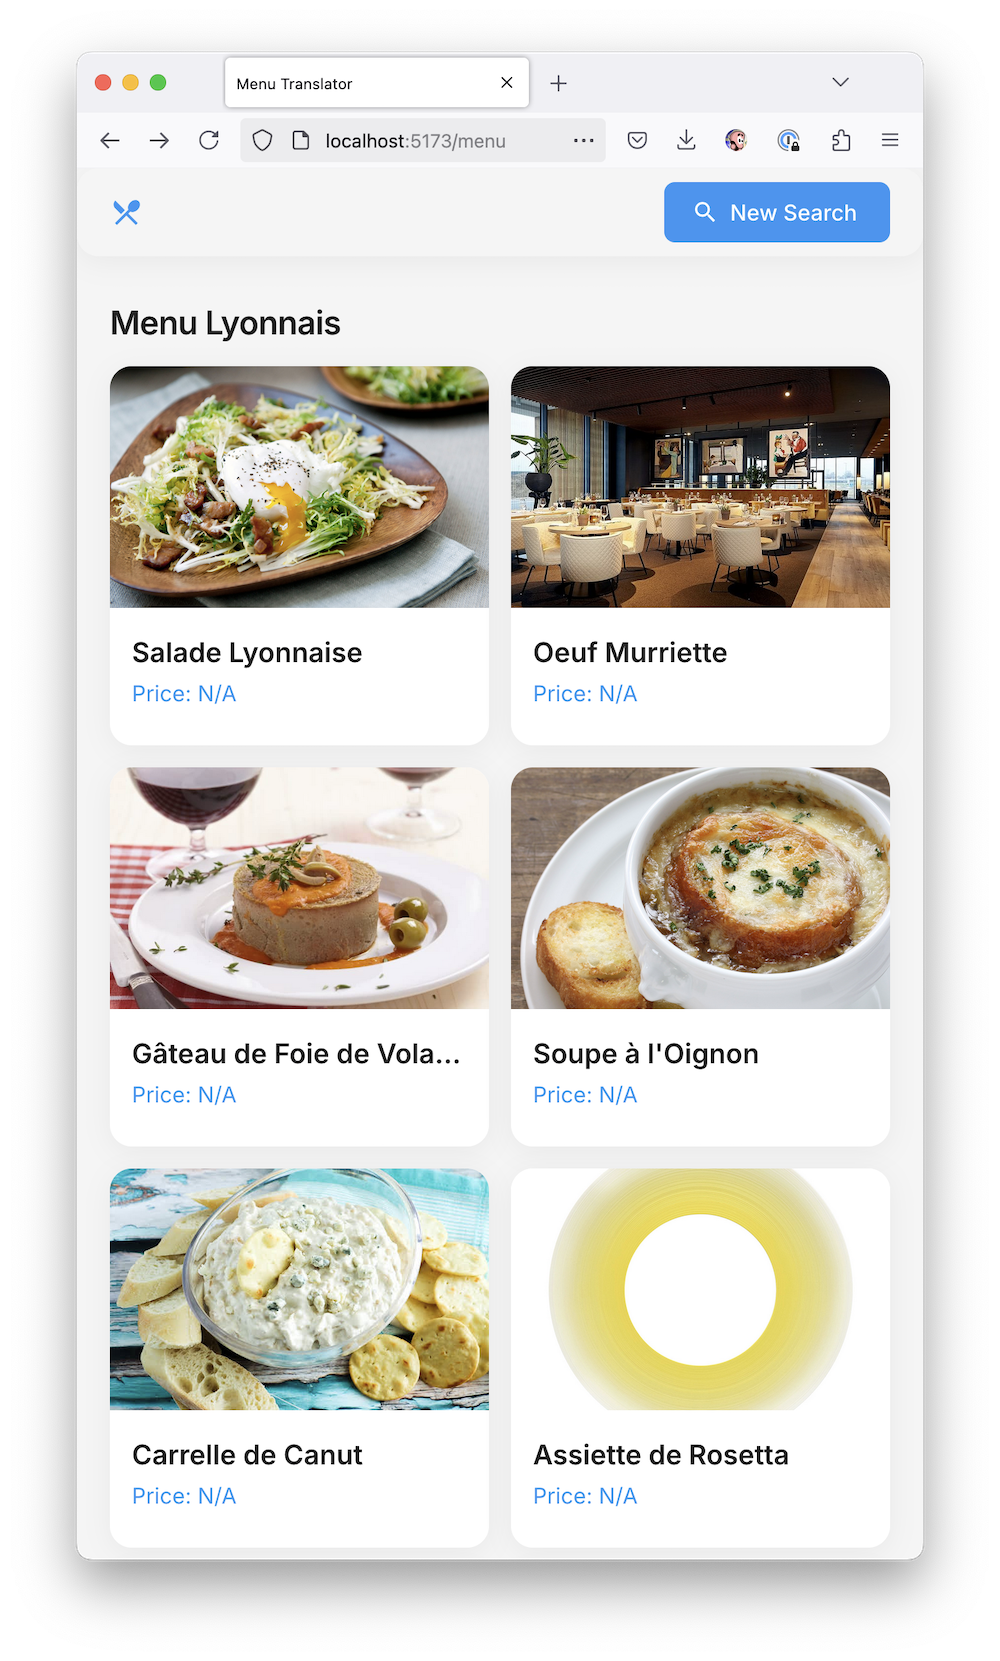
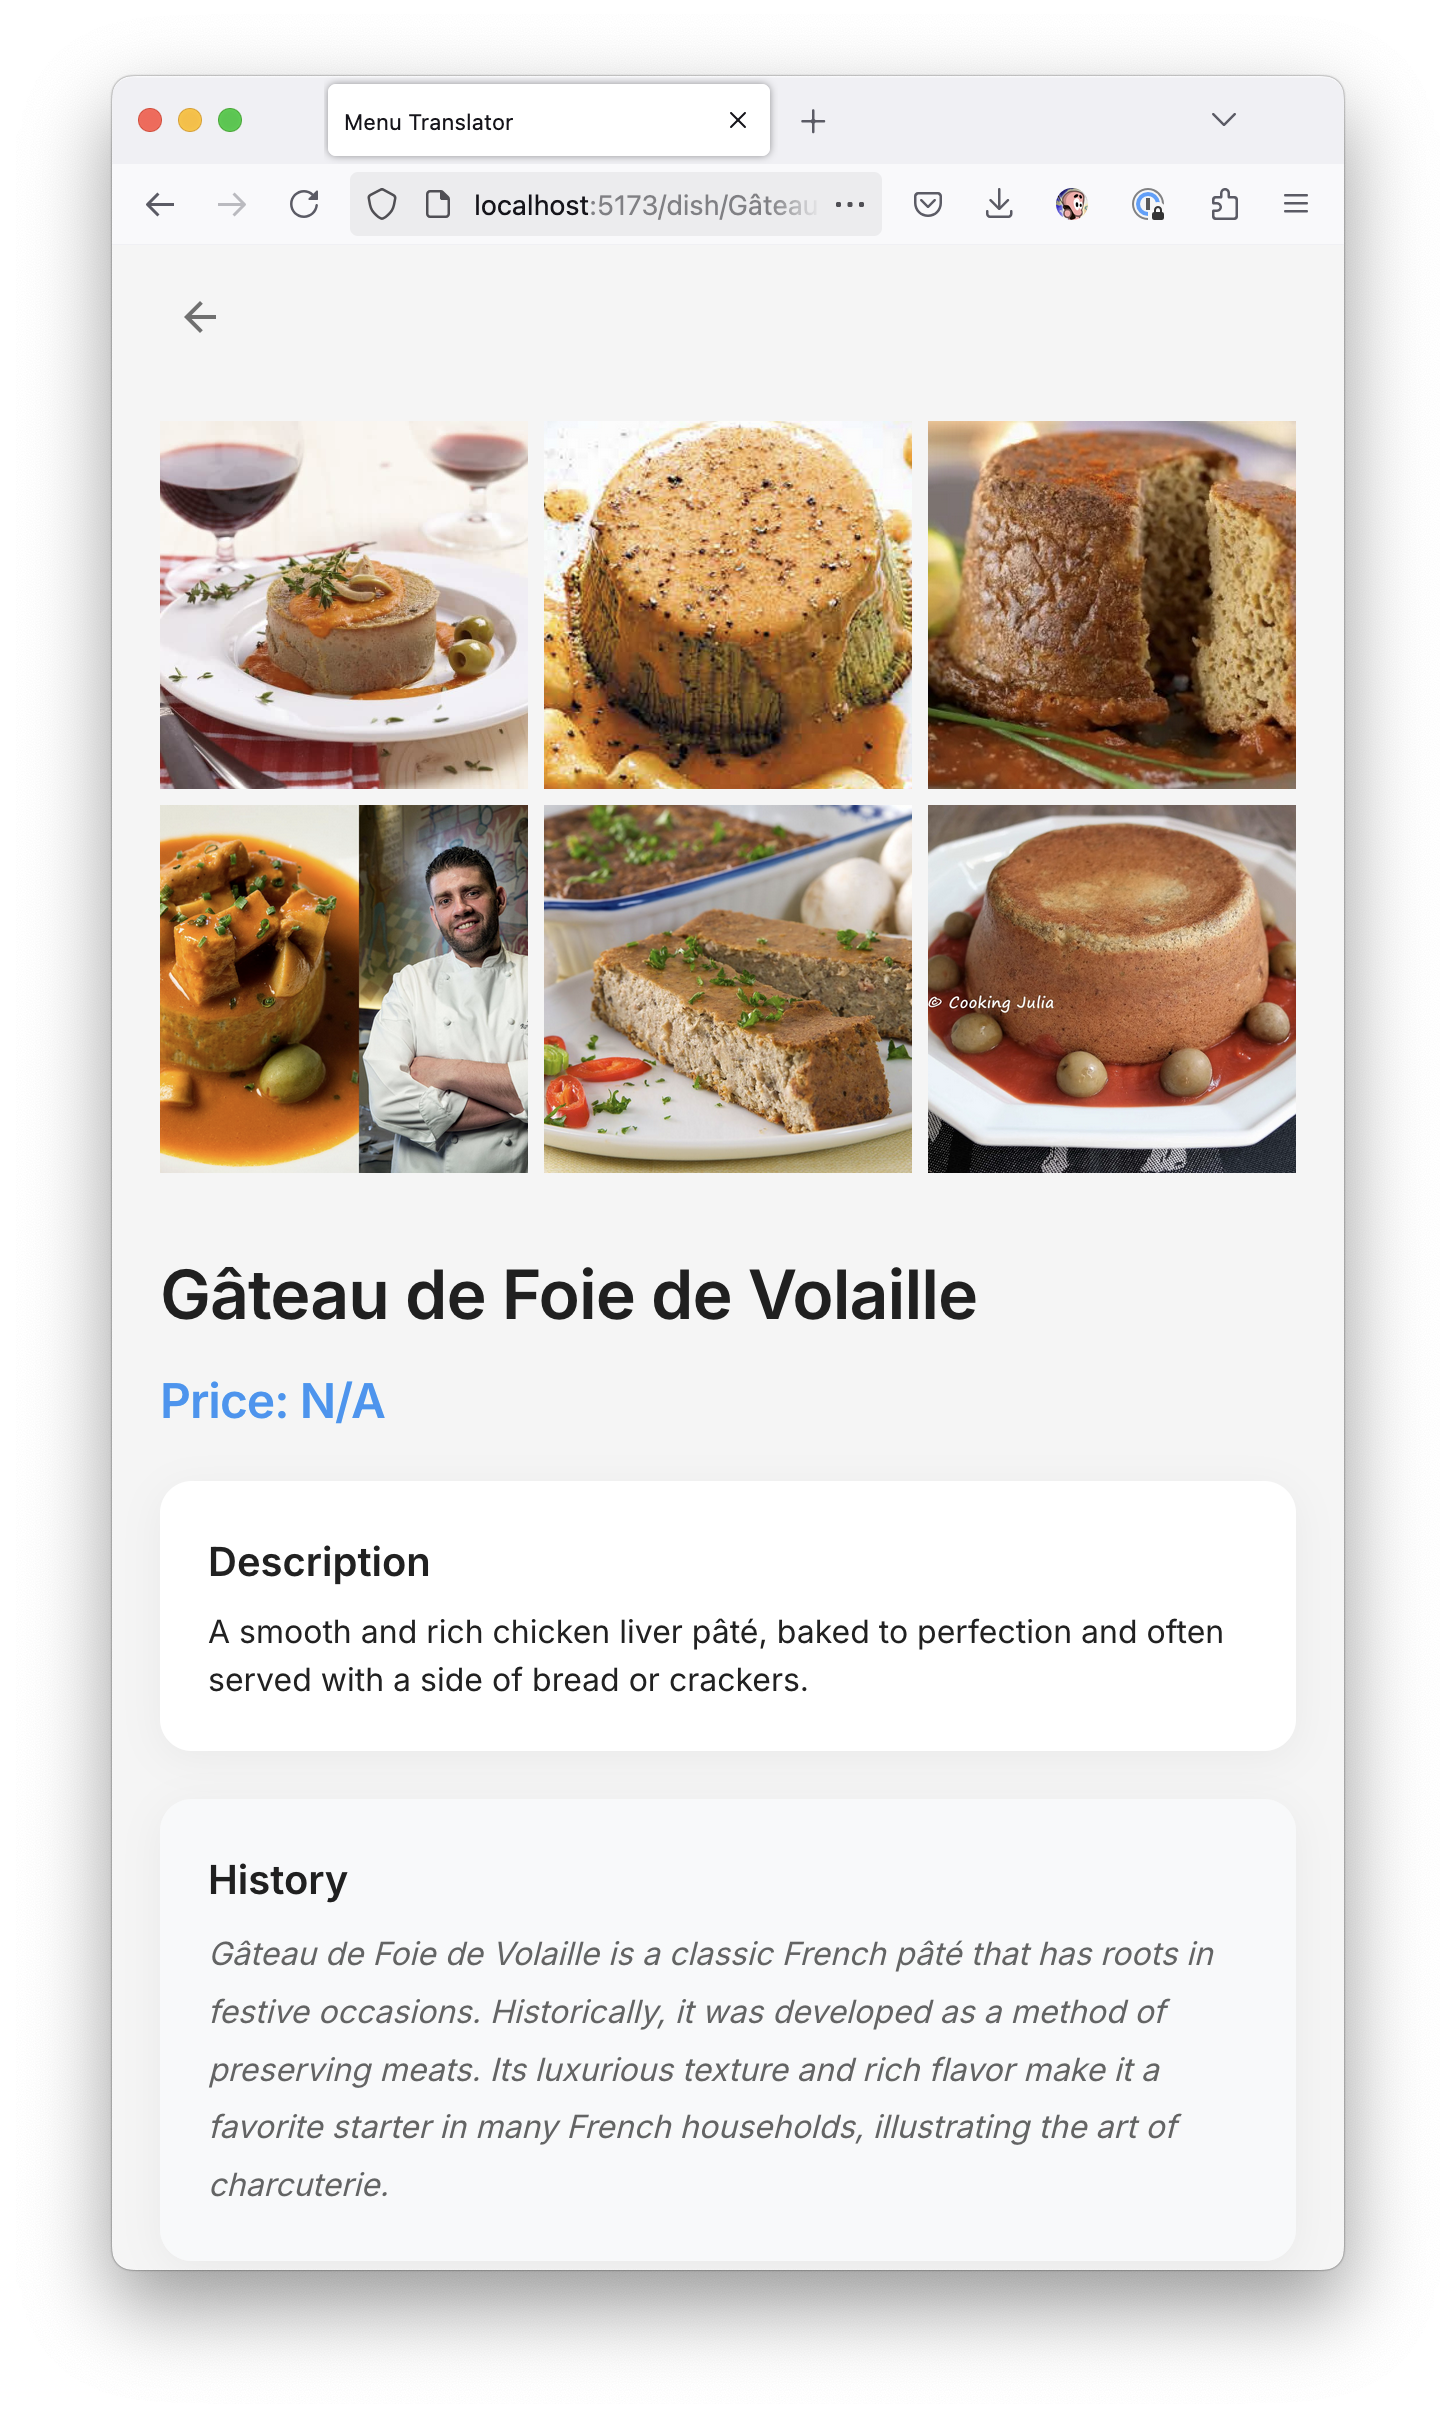
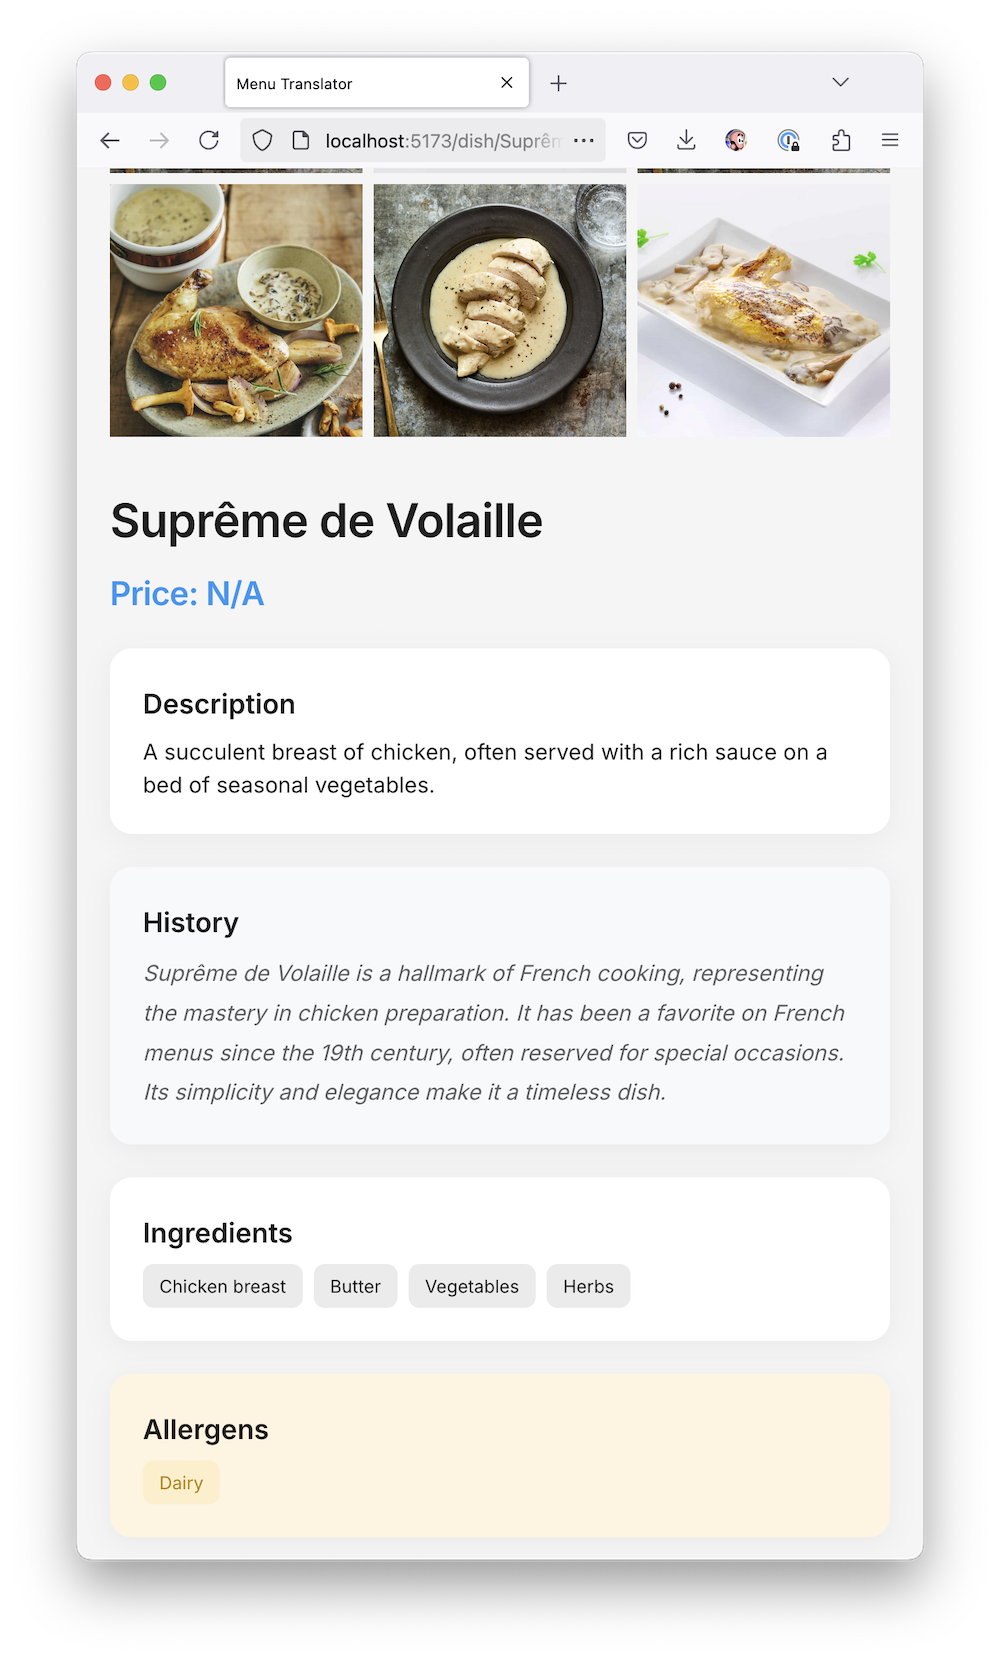
Funciona como el culo, ¡pero qué bonita es!
Aunque, mierda, un momento. Ha salido un error. Pero nos hemos dejado llevar tanto por la vibra que ya nos hemos tomado tres cervecitas. A estas alturas no estamos para investigar qué ha pasado: que trabaje por nosotros el botón «Arreglar con IA».

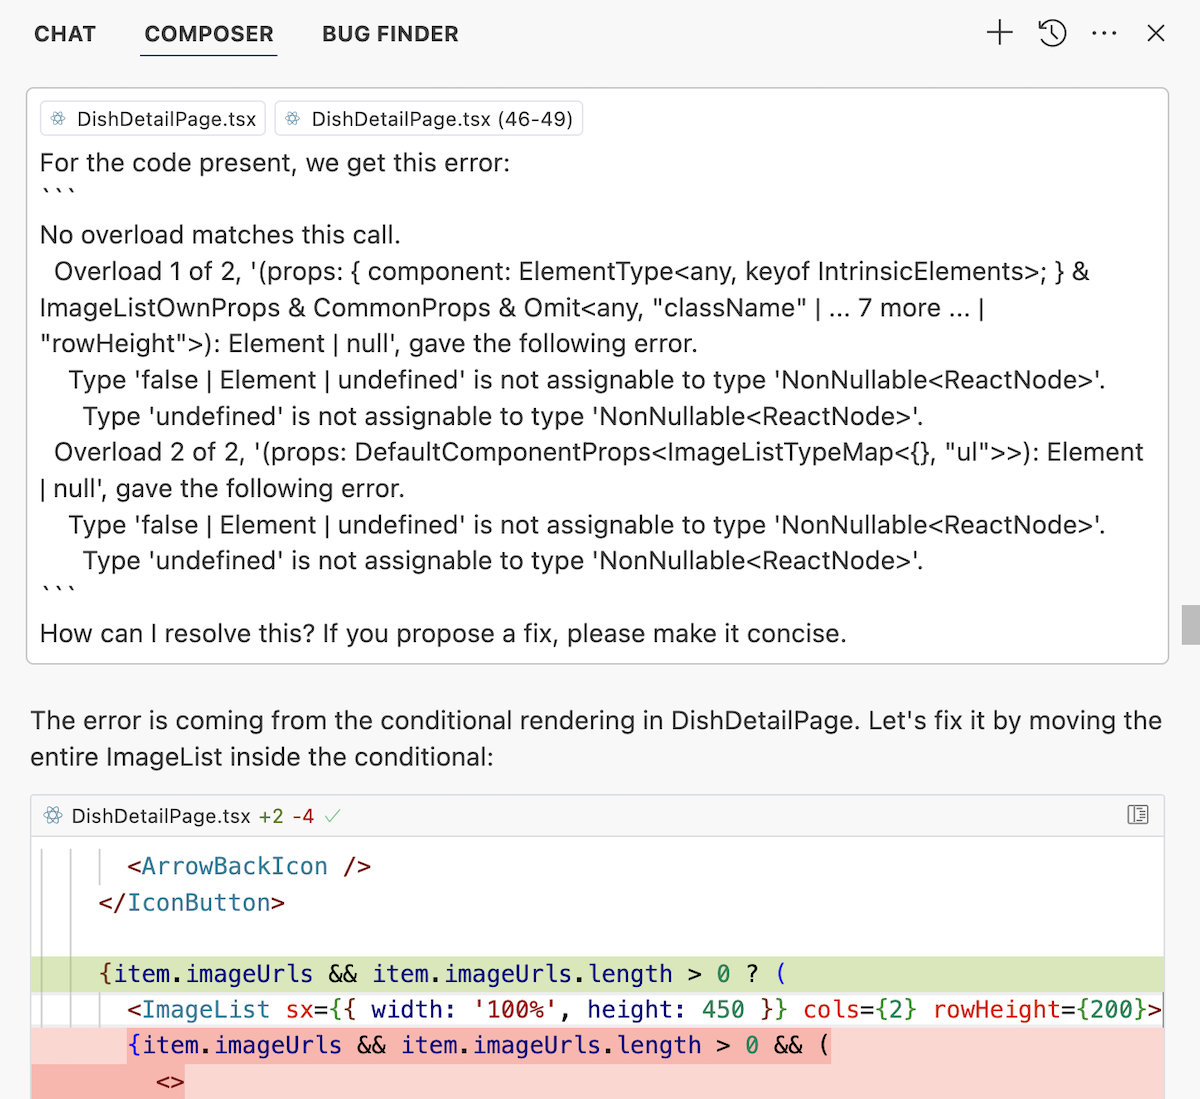
¡Ahora sí que es otra cosa!
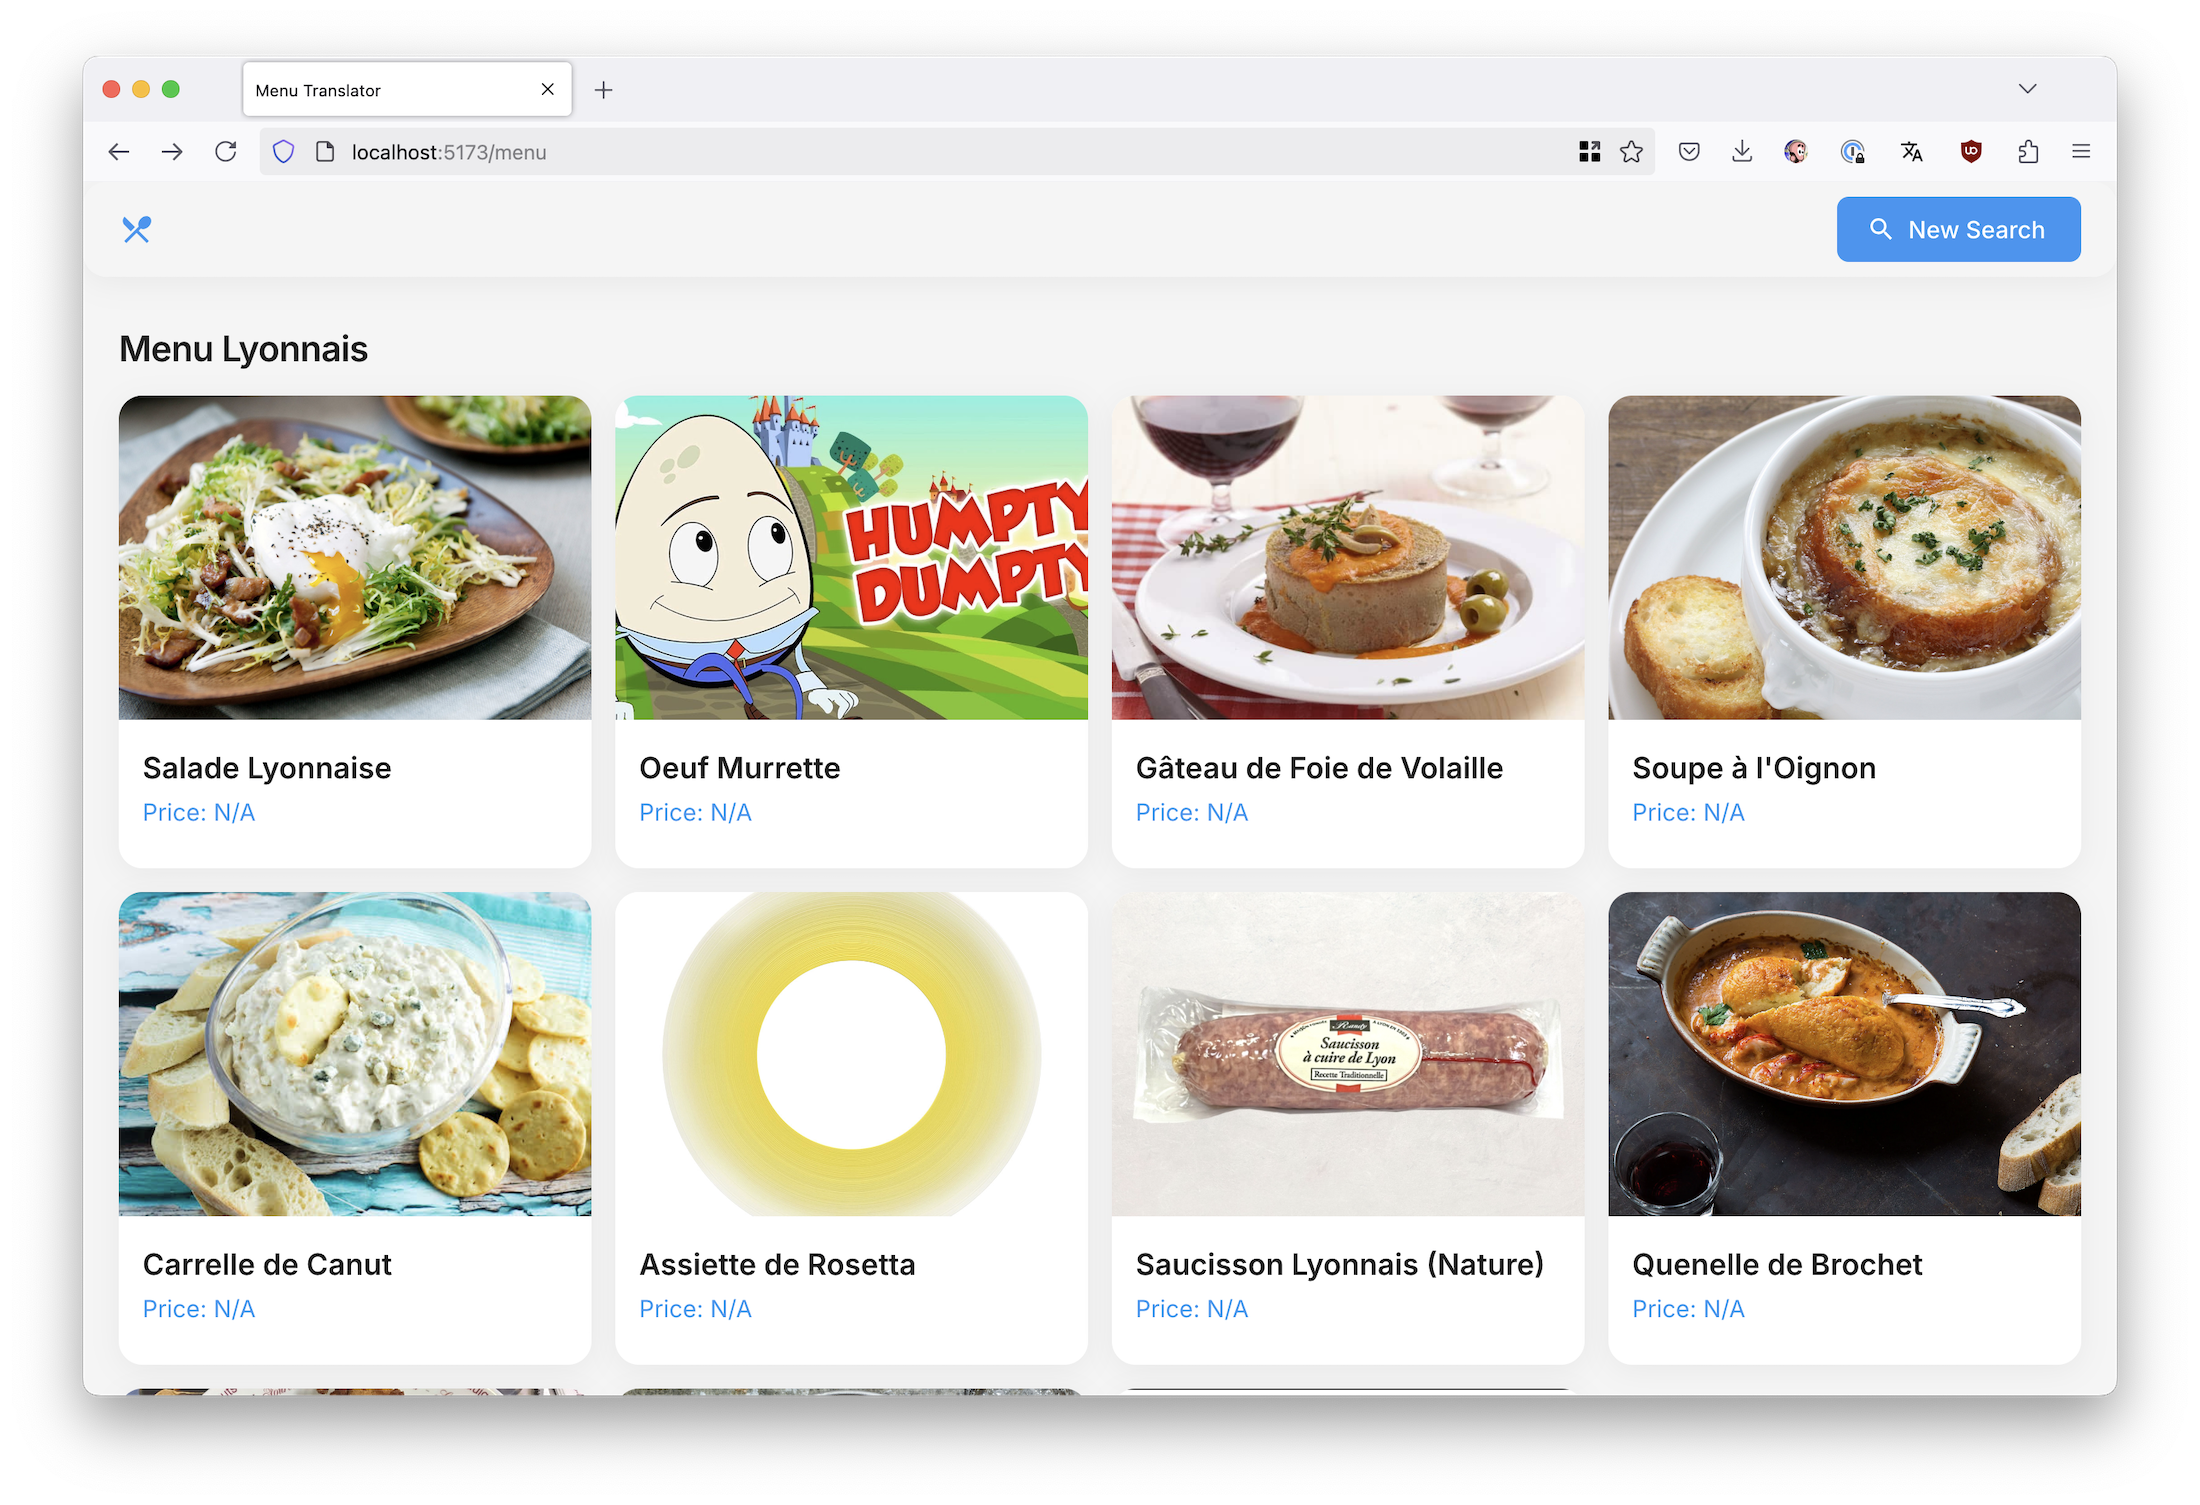
Nuestra «startup» está casi lista para subirla a GitHub y cosechar likes en Twitter. De verdad hace lo que yo quería: le das una foto y una clave de ChatGPT, analiza la carta, la divide en categorías, te muestra los platos con sus fotos y hasta te cuenta qué ingredientes llevan, qué historia tiene cada plato y qué alérgenos contiene.
Ya podríamos venderles una suscripción a los veganos o a la gente con alergias. O meternos de lleno en el B2B y generarles a los restaurantes cartas bonitas con fotos, hechas con IA, todos los días.
Pero queda un detallito por el que no puedo subir todo esto a GitHub Pages y darles una alegría a todos: la app sigue usando Google Image Search, que cuesta 5 dólares por cada 1000 peticiones.
Hasta me puse a investigarlo por separado con mis amigos imaginarios, los profesionales de ChatGPT Pro. Resulta que en el internet de hoy de verdad no existe una API abierta y gratuita para buscar imágenes.
Qué puta mierda.
No, en serio, piénsalo. Hemos aprendido a lanzar coches al espacio, a viajar en tren a 500 km/h, hemos inventado la inteligencia artificial, pero TODAVÍA no tenemos forma de encontrar gratis fotos de una tortilla con beicon buscando «tortilla con beicon». Google, Bing y compañía te piden 5 dólares por cada 1000 peticiones por semejante lujo.
1000 peticiones son de risa. En cuanto la carta tiene 100 o 200 platos, por cada foto que le sacas tienes que pagarle a Google UN dólar. Joder. Así no vamos a montar una startup. Un punto menos de vibra.

Solo en un par de horas de desarrollo me comí 2500 de mis 10 000 peticiones gratuitas. Y pedirle al usuario que traiga también una clave de la API de Google es una idea que nace muerta: yo mismo tardé horas en conseguir la mía.
Hasta intenté buscar otras soluciones. Probé a olvidarme de las fotos y generar imágenes de los platos con DALL-E, pero tiene unos límites draconianos: una sola imagen tarda unos veinte segundos, y generar la carta entera llevaría un par de horas y costaría varias decenas de dólares.
Intenté hacer web scraping en vez de usar una API, pero aquí no me ayudaron ni Sonnet ni ChatGPT: ningún buscador (ni el puto Pinterest) te deja extraer imágenes en condiciones a partir de una búsqueda.
Y en una startup lo más importante es lo visual. Por muy bien que descifres los garabatos de los dueños de restaurantes franceses, si no puedes enseñar fotos de sus platos, has perdido.
Pues yo también he perdido. ¡Chauuu!
El código sí lo voy a publicar, claro, pero no habrá demo: https://github.com/vas3k/stuff/tree/master/javascript/aimenu
Luego seguí jugando con mi nueva startup, pidiéndoles a Cursor y a Sonnet que la mejoraran más y más. Añadí un dataService que guardaba los datos en la caché del modelo, los almacenaba en Local Storage y hasta permitía consultar desde ahí el historial de escaneos.
Amplié el prompt para que ChatGPT también me contara la historia del plato, de qué región viene y cómo se come.
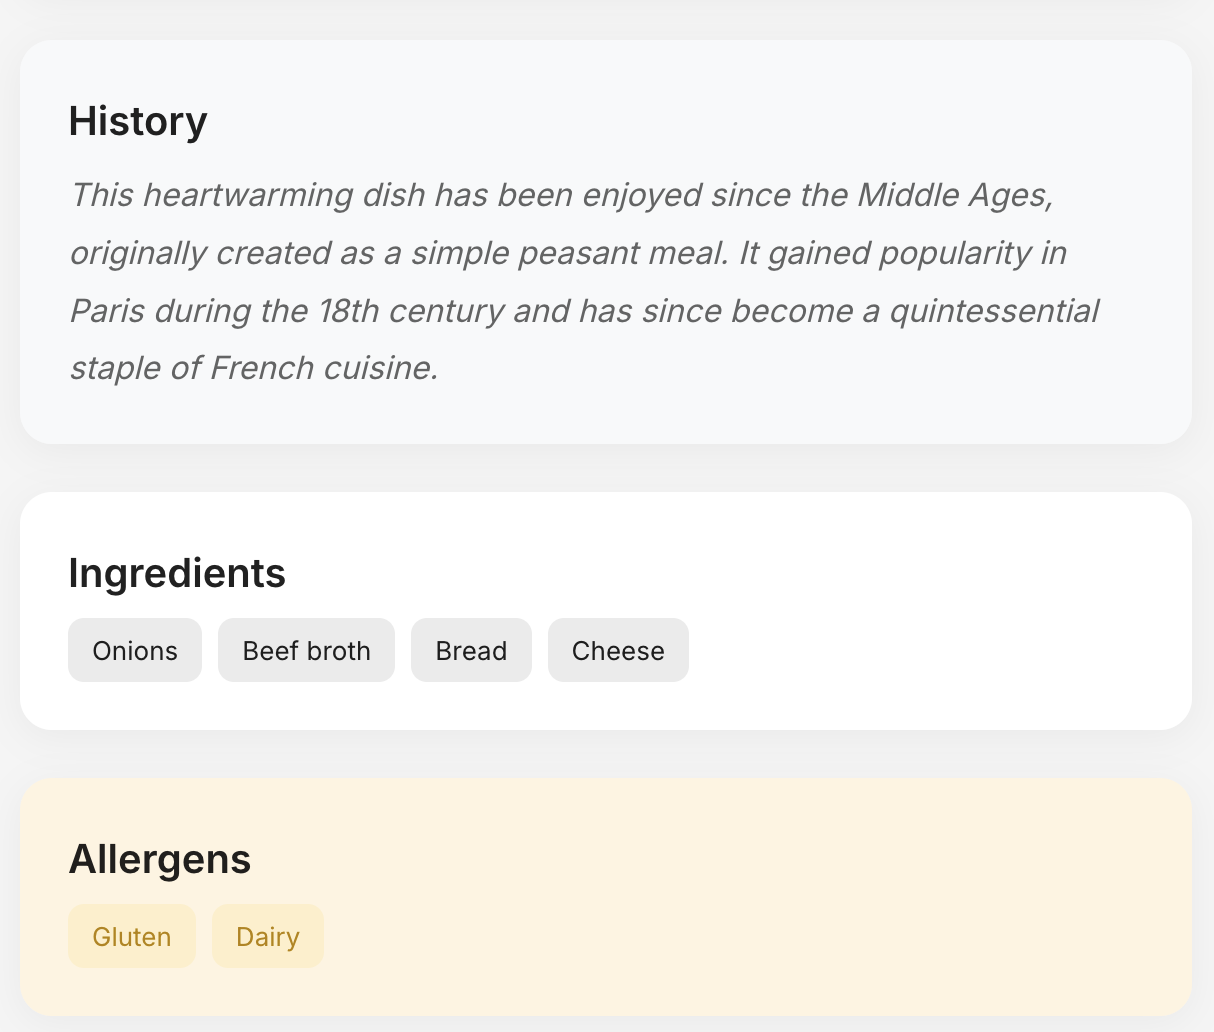
Intenté jugar un poco con las puntuaciones: le pedía a ChatGPT que puntuara cada plato de la carta según varios criterios para poder elegir el plato más interesante del restaurante. Pero salió una mierda y me olvidé de la idea.
A esas alturas ya se me había ido la vibra.
Lástima que nos quedáramos sin startup, ¡pero qué bien me lo pasé esa noche!
De todo esto saco tres conclusiones:
1. Cuanto más tiempo hablas con un LLM, peor código escribe.
Hace poco leí por ahí un estudio que decía que conviene «reiniciar» el chat con el LLM de vez en cuando, porque «se vuelve más tonto» a medida que crece el historial o el tamaño del contexto. Con el vibe coding se nota muchísimo: llega un momento en que estropea más código del que te ayuda a escribir.
Al principio bastan uno o dos retoques en el código generado para que todo funcione. Ahora, en cambio, cada vez te toca reescribir entre el 10 y el 20 % del código espagueti que te suelta el LLM.
En algún momento pasas de «mira todo lo que hago, con el LLM programo que da gusto» a «¿por qué demonios paso más tiempo corrigiendo sus errores que escribiendo código?».
Lo del LLM es, de verdad, programar con un júnior :)
2. Cuando un proyecto pasa de la fase de «prototipo», vuelve a ser más fácil trabajar «a la antigua».
Por un lado, los desarrolladores de Cursor han hecho un buen trabajo metiendo todo lo necesario en el contexto del LLM: dependencias, módulos vecinos, etc. Si quieres, puedes añadir cualquier otra cosa mencionando un archivo o una carpeta entera con «@». Así que, si hay algo que el modelo «no sabe», es que tú no sabes usarlo.
Por otro lado, el contexto del LLM sigue siendo limitado. Y por el punto anterior sabemos que el límite no es tanto técnico (los modelos actuales admiten bastantes tokens) como ese punto, que nunca es el mismo, en el que el modelo empieza por arte de magia a «volverse tonto».
Así que eso de «pintar a grandes trazos» desde el chat general va bien en proyectos pequeños (o en microservicios), pero en cuanto crecen lo suficiente para ser una app de producción, pasas más tiempo limpiando la basura del código del que habrías tardado en escribirlo desde cero.
Por eso, en proyectos medianos y grandes, cada vez uso menos el chat general y más la edición con el LLM dentro del propio archivo (lo de Cmd+K). Así voy aplicando los cambios poco a poco, con el control de cada paso.
Cosas como «reescribe esta función para que reciba los bytes en crudo en vez de un objeto de archivo» o «añade un indicador de carga a este componente de React». En fin, lo normal cuando programas con un LLM. Creo que a estas alturas ya lo hacemos todos.
Pero eso ya no es vibe coding.
3. Nos espera un montón de vibe code de mierda en producción.
Ahora se va a poner de moda el vibe coding y nos vamos a ahogar en una montaña de prototipos de mierda y commits espantosos en GitHub. Mi predicción: el término va a acabar teniendo muy mala fama y a los vibe coders los van a echar de los sitios respetables a trapo limpio. Con trapos meados.
Así que una cosa es divertirse en casa con prototipos y otra muy distinta es llevarse el vibe code a producción. Pero, como pasa con toda herramienta que se pone de moda, es inevitable.
Si al final decido terminar de darle forma a mi idea y convertirla en un servicio en producción, lo reescribiré todo desde cero. Con ayuda de la IA, claro, pero esta vez con todo el frontend y el backend bajo mi control.
Y con acceso de pago, ¡por supuesto! :3